
예제가 포함된 Hive 조인 및 하위 쿼리 튜토리얼
 데이비드 카터
⚡ 스마트 요약
Hive 조인은 일치하는 열을 기준으로 두 개 이상의 테이블의 행을 결합하고, 서브쿼리는 하나의 쿼리 안에 다른 쿼리를 중첩합니다. 따라서 여기서는 일반 텍스트 파일에서 로드한 두 개의 샘플 테이블을 사용하여 두 가지 모두를 설명합니다.

쿼리 결합
조인 쿼리는 두 테이블에 대해 수행할 수 있습니다. 하이브조인 개념을 명확하게 이해하기 위해 여기에 두 개의 테이블을 생성하겠습니다.
- 샘플 조인(고객 세부 정보 관련)
- sample_joins1 (직원이 주문한 세부 정보와 관련됨)
단계 1) 직원들의 ID, 이름, 나이, 주소, 급여를 열 이름으로 하는 "sample_joins" 테이블을 생성합니다. 아래 스크린샷은 CREATE TABLE 문과 그 확인 메시지를 보여줍니다.

단계 2) 데이터를 불러와 표시하는 방법입니다. 다음 스크린샷은 로드 명령과 그 뒤에 나오는 테이블 내용을 보여줍니다.
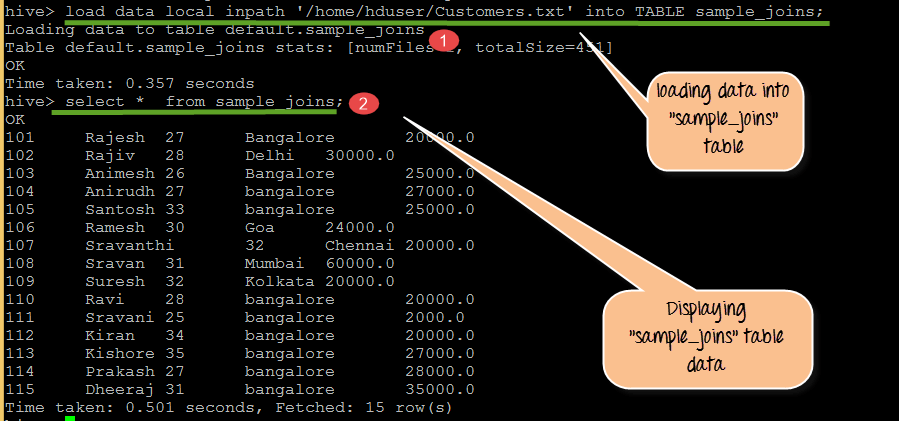
위 스크린샷에서:
- Customers.txt에서 Sample_joins로 데이터 로드
- Sample_joins 테이블 내용 표시
단계 3) 아래 스크린샷과 같이 sample_joins1 테이블을 생성한 다음 데이터를 로드하고 표시합니다.

위 스크린샷에서 다음과 같은 사실을 확인할 수 있습니다.
- Orderid, Date1, Id, Amount 열을 가진 sample_joins1 테이블 생성
- Orders.txt에서 Sample_joins1로 데이터 로드
- Sample_joins1에 있는 레코드 표시
앞으로 우리는 생성한 테이블에서 수행할 수 있는 다양한 유형의 조인을 살펴보겠습니다. 그 전에 조인에 대해 다음 사항들을 고려해야 합니다.
조인 시 유의해야 할 몇 가지 사항:
- 조인에서는 등가 조인만 허용됩니다.
- 동일한 쿼리에서 두 개 이상의 테이블을 조인할 수 있습니다.
- LEFT, RIGHT 및 FULL OUTER 조인은 일치하는 항목이 없는 ON 절에 대한 더 많은 제어 기능을 제공하기 위해 존재합니다.
- 조인은 교환법칙이 성립하지 않습니다.
- 조인은 LEFT 조인인지 RIGHT 조인인지에 관계없이 왼쪽 결합입니다.
동일성 조건은 과거 Hive의 구조를 반영합니다. Hive 2.2.0 버전부터는 ON 절에서 복잡한 표현식이 지원되므로(HIVE-15211), 현재 버전에서는 동일성이 아닌 조건도 허용됩니다. 이전 버전에서는 동일성 조건만 사용해야 하며, 그 외의 조건은 WHERE 절로 이동해야 합니다.
다양한 유형의 조인
조인에는 4가지 유형이 있습니다. 다음과 같습니다.
- 내부 조인
- 왼쪽 외부 조인
- 오른쪽 외부 결합
- 전체 외부 조인
각 유형은 아래의 두 테이블을 사용하여 설명되므로 예제 간의 유일한 차이점은 일치하지 않는 행 중 어떤 행이 남는지입니다.
내부 조인
이 내부 조인을 통해 두 테이블에 공통으로 존재하는 레코드가 검색됩니다. 아래 스크린샷에는 주문 내역이 일치하는 고객만 표시됩니다.

위 스크린샷에서 다음과 같은 사실을 확인할 수 있습니다.
- 여기서는 JOIN 키워드를 사용하여 sample_joins 테이블과 sample_joins1 테이블 간에 (c.Id = o.Id) 일치 조건을 적용한 조인 쿼리를 수행합니다.
- 출력 결과에는 쿼리에 명시된 조건을 확인하여 선택된, 두 테이블 모두에 공통으로 존재하는 레코드가 표시됩니다.
검색어 :
SELECT c.Id, c.Name, c.Age, o.Amount FROM sample_joins c JOIN sample_joins1 o ON(c.Id=o.Id);
왼쪽 외부 결합
- 하이브QL LEFT OUTER JOIN은 오른쪽 테이블에 일치하는 항목이 없더라도 왼쪽 테이블의 모든 행을 반환합니다.
- ON 절에서 오른쪽 테이블에 일치하는 레코드가 없더라도 조인 결과에는 오른쪽 테이블의 각 열에 NULL 값이 포함된 레코드가 반환됩니다.
아래 스크린샷은 주문이 없는 고객을 포함하여 모든 고객이 표시되는 것을 보여줍니다.

위 스크린샷에서 다음과 같은 사실을 확인할 수 있습니다.
- 여기서는 `LEFT OUTER JOIN` 키워드를 사용하여 `sample_joins` 테이블과 `sample_joins1` 테이블을 조인하고, 일치 조건(`c.Id = o.Id`)을 적용합니다. 예를 들어, 여기서는 직원 ID를 기준으로 삼아, 해당 ID가 왼쪽 테이블과 오른쪽 테이블 모두에 존재하는지 확인합니다. 이것이 일치 조건의 역할을 합니다.
- 위 출력은 쿼리에 명시된 조건에 따라 선택된 레코드를 보여줍니다. 위 출력에서 NULL 값은 오른쪽 테이블(즉, sample_joins1)에서 값이 없는 열을 나타냅니다.
검색어 :
SELECT c.Id, c.Name, o.Amount, o.Date1 FROM sample_joins c LEFT OUTER JOIN sample_joins1 o ON(c.Id=o.Id)
오른쪽 외부 결합
- HiveQL의 RIGHT OUTER JOIN은 왼쪽 테이블에 일치하는 항목이 없더라도 오른쪽 테이블의 모든 행을 반환합니다.
- ON 절이 왼쪽 테이블에서 일치하는 레코드가 없는 경우에도 조인 결과에는 왼쪽 테이블의 각 열에 NULL 값이 포함된 레코드가 반환됩니다.
- 오른쪽 조인은 항상 오른쪽 테이블의 레코드와 왼쪽 테이블에서 일치하는 레코드를 반환합니다. 왼쪽 테이블에 해당 열에 대응하는 값이 없는 경우 해당 위치에 NULL 값을 반환합니다.
아래 스크린샷은 이전 결과의 반전된 모습입니다. 일치 여부와 관계없이 모든 주문이 표시됩니다.

위 스크린샷에서 다음과 같은 사실을 확인할 수 있습니다.
- 여기서는 "RIGHT OUTER JOIN" 키워드를 사용하여 sample_joins 테이블과 sample_joins1 테이블 간에 (c.Id = o.Id) 일치 조건을 적용한 조인 쿼리를 수행합니다.
- 출력 결과에는 쿼리에 언급된 조건을 확인하여 선택된 레코드가 표시됩니다.
검색어 :
SELECT c.Id, c.Name, o.Amount, o.Date1 FROM sample_joins c RIGHT OUTER JOIN sample_joins1 o ON(c.Id=o.Id)
전체 외부 결합
이 기능은 쿼리에 지정된 JOIN 조건을 기반으로 sample_joins 테이블과 sample_joins1 테이블의 레코드를 결합합니다.
이 함수는 두 테이블의 모든 레코드를 반환하고, 아래 스크린샷에서 볼 수 있듯이 양쪽 테이블 중 어느 한쪽에서 일치하는 값이 없는 열에 NULL 값을 채웁니다.

위 스크린샷에서 다음과 같은 사실을 확인할 수 있습니다.
- 여기서는 "FULL OUTER JOIN" 키워드를 사용하여 sample_joins 테이블과 sample_joins1 테이블 간에 일치 조건(c.Id = o.Id)으로 조인 쿼리를 수행합니다.
- 출력 결과는 쿼리에 명시된 조건을 만족하는 두 테이블의 모든 레코드를 보여줍니다. 출력 결과에서 NULL 값은 두 테이블의 해당 열에 누락된 값을 나타냅니다.
검색어 :
SELECT c.Id, c.Name, o.Amount, o.Date1 FROM sample_joins c FULL OUTER JOIN sample_joins1 o ON(c.Id=o.Id)
하위 쿼리
조인은 테이블을 나란히 배치합니다. 서브쿼리는 이와는 다른 역할을 합니다. 서브쿼리는 하나의 쿼리를 다른 쿼리 안에 중첩하여, 바깥쪽 쿼리가 이미 계산된 결과를 활용할 수 있도록 합니다.
쿼리 안에 포함된 쿼리를 서브쿼리라고 합니다. 메인 쿼리는 서브쿼리가 반환하는 값에 따라 달라집니다.
서브쿼리는 두 가지 유형으로 분류할 수 있습니다.
- FROM 절의 서브쿼리
- WHERE 절의 서브쿼리
사용시기 :
- 서로 다른 테이블의 두 열 값에서 결합된 특정 값을 얻으려면
- 한 테이블의 값이 다른 테이블의 값에 의존하는 관계
- 한 열의 값을 다른 테이블의 값과 비교 검사
구문 :
Subquery in FROM clause
SELECT <column names 1, 2…n>From (SubQuery) <TableName_Main >
Subquery in WHERE clause
SELECT <column names 1, 2…n> From<TableName_Main>WHERE col1 IN (SubQuery);
예:
SELECT col1 FROM (SELECT a+b AS col1 FROM t1) t2
여기서 t1과 t2는 테이블 이름입니다. 내부 문장은 테이블 t1에 대해 실행되는 서브쿼리입니다. a와 b는 서브쿼리에 추가되어 col1에 할당되는 열입니다. col1은 메인 테이블의 해당 열 값입니다. 서브쿼리에 있는 "col1" 열은 메인 테이블 쿼리의 col1 열 값과 동일합니다.
사용자 정의 스크립트 포함
하위 쿼리가 HiveQL만으로 데이터를 재구성하는 경우, 내장 스크립트는 행을 Hive 외부에서 작성된 코드로 전달합니다.
Hive를 사용하면 클라이언트 요구 사항에 맞는 사용자 지정 스크립트를 작성할 수 있습니다. 사용자는 이러한 요구 사항에 맞는 맵 및 리듀스 스크립트를 직접 작성할 수 있습니다. 이러한 스크립트를 임베디드 사용자 지정 스크립트라고 합니다. 코딩 로직은 사용자 지정 스크립트에 정의되며, ETL 시점에 해당 스크립트를 사용할 수 있습니다.
내장 스크립트를 선택해야 하는 경우:
- 클라이언트별 요구 사항으로 인해 개발자가 Hive에서 스크립트를 작성하고 배포해야 하는 경우
- Hive 내장 함수가 특정 도메인 요구 사항에 적합하지 않은 경우
이를 위해 Hive는 TRANSFORM 절을 사용하여 맵 스크립트와 리듀서 스크립트를 모두 포함합니다.
이러한 내장형 사용자 지정 스크립트에서는 다음 사항을 준수해야 합니다.
- 각 열은 문자열로 변환되고 탭으로 구분된 후 사용자 스크립트에 전달됩니다.
- 사용자 스크립트의 표준 출력은 탭으로 구분된 문자열 열로 처리됩니다.
내장 스크립트 예시:
FROM (
	FROM pv_users
	MAP pv_users.userid, pv_users.date
	USING 'map_script'
	AS dt, uid
	CLUSTER BY dt) map_output

INSERT OVERWRITE TABLE pv_users_reduced
	REDUCE map_output.dt, map_output.uid
	USING 'reduce_script'
	AS date, count;
위 스크립트에서 다음과 같은 점을 확인할 수 있습니다. 이는 이해를 돕기 위한 예시 스크립트일 뿐입니다.
- pv_users는 사용자 테이블이며, map_script에 언급된 것처럼 userid와 date와 같은 필드를 포함합니다.
- 리듀서 스크립트는 pv_users 테이블의 날짜와 개수를 기반으로 정의됩니다.
