
예시를 사용한 탐욕 알고리즘: 정의, 방법 및 접근 방식
 사라 첸
⚡ 스마트 요약
탐욕 알고리즘은 재귀, 순서가 지정된 자원, 그리고 정지 조건을 사용하여 각 단계에서 최적의 로컬 선택을 함으로써 최적의 솔루션을 구축하도록 설계되었으며, 이를 통해 스케줄링, 신장 트리, 최단 경로 및 네트워킹 최적화 문제를 효율적으로 해결합니다.
그리디 알고리즘이란 무엇입니까?
A 그리디 알고리즘 실행의 어느 단계에서든 해당 리소스의 최대 즉시 가용성을 기준으로 리소스 집합을 재귀적으로 분할합니다.
탐욕적 접근 방식을 이용한 문제 해결은 두 단계로 이루어집니다.
- 항목 목록 스캔 중
- 최적화
입력 배열이 점진적으로 분할됨에 따라 두 단계는 병렬로 실행됩니다.
탐욕적 접근 방식을 따르려면 재귀와 컨텍스트 전환에 대한 실무 지식이 도움이 됩니다. trac코드를 살펴보세요. 탐욕적 패러다임은 필요충분조건이라는 두 가지 명제로 설명할 수 있습니다.
두 가지 조건이 탐욕 패러다임을 정의합니다.
- 각 단계별 선택은 문제를 가장 수용 가능한 해결책으로 이끌어야 합니다.
- 문제 구조는 유한한 수의 탐욕적 단계 내에 종료되어야 합니다.
이론을 살펴봤으니 이제 탐욕적 탐색 접근법의 역사에 대해 알아보겠습니다.
그리디의 역사 Algorithms
다음은 탐욕 알고리즘 역사에서 중요한 이정표들입니다.
- 탐욕 알고리즘은 1950년대에 그래프 탐색 알고리즘을 위해 처음 개념화되었습니다.
- 에드거 다익스트라는 네덜란드 수도 암스테르담을 가로지르는 경로를 단축하기 위해 최단 경로 알고리즘을 개발했습니다.
- 같은 시기에 프림과 크루스칼은 가중 경로를 따라 경로 비용을 최소화하여 최소 신장 트리를 구축하는 최적화 전략을 개발했습니다.
- 70년대에 미국의 연구자 코먼, 레이저슨, 리베스트, 스타인은 그들의 고전 논문에서 탐욕적 해법의 재귀적 하위 구조화를 설명했습니다. Introduction to Algorithms 교과서.
- 탐욕적 탐색 패러다임은 2005년 NIST 기록에 별개의 최적화 전략으로 등재되었습니다.
- 오늘날까지도 OSPF(Open Shortest Path First)와 같은 웹 프로토콜 및 많은 패킷 교환 프로토콜은 네트워크에서 전송 시간을 최소화하기 위해 탐욕적 전략을 사용합니다.
탐욕스러운 전략과 결정
이 논리는 알고리즘이 진행하는 방향에 따라 각 단계에서 "탐욕적" 또는 "비탐욕적"이라는 이진 선택으로 귀결됩니다.
예를 들어, 다익스트라 알고리즘은 매 단계마다 비용 함수를 평가하여 인터넷상의 호스트를 식별합니다. 비용 함수가 반환하는 값에 따라 다음 경로가 "탐욕적"인지 "비탐욕적"인지가 결정됩니다.
요컨대, 알고리즘은 국소적으로 최적이 아닌 단계를 밟는 순간 탐욕적 행동을 멈추고, 탐욕적 문제는 더 이상 탐욕적인 단계를 밟을 수 없을 때 종료됩니다.
그리디 알고리즘의 특징
Greedy 알고리즘의 중요한 특징은 다음과 같습니다.
- 정렬된 자원 목록에는 시스템에 대한 제약 조건을 정량화하는 비용 또는 가치 속성이 포함됩니다.
- 이 알고리즘은 주어진 시간 제약 조건 내에서 최대한 많은 자원을 활용합니다.
- 예를 들어, 활동 일정 계획 문제에서 자원 비용은 시간 단위로 측정되며 활동은 순차적으로 수행되어야 합니다.

왜 탐욕적 접근 방식을 사용해야 할까요?
탐욕적 접근법을 사용하는 이유는 다음과 같습니다.
- 탐욕적 접근 방식에는 최적화에 매우 적합하게 만드는 장단점이 있습니다.
- 가장 분명한 이유는 실행 가능한 해결책을 즉시 도출하기 위함입니다. 아래에서 논의될 활동 선택 문제에서, 현재 활동이 완료되기 전에 더 많은 활동을 수행할 수 있다면, 동일한 시간 범위 내에서 해당 활동들을 계획할 수 있습니다.
- 또 다른 이유는 조건에 따라 문제를 재귀적으로 분할하므로 하위 솔루션을 병합할 필요가 없기 때문입니다.
- 활동 선택 문제에서 재귀적 분할 단계는 목록을 한 번 스캔하고 적합한 활동만 고려함으로써 수행됩니다.
활동 선택 문제를 해결하는 방법
활동 일정 계획 예시에서 모든 활동에는 시작 시간과 종료 시간이 있으며 참조를 위해 번호로 인덱싱됩니다. 활동 범주는 두 가지입니다.
- 고려된 활동: 나머지 활동을 더 많이 수용할 수 있는 능력을 측정하는 기준 활동입니다.
- 남은 활동: 고려되는 활동보다 앞서 하나 이상의 인덱스에 있는 활동.
어떤 활동을 수행하는 데 드는 비용은 그 활동의 소요 시간이며, 이는 (완료 시간 - 시작 시간)으로 계산됩니다.
탐욕적 범위는 단순히 고려 중인 활동 시간 내에 수행할 수 있는 남은 활동의 수를 의미합니다.
Archi탐욕스러운 접근법의 강의
단계 1) 활동 비용 목록에서 인덱스 0부터 시작하여 해당 인덱스를 기준으로 목록을 스캔합니다.
단계 2) 고려 중인 활동이 종료될 때까지 완료될 수 있는 다른 활동이 더 있다면, 남은 활동들을 찾아보세요.
단계 3) 더 이상 일정을 잡을 수 있는 활동이 없으면 현재 남아 있는 활동이 다음으로 고려될 활동이 됩니다. 새롭게 고려되는 활동을 사용하여 1단계와 2단계를 반복합니다. 남은 활동이 없으면 4단계로 이동합니다.
단계 4) 고려된 인덱스들의 합집합을 반환합니다. 이는 처리량을 최대화하는 활동 인덱스입니다.

Archi탐욕스러운 접근법의 강의
Code 설명
#include<iostream>
#include<stdio.h>
#include<stdlib.h>

#define MAX_ACTIVITIES 12

코드 설명:
- 포함된 헤더 파일/클래스
- 사용자가 설정할 수 있는 최대 활동 수입니다.
using namespace std;

class TIME
{
    public:
    int hours;

    public: TIME()
    {
   	 hours = 0;
    }
};

코드 설명:
- 스트리밍 작업에 사용할 표준 네임스페이스를 선언합니다.
- TIME에 대한 클래스 정의
- XNUMX시간 타임스탬프.
- TIME 기본 생성자
- 시간 변수.
class Activity
{
    public:
    int index;
    TIME start;
    TIME finish;

    public: Activity()
    {
   	 start = finish = TIME();
    }
};

코드 설명:
- Activity 클래스의 정의입니다.
- 함께 특정 기간을 정의하는 타임스탬프.
- 기본 생성자에서는 모든 타임스탬프가 0으로 초기화됩니다.
class Scheduler
{
    public:
    int considered_index,init_index;
    Activity *current_activities = new    Activity[MAX_ACTIVITIES];
    Activity *scheduled;

코드 설명:
- 스케줄러 클래스 정의의 1부.
- considered_index는 배열을 스캔하기 시작하는 지점입니다.
- init_index는 설정 중에 임의의 타임스탬프를 할당하는 데 사용됩니다.
- `new` 연산자를 사용하여 Activity 객체 배열을 동적으로 할당합니다.
- 스케줄링된 포인터는 현재의 탐욕적 결과값을 저장합니다.
Scheduler()
{
   	 considered_index = 0;
   	 scheduled = NULL;
...
...
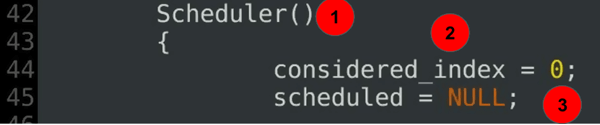
코드 설명:
- 스케줄러 생성자 — 클래스 정의의 2부.
- considered_index는 현재 스캔의 시작점을 나타냅니다.
- 탐욕적 범위는 처음에는 정의되지 않습니다.
for(init_index = 0; init_index < MAX_ACTIVITIES; init_index++) { current_activities[init_index].start.hours = rand() % 12; current_activities[init_index].finish.hours = current_activities[init_index].start.hours + (rand() % 2); printf("\nSTART:%d END %d\n", current_activities[init_index].start.hours ,current_activities[init_index].finish.hours); } … …
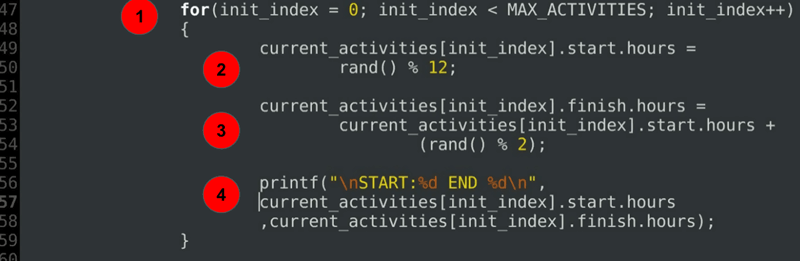
코드 설명:
- for 루프는 예약된 모든 활동의 시작 시간과 종료 시간을 초기화합니다.
- 시작 시간을 초기화합니다.
- 종료 시간을 시작 시간과 같거나 그 이후로 초기화합니다.
- 디버그 문은 할당된 시간을 출력합니다.
	public:
   		 Activity * activity_select(int);
};
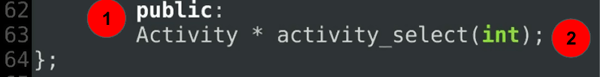
코드 설명:
- 파트 4 — 스케줄러 클래스 정의의 마지막 부분입니다.
- activity_select() 함수는 시작 인덱스를 기준으로 삼아 탐욕적 퀘스트를 하위 문제로 나눕니다.
Activity * Scheduler :: activity_select(int considered_index)
{
    this->considered_index = considered_index;
    int greedy_extent = this->considered_index + 1;
…
…

- 범위 지정 연산자(::)는 함수 정의를 스케줄러 클래스에 연결합니다.
- considered_index는 값으로 전달되고, greedy_extent는 그 바로 다음 인덱스로 초기화됩니다.
Activity * Scheduler :: activity_select(int considered_index) { while( (greedy_extent < MAX_ACTIVITIES ) && ((this->current_activities[greedy_extent]).start.hours < (this->current_activities[considered_index]).finish.hours )) { printf("\nSchedule start:%d \nfinish%d\n activity:%d\n", (this->current_activities[greedy_extent]).start.hours, (this->current_activities[greedy_extent]).finish.hours, greedy_extent + 1); greedy_extent++; } … ...

코드 설명:
- 핵심 논리는 탐욕적 확장 범위가 MAX_ACTIVITIES로 제한된다는 것입니다.
- 현재 활동의 시작 시간과 해당 활동의 종료 시간을 비교합니다.
- 해당 조건이 충족되는 동안 선택적으로 디버그 메시지가 출력됩니다.
- 그러면 탐욕스러운 범위는 활동 배열의 다음 인덱스로 이동합니다.
...
if ( greedy_extent <= MAX_ACTIVITIES )
    {

   	 return activity_select(greedy_extent);
    }
    else
    {
   	 return NULL;
    }
}

코드 설명:
- 조건문은 모든 활동이 포함되었는지 확인합니다.
- 그렇지 않으면 알고리즘은 현재 인덱스부터 탐욕적 탐색을 다시 시작합니다. 이는 문제를 탐욕적으로 분할하는 재귀적 단계입니다.
- 만약 그렇다면, 제어권은 호출자에게 돌아가며 더 이상 탐욕을 확장할 여지가 없습니다.
int main()
{
    Scheduler *activity_sched = new Scheduler();
    activity_sched->scheduled = activity_sched->activity_select(
   				activity_sched->considered_index);
    return 0;
}

코드 설명:
- 메인 함수는 스케줄러를 호출합니다.
- 새로운 Scheduler 객체가 인스턴스화됩니다.
- activity_select() 함수는 탐욕스러운 퀘스트가 끝나면 호출자에게 액티비티 포인터를 반환합니다.
출력:
START:7 END 7

START:9 END 10

START:5 END 6

START:10 END 10

START:9 END 10

Schedule start:5
finish6
 activity:3

Schedule start:9
finish10
 activity:5
욕심쟁이 기법의 한계
탐욕적 접근 방식은 정렬과 같이 모든 하위 문제에 대해 최적의 해법이 필요한 문제에는 적합하지 않습니다.
이러한 경우 탐욕적 방법은 잘못될 수 있으며, 최악의 경우 최적해가 아닌 해를 도출할 수 있습니다.
탐욕 알고리즘의 핵심적인 단점은 현재의 탐욕스러운 상태보다 앞에 무엇이 있는지 알지 못한 채 선택한다는 점입니다.
아래 그림은 탐욕 알고리즘의 이러한 단점을 보여줍니다.

여기 트리로 표시된 탐욕적 스캔(값이 높을수록 탐욕도가 높음)에서, 값이 40인 알고리즘은 다음으로 29를 선택하고 12에서 종료하여 총 41개를 선택합니다.
반면, 분할 정복 전략은 25에 40을 더해 총 65를 얻는데, 이는 국소적 탐욕적 선택보다 24점 더 높은 수치입니다.
욕심쟁이의 예 Algorithms
대부분의 네트워킹 알고리즘은 탐욕적 접근 방식을 사용합니다. 일반적인 탐욕적 알고리즘의 예는 다음과 같습니다.
- 프림의 최소 신장 트리 알고리즘
- 외판원 문제 (근사치)
- 그래프 지도 색칠하기
- 크루스칼의 최소 신장 트리 알고리즘
- 다익스트라 최단 경로 알고리즘
- 그래프 정점 커버
- 배낭 문제
- 마감 기한이 포함된 작업 순서
