
NLTK 다운로드 및 설치 방법
 에블린 클라크
⚡ 스마트 요약
NLTK를 다운로드하고 설치하세요. WindowsMac 또는 Linux를 설치하여 사용하세요. Python 먼저, 그 다음 내추럴을 추가합니다. Language Toolpip 또는 Anaconda를 통해 키트를 설치하고 코퍼스 데이터셋을 다운로드합니다.
NLTK 설치 Windows
NLTK 설정 방법을 알아보세요 Windows 명령 프롬프트에서. 아래 지침은 다음을 가정합니다. Python 아직 설치되지 않았으므로 첫 번째 단계는 설치하는 것입니다. Python.
설치 Python in Windows
단계 1) 링크 열기 https://www.python.org/downloads/, 최신 버전을 선택하세요 Windows 놓습니다.
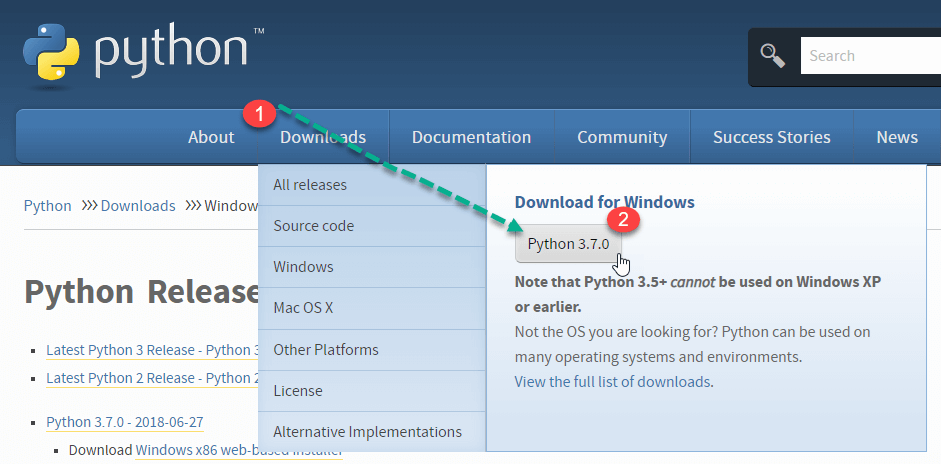
주의 사항이전 버전을 보려면 다운로드 탭을 방문하여 모든 릴리스를 확인하세요.

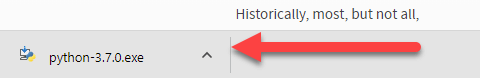
단계 2) 다운로드한 설치 파일(installer file)을 클릭하십시오.
단계 3) 사용자 지정 설치를 선택하세요.
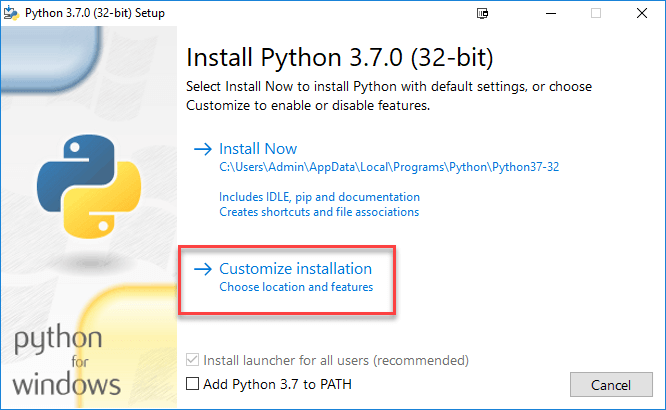
단계 4) 다음을 클릭하세요.

단계 5) 다음 화면에서 :
- 고급 옵션을 선택하세요.
- 사용자 지정 설치 위치를 제공하세요. 이 예에서는 접근성을 높이기 위해 C 드라이브의 폴더를 선택했습니다.
- 설치를 클릭합니다.

단계 6) 설치가 완료되면 닫기 버튼을 클릭하십시오.

단계 7) Scripts 폴더의 경로를 복사하세요.

단계 8) . Windows 명령 프롬프트:
- pip 폴더가 있는 위치로 이동하세요.
- NLTK를 설치하려면 다음 명령어를 입력하십시오.
pip3 install nltk
- 설치가 성공적으로 완료될 것입니다.

주의사항: Python 2. 명령어를 사용하세요 pip2 install nltk.
단계 9) 에서 Windows 시작 메뉴에서 검색하여 엽니다. Python 껍질.

단계 10) 아래 명령어를 실행하여 설치가 제대로 되었는지 확인하십시오.
import nltk

오류 메시지가 나타나지 않으면 설치가 완료된 것입니다.
Mac/Linux에 NLTK 설치
Mac 또는 Linux에 NLTK를 설치하려면 다음이 필요합니다. Python 패키지 관리자 pip. pip가 설치되어 있지 않다면 아래 지침에 따라 설치를 완료하세요.
단계 1) ty를 사용하여 패키지 인덱스를 업데이트합니다.ping 아래 명령어를 입력하세요:
sudo apt update
단계 2) pip를 설치하세요 Python 3:
sudo apt install python3-pip
easy_install을 통해 pip를 설치할 수도 있습니다.
sudo apt-get install python-setuptools python-dev build-essential
easy_install이 설치되면 아래 명령어를 실행하여 pip를 설치하세요.
sudo easy_install pip
단계 3) NLTK를 설치하려면 다음 명령어를 사용하십시오.
sudo pip install -U nltk
sudo pip3 install -U nltk
Anaconda를 통해 NLTK 설치
단계 1) Anaconda를 설치하려면 다음 링크를 방문하세요. https://www.anaconda.com/products/individual 그리고 Python 필요한 버전입니다.

참고: 자세한 단계는 이 튜토리얼을 참조하세요. Anaconda를 설치하세요.
단계 2) Anaconda 프롬프트에서:
- 다음 명령을 입력하십시오.
conda install -c anaconda nltk
- Rev패키지 업그레이드, 다운그레이드 및 설치 정보를 확인한 후 '예'를 입력하십시오.
- NLTK가 다운로드 및 설치되었습니다.

NLTK 데이터세트
NLTK 모듈에는 사용 전에 다운로드해야 하는 여러 데이터 세트가 포함되어 있습니다. 기술적으로 각 데이터 세트는 다음과 같이 불립니다. 원금. 일반적인 예로는 다음이 있습니다. 스톱 워드, 구텐베르그, 프레임넷_v15, 큰 문법, 갈색예산 및 워드넷.
NLTK의 모든 패키지를 다운로드하는 방법
단계 1) 실행 Python 통역사 in Windows 또는 Linux.
단계 2)
- 명령어를 입력하세요:
import nltk
nltk.download ()
- NLTK 다운로더 창이 열립니다. 다운로드 버튼을 클릭하여 데이터셋을 다운로드하세요. 이 과정은 인터넷 연결 속도에 따라 시간이 다소 걸릴 수 있습니다.

알림: 파일 > 다운로드 디렉터리 변경을 클릭하여 다운로드 위치를 변경할 수 있습니다.

단계 3) 설치된 데이터를 테스트하려면 다음 코드를 사용하십시오.
>>> from nltk.corpus import brown
>>>brown.words()
['The', 'Fulton', 'County', 'Grand', 'Jury', 'said', …]

NLP 스크립트 실행
이 섹션에서는 NLP 스크립트가 로컬 PC에서 실행되는 방식을 설명합니다. 적절한 라이브러리 선택은 요구 사항에 따라 달라집니다. 공식 목록을 참조하세요. NLP 라이브러리 spaCy, gensim, TextBlob 등의 대안도 있습니다.
NLTK 스크립트를 실행하는 방법
단계 1) 즐겨 사용하는 코드 편집기에서 코드를 복사하고 파일을 다음과 같이 저장하세요. NLTKsample.py:
from nltk.tokenize import RegexpTokenizer
tokenizer = RegexpTokenizer(r'\w+')
filterdText=tokenizer.tokenize('Hello Guru99, You have build a very good site and I love visiting your site.')
print(filterdText)

Code 설명 :
- 이 프로그램의 목적은 주어진 텍스트에서 모든 종류의 구두점을 제거하는 것입니다. 이를 위해 "RegexpTokenizer"라는 모듈을 가져왔습니다. NLTK 사용자가 선택한 모든 표현식, 기호, 문자 또는 숫자 값을 제거합니다.
- 정규 표현식이 "RegexpTokenizer" 모듈에 전달됩니다.
- 텍스트는 "tokenize" 메서드를 사용하여 토큰화되고, 그 결과는 "filterdText" 변수에 저장됩니다.
- 결과는 "print()" 함수를 사용하여 출력됩니다.
단계 2) 명령 프롬프트에서:
- 파일을 저장한 위치로 이동하세요.
- 명령을 실행하십시오.
python NLTKsample.py.

출력은 다음과 같습니다.
['안녕하세요', 'Guru99', '당신', '가지고 있다', '만들다', '매우 좋은', '사이트', '그리고', '나는 당신의 사이트를 방문하는 것을 좋아합니다']
