
Apache Flume 튜토리얼:이란 무엇입니까? Archi강의 및 Hadoop 예제
 프라풀라 라나디베
⚡ 스마트 요약
Apache Flume은 대용량 로그 데이터를 수집, 집계 및 HDFS로 이동하는 분산 서비스로, 소스, 채널 및 싱크를 연결하는 에이전트를 중심으로 구축되었습니다.
Hadoop의 Apache Flume이란 무엇입니까?
Apache Flume은 대규모 로그 데이터를 수집, 집계 및 이동하기 위한 안정적이고 분산된 시스템입니다. 스트리밍 데이터 흐름을 기반으로 하는 간단하면서도 유연한 아키텍처를 가지고 있습니다. Apache Flume은 웹 서버의 로그 파일에 있는 로그 데이터를 수집하고 이를 집계하는 데 사용됩니다. HDFS 분석을 위해.
Hadoop의 Flume은 다음을 포함한 다양한 소스를 지원합니다.
- 'tail' (로컬 파일의 데이터를 파이프를 통해 Flume으로 전달하여 HDFS에 기록하는 기능으로, Unix 명령어 'tail'과 유사합니다.)
- 시스템 로그
- 아파치 log4j (이를 가능하게 하는) Java Flume을 통해 HDFS의 파일에 이벤트를 쓰는 애플리케이션)
현재 릴리스는 Flume 1.11.02022년 10월 25일에 출판되었으며 다음에서 구할 수 있습니다. Apache Flume 다운로드 페이지이 안내서는 1.4.0 버전을 기준으로 작성되었으므로, 아래 단계 중 일부는 최신 버전에서 다르게 동작할 수 있다는 점에 유의하십시오.
독감 Archi강의
Flume 에이전트는 JVM 이벤트가 외부 소스에서 시작된 후 전파되는 세 가지 구성 요소(플룸 소스, 플룸 채널 및 플룸 싱크)로 이루어진 프로세스입니다. 아래 다이어그램은 이러한 구성 요소들의 연결 방식을 보여줍니다.
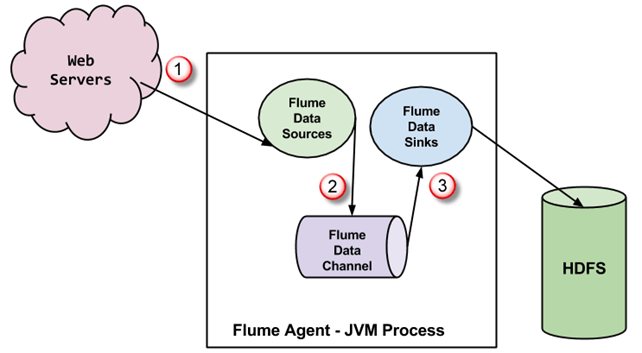
- 외부 소스(웹 서버)에서 생성된 이벤트는 Flume 소스에서 소비됩니다. 외부 소스는 대상 소스가 인식할 수 있는 형식으로 이벤트를 Flume 소스로 전송합니다.
- Flume 소스는 이벤트를 수신하여 하나 이상의 채널에 저장합니다. 채널은 Flume 싱크에서 이벤트가 소비될 때까지 이벤트를 보관하는 저장소 역할을 합니다. 이 채널은 이벤트를 저장하기 위해 로컬 파일 시스템을 사용할 수 있습니다.
- Flume 싱크는 채널에서 이벤트를 제거하고 HDFS와 같은 외부 저장소에 저장합니다. Flume 에이전트가 여러 개 있을 수 있는데, 이 경우 Flume 싱크는 해당 이벤트를 흐름에서 다음 에이전트의 Flume 소스로 전달합니다.
수로의 몇 가지 중요한 특징
- Flume은 스트리밍 데이터 흐름을 기반으로 하는 유연한 설계를 갖추고 있습니다. 다양한 장애 조치 및 복구 메커니즘을 통해 내결함성과 안정성을 제공합니다. Flume은 다음과 같은 다양한 수준의 신뢰성을 제공합니다. '최선을 다한 배송' '엔드 투 엔드 배송'. 최선의 노력 전달 Flume 노드 오류를 전혀 허용하지 않는 반면 종단간 전달 여러 노드에 장애가 발생하더라도 데이터 전송을 보장합니다.
- Flume은 소스와 싱크 간에 데이터를 전송합니다. 이러한 데이터 수집은 예약된 일정에 따라 또는 이벤트 기반으로 수행될 수 있습니다. Flume은 자체 쿼리 처리 엔진을 탑재하고 있어, 새로운 데이터 배치를 의도된 싱크로 이동하기 전에 손쉽게 변환할 수 있습니다.
- 가능한 수로 싱크 HDFS를 포함합니다. H베이스Flume은 네트워크 트래픽 데이터, 소셜 미디어 웹사이트에서 생성된 데이터 및 이메일 메시지와 같은 이벤트 데이터도 전송할 수 있습니다.
Flume, 라이브러리 및 소스 코드 설정
본격적인 과정을 시작하기 전에 Hadoop이 설치되어 있는지 확인하십시오. 설치되어 있지 않다면 설치 과정을 따라 진행하십시오. 하둡 설치 방법 먼저, 사용자를 'hduser'로 변경하십시오(Hadoop 구성 시 사용한 ID입니다. 필요에 따라 본인의 Hadoop 구성 시 사용한 사용자 ID로 변경할 수 있습니다).

단계 1) 'FlumeTutorial'이라는 이름으로 새 디렉토리를 만드세요.
sudo mkdir FlumeTutorial
- 읽기, 쓰기 및 실행 권한을 부여하십시오.
sudo chmod -R 777 FlumeTutorial
- 파일을 복사하세요 마이트위터Source.java My트위터SourceForFlume.java 이 디렉터리에 넣으세요.
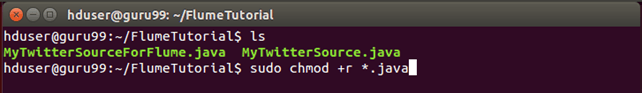
아래와 같이 모든 파일의 파일 권한을 확인하고, 읽기 권한이 없으면 부여하십시오.
단계 2) 'Apache Flume'을 다운로드하세요. https://flume.apache.org/download.html.
이 Flume 튜토리얼에서는 Apache Flume 1.4.0이 사용되었습니다.

다음으로, 미러 사이트를 클릭하세요.

단계 3) 다운로드한 tarball 파일을 원하는 디렉토리에 복사하고 실행하세요.trac다음 명령어를 사용하여 내용을 확인하세요.
sudo tar -xvf apache-flume-1.4.0-bin.tar.gz

이렇게 하면 apache-flume-1.4.0-bin이라는 새 디렉터리가 생성됩니다.trac파일을 그 안에 넣으세요. 그 디렉토리는 다음과 같이 불립니다. 기사의 나머지 부분에서.
단계 4) Flume 라이브러리 설정. twitter4j-core-4.0.1.jar, flume-ng-configuration-1.4.0.jar, flume-ng-core-1.4.0.jar 및 flume-ng-sdk-1.4.0.jar 파일을 다음 위치에 복사하세요.
/lib/
복사한 JAR 파일 중 하나 또는 전부에게 실행 권한이 설정되어 있을 수 있으며, 이로 인해 코드 컴파일에 문제가 발생할 수 있으므로 실행 권한을 취소해야 합니다. 제 경우에는 twitter4j-core-4.0.1.jar 파일에 실행 권한이 설정되어 있었는데, 아래와 같이 취소했습니다.
sudo chmod -x twitter4j-core-4.0.1.jar

이후 아래 명령어를 실행하면 twitter4j-core-4.0.1.jar 파일에 대한 '읽기' 권한이 모든 사용자에게 부여됩니다.
sudo chmod +rrr /usr/local/apache-flume-1.4.0-bin/lib/twitter4j-core-4.0.1.jar
참고로 저는 twitter4j-core-4.0.1.jar 파일을 다음에서 다운로드했습니다. 메이븐 리포지토리그리고 모든 Flume JAR 파일, 즉 flume-ng-*-1.4.0.jar 파일부터 org.apache.flume 아티팩트.
Flume을 사용하여 트위터에서 데이터 로드
단계 1) 소스 코드 파일이 있는 디렉토리로 이동하세요.
단계 2) CLASSPATH를 설정하여 포함시키세요 /lib/* 및 ~/FlumeTutorial/flume/mytwittersource/*.
export CLASSPATH="/usr/local/apache-flume-1.4.0-bin/lib/*:~/FlumeTutorial/flume/mytwittersource/*"

단계 3) 아래 명령어를 사용하여 소스 코드를 컴파일하십시오.
javac -d . My트위터SourceForFlume.java My트위터Source.java

단계 4) JAR 파일을 생성하세요. 먼저 원하는 텍스트 편집기를 사용하여 Manifest.txt 파일을 만들고 아래 줄을 추가하세요.
Main-Class: flume.mytwittersource.My트위터SourceForFlume
여기서 flume.mytwittersource.My트위터SourceForFlume은 메인 클래스의 이름입니다. 아래와 같이 이 줄 끝에서 엔터 키를 눌러야 합니다.

이제 다음과 같이 'My트위터SourceForFlume.jar' JAR 파일을 생성하세요.
jar cfm My트위터SourceForFlume.jar Manifest.txt flume/mytwittersource/*.class

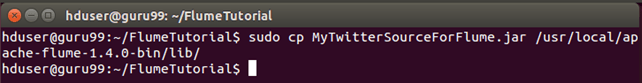
단계 5) 이 JAR 파일을 복사하세요 /lib/.
sudo cp My트위터SourceForFlume.jar <Flume Installation Directory>/lib/
단계 6) Flume의 구성 디렉토리로 이동하세요. /conf.
flume.conf 파일이 없으면 flume-conf.properties.template 파일을 복사하여 flume.conf로 이름을 변경하십시오.
sudo cp flume-conf.properties.template flume.conf

flume-env.sh 파일이 없으면 flume-env.sh.template 파일을 복사하여 flume-env.sh로 이름을 변경하십시오.
sudo cp flume-env.sh.template flume-env.sh

트위터 애플리케이션 만들기
이것부터 읽으세요. v1.1 스트리밍 statuses/filter twitter4j 4.0.1에 필요한 엔드포인트는 2023년 3월 9일에 서비스가 종료되었으며, 이를 대체한 API v2 필터링 스트림은 현재 다음과 같습니다. developer.x.com이 기능은 유료 티어 뒤에 있습니다. 아래 화면을 사용자 지정 소스 패턴으로 간주한 다음 동일한 에이전트를 파일, 실행 파일 또는 Kafka 소스로 지정하십시오.
단계 1) 개발자 포털에 로그인하여 트위터 애플리케이션을 생성하세요.


단계 2) '내 애플리케이션'으로 이동하세요(이 옵션은 오른쪽 상단 모서리에 있는 '달걀' 버튼을 클릭하면 나타납니다).

단계 3) '새 앱 만들기'를 클릭하여 새 애플리케이션을 만드세요.
단계 4) 신청서 이름, 설명 및 웹사이트 주소를 입력하여 신청 정보를 작성하십시오. 각 입력란 아래에 있는 참고 사항을 참조하십시오.
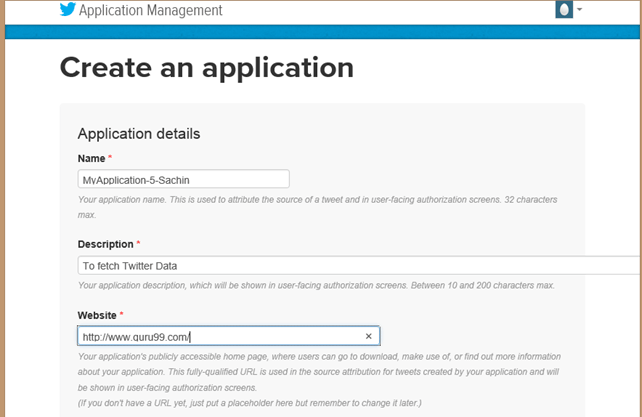
단계 5) 페이지를 아래로 스크롤하여 '예, 동의합니다'를 선택하고 '트위터 애플리케이션 만들기' 버튼을 클릭하세요.

단계 6) 새로 생성된 애플리케이션 창에서 'API 키' 탭으로 이동하여 페이지를 아래로 스크롤한 다음 '액세스 토큰 생성' 버튼을 클릭합니다.


단계 7) 페이지를 새로 고칩니다.
단계 8) 'OAuth 테스트'를 클릭하세요. 그러면 애플리케이션의 'OAuth' 설정이 표시됩니다.

단계 9) 'flume.conf' 파일을 수정하여 다음 OAuth 설정을 사용하십시오. 'flume.conf' 파일을 수정하는 단계는 아래에 나와 있습니다.

'flume.conf' 파일을 업데이트하려면 소비자 키, 소비자 비밀 키, 액세스 토큰 및 액세스 토큰 비밀 키를 복사해야 합니다.
참고: 이 값들은 사용자 개인 정보이므로 기밀이며, 따라서 공유해서는 안 됩니다.
'flume.conf' 파일 수정
단계 1) 'flume.conf' 파일을 쓰기 모드로 열고 아래 매개변수에 값을 설정하십시오.
sudo gedit flume.conf
아래 내용을 복사하세요.
MyTwitAgent.sources = 트위터
MyTwitAgent.channels = MemChannel
MyTwitAgent.sinks = HDFS
MyTwitAgent.sources.트위터.type = flume.mytwittersource.My트위터SourceForFlume
MyTwitAgent.sources.트위터.channels = MemChannel
MyTwitAgent.sources.트위터.consumerKey = <Copy consumer key value from 트위터 App>
MyTwitAgent.sources.트위터.consumerSecret = <Copy consumer secret value from 트위터 App>
MyTwitAgent.sources.트위터.accessToken = <Copy access token value from 트위터 App>
MyTwitAgent.sources.트위터.accessTokenSecret = <Copy access token secret value from 트위터 App>
MyTwitAgent.sources.트위터.keywords = guru99
MyTwitAgent.sinks.HDFS.channel = MemChannel
MyTwitAgent.sinks.HDFS.type = hdfs
MyTwitAgent.sinks.HDFS.hdfs.path = hdfs://localhost:54310/user/hduser/flume/tweets/
MyTwitAgent.sinks.HDFS.hdfs.fileType = DataStream
MyTwitAgent.sinks.HDFS.hdfs.writeFormat = Text
MyTwitAgent.sinks.HDFS.hdfs.batchSize = 1000
MyTwitAgent.sinks.HDFS.hdfs.rollSize = 0
MyTwitAgent.sinks.HDFS.hdfs.rollCount = 10000
MyTwitAgent.channels.MemChannel.type = memory
MyTwitAgent.channels.MemChannel.capacity = 10000
MyTwitAgent.channels.MemChannel.transactionCapacity = 1000

단계 2) 또한 트위터Agent.sinks.HDFS.hdfs.path를 아래와 같이 설정하십시오.
트위터Agent.sinks.HDFS.hdfs.path = hdfs:// : / /flume/트윗/

찾으려면 , 그리고 아래 그림과 같이 $HADOOP_HOME/etc/hadoop/core-site.xml 파일에 설정된 'fs.defaultFS' 매개변수 값을 참조하십시오.

단계 3) 데이터가 HDFS에 도착하는 즉시 기록되도록 하려면 아래 항목이 있는 경우 삭제하십시오.
YuAgent.sinks.HDFS.hdfs.rollInterval = 600
예: Flume을 사용하여 트위터 데이터 스트리밍
단계 1) 'flume-env.sh' 파일을 쓰기 모드로 열고 아래 매개변수에 값을 설정하세요.
JAVA_HOME=<Installation directory of Java>
FLUME_CLASSPATH="<Flume Installation Directory>/lib/My트위터SourceForFlume.jar"

단계 2) 하둡을 시작하세요.
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
단계 3) Flume tarball에 포함된 JAR 파일 두 개가 Hadoop 2.2.0과 호환되지 않으므로, 이 Apache Flume 예제에서는 아래 단계를 따라 Flume을 Hadoop 2.2.0과 호환되도록 만듭니다. 이 JAR 파일 교체는 1.4.0 버전 시절의 수정 사항이며, Flume 1.11.0에는 이미 최신 protobuf 및 Guava 빌드가 포함되어 있으므로 최신 tarball에는 일반적으로 이러한 수정이 필요하지 않습니다.
a. protobuf-java-2.4.1.jar 파일을 '에서 이동하세요. '/lib' 디렉토리로 먼저 이동하세요.
CD /lib
sudo mv protobuf-java-2.4.1.jar ~/

b. 아래와 같이 'guava'라는 JAR 파일을 찾으세요.
find . -name "guava*"

guava-10.0.1.jar 파일을 '에서 이동하세요 /lib'.
sudo mv guava-10.0.1.jar ~/

c. guava-17.0.jar 파일을 다음에서 다운로드하세요. 메이븐 리포지토리아래에 나와 있습니다.

이제 다운로드한 JAR 파일을 '에 복사하세요' /lib'.
단계 4) '로 이동하세요' `/bin`을 입력하고 다음과 같이 Flume을 시작하세요.
./flume-ng agent -n MyTwitAgent -c conf -f <Flume Installation Directory>/conf/flume.conf

Flume이 트윗을 가져오는 명령 프롬프트 창은 다음과 같습니다.

명령 창 메시지를 보면 출력 결과가 /user/hduser/flume/tweets/ 디렉터리에 기록되는 것을 알 수 있습니다. 이제 웹 브라우저를 사용하여 이 디렉터리를 열어 보세요.
단계 5) 데이터 로드 결과를 확인하려면 브라우저에서 http://localhost:50070/을 열고 파일 시스템을 탐색한 다음 데이터가 로드된 디렉토리로 이동하세요.
/flume/트윗/
포트 50070은 Hadoop 2의 NameNode 웹 UI이며, Hadoop 3에서는 동일한 페이지가 포트 9870으로 이동했습니다.

플룸은 섭취의 절반입니다. 스쿱 테이블을 일괄적으로 가져오고, Flume은 이벤트를 스트리밍합니다. 돼지 or 하이브 파일 모양을 만들고 오지 체인 일정을 잡습니다. 참조 빅 데이터 분석 도구, MapReduce 조인 및 카운터 탈 렌드.
