
TensorFlow를 이용한 인공신경망(ANN) 튜토리얼
 에블린 클라크
⚡ 스마트 요약
인공 신경망은 연결된 레이어를 통해 입력을 전달하고, 손실 함수로 결과를 평가하고, 최적화 도구로 가중치를 조정하는 방식으로 학습합니다. 이 가이드에서는 TensorFlow를 사용하여 인공 신경망을 구축하고 MNIST 숫자 데이터셋을 분류하는 방법을 보여줍니다.
인공 신경망이란 무엇입니까?
An 인공 신경망(ANN) 인공신경망은 생물학적 신경망에서 영감을 받아 인공 뉴런이라고 불리는 연결된 단위들의 집합으로 구성된 인공 두뇌를 만드는 컴퓨터 시스템입니다. 이는 인간처럼 정보를 분석하고 처리하도록 설계되었습니다. 인공신경망은 데이터가 많아질수록 더 나은 결과를 도출하는 자기 학습 기능을 가지고 있습니다.
아래 그림 trac이는 원시 입력부터 가중치를 수정하는 최적화 도구에 이르기까지 해당 네트워크를 한 번 완전히 통과하는 것을 의미합니다.

인공 신경망(ANN)은 네 가지 주요 개체로 구성됩니다.
- 항목 : 모든 학습은 레이어에서 이루어집니다. 레이어는 1) 입력, 2) 은닉, 3) 출력의 세 가지로 구성됩니다.
- 특징 및 레이블: 네트워크에 입력되는 데이터(특징)와 네트워크에서 출력되는 데이터(레이블)
- 손실 기능: 학습 단계의 성과를 평가하는 데 사용되는 지표
- 최적화 : 네트워크 내 지식을 업데이트하여 학습 효과를 높이세요.
신경망은 입력 데이터를 받아 여러 레이어로 구성된 앙상블에 입력합니다. 그런 다음 손실 함수를 사용하여 성능을 평가합니다. 손실 함수는 신경망이 지식을 습득하기까지 거쳐야 할 경로를 알려줍니다. 신경망은 최적화 도구를 사용하여 해당 지식을 개선합니다.
위의 그림을 보면 기본 메커니즘을 이해할 수 있습니다.
이 프로그램은 입력값을 받아 두 개의 완전 연결 계층에 입력합니다. 수학 문제를 생각해 보세요. 가장 먼저 하는 일은 해당 단원을 읽고 문제를 푸는 것입니다. 그런 다음 새로 배운 지식을 문제에 적용합니다. 이렇게 해도 좋은 점수를 받기는 어려울 것입니다. 신경망도 마찬가지입니다. 처음 데이터를 접하고 예측을 할 때는 결과가 실제 데이터와 완벽하게 일치하지 않을 것입니다.
네트워크는 지식을 향상시키기 위해 최적화 도구를 사용합니다. 이 비유에서 최적화 도구는 마치 책을 다시 읽는 것과 같습니다. 다시 읽으면 새로운 통찰력을 얻을 수 있는 것처럼, 네트워크는 최적화 도구를 사용하여 지식을 업데이트하고, 새로 습득한 지식을 테스트하여 얼마나 더 학습해야 하는지 확인합니다. 프로그램은 가능한 한 가장 낮은 오류를 발생시킬 때까지 이 단계를 반복합니다.
수학 문제 비유로 들자면, 교과서 내용을 완전히 이해할 때까지 여러 번 읽는 것과 같습니다. 여러 번 읽었는데도 계속 틀린다면, 현재 학습 내용으로는 더 이상 학습할 수 없다는 뜻입니다. 점수를 높이려면 다른 교과서를 사용하거나 다른 학습 방법을 시도해야 합니다. 신경망도 마찬가지입니다. 오류 감소가 멈추고 손실 곡선이 평평해진다면, 현재의 아키텍처로는 더 이상 학습할 수 없습니다. 학습 능력을 향상시키려면 신경망을 더 최적화해야 합니다.
이 네 가지 객체는 네트워크를 설계할 때 구성하는 구성 요소에 직접적으로 대응됩니다.
뉴럴 네트워크 Archi강의
인공 신경망 아키텍처는 다음과 같은 구성 요소로 이루어져 있습니다.
- 레이어
- 활성화 기능
- 손실 기능
- 최적화
레이어
레이어는 모든 학습이 이루어지는 곳입니다. 레이어 내부에는 임의의 개수의 뉴런이 있으며, 각 뉴런은 고유한 가중치를 가지고 있습니다. 일반적인 신경망은 종종 완전 연결 레이어(또는 밀집 연결 레이어)로 구성됩니다. 이는 모든 입력이 출력에 직접 연결됨을 의미합니다.
일반적인 신경망은 입력 벡터와 레이블을 포함하는 스칼라 값을 입력으로 받습니다. 가장 간단한 구성은 0과 1, 두 가지 클래스만 있는 이진 분류입니다.
이 네트워크는 입력을 받아 연결된 모든 노드로 전송하고 활성화 함수를 사용하여 신호를 계산합니다. 아래 번호가 매겨진 다이어그램은 단일 노드를 확대하여 가중 합과 활성화 단계를 별도로 보여줍니다.

위 그림은 이러한 개념을 나타냅니다. 첫 번째 층은 입력값을 저장합니다. 은닉층이라고 불리는 두 번째 층은 이전 층에서 가중치가 적용된 입력값을 받습니다.
- 첫 번째 노드는 입력값입니다.
- 뉴런은 입력 부분과 활성화 함수 부분으로 분해됩니다. 왼쪽 부분은 이전 레이어에서 모든 입력을 받습니다. 오른쪽 부분은 활성화 함수를 통과한 입력의 합입니다.
- 은닉층에서 계산된 출력값은 예측에 사용됩니다. 분류의 경우 클래스 수와 같습니다. 회귀의 경우 하나의 값만 예측됩니다.
활성화 기능
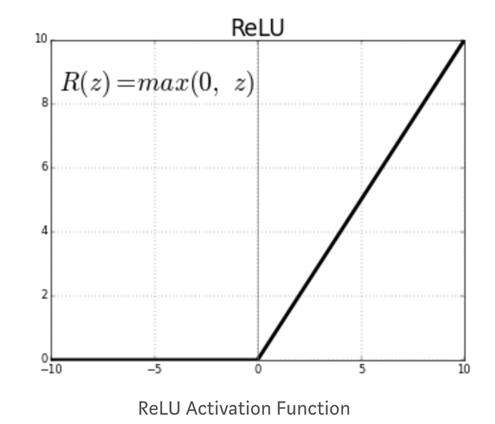
노드의 활성화 함수는 입력값이 주어졌을 때의 출력값을 정의합니다. 신경망이 비선형 패턴을 학습하려면 활성화 함수가 필요합니다. 흔히 사용되는 활성화 함수로는 ReLU(Rectified Linear Unit)가 있습니다. 이 함수는 모든 음수 값에 대해 0을 반환합니다.
다른 활성화 기능은 다음과 같습니다:
- 조각별 선형
- 시그 모이 드
- 탄
- 새는 ReLU
아래 그림은 ReLU 활성화 함수가 왜 그렇게 설명되는지 보여줍니다. 모든 음수 입력에 대해 0에서 곡선이 평평하고 그 이후에는 선형적으로 상승합니다.
신경망을 구축할 때 내려야 할 중요한 결정은 다음과 같습니다.
- 신경망의 레이어 수
- 각 레이어의 숨겨진 유닛 수
많은 층과 은닉 유닛을 가진 신경망은 데이터에 대한 복잡한 표현을 학습할 수 있지만, 네트워크의 계산 비용이 매우 높아집니다.
손실 기능
은닉층과 활성화 함수를 정의한 후에는 손실 함수와 최적화 프로그램을 지정해야 합니다.
이진 분류의 경우, 이진 교차 엔트로피 손실 함수를 사용하는 것이 일반적입니다. 선형 회귀평균 제곱 오차를 사용합니다.
손실 함수는 옵티마이저의 성능을 추정하는 중요한 지표입니다. 훈련 중에는 이 측정항목이 최소화됩니다. 다루고 있는 문제의 유형에 따라 이 수량을 신중하게 선택해야 합니다.
최적화
손실 함수는 모델의 성능을 측정하는 척도입니다. 최적화 알고리즘은 손실을 줄이기 위해 네트워크의 가중치를 개선하는 데 도움을 줍니다. 다양한 최적화 알고리즘이 있지만, 가장 일반적인 것은 확률적 경사 하강법(Stochastic Gradient Descent)입니다.
기존 최적화 프로그램은 다음과 같습니다.
- Momentum 최적화
- 네스테로프 가속 경사
- 아다그라드
- 아담 최적화
Archi구조만으로는 사용 가능한 모델이 보장되지 않습니다.
신경망의 한계
다음은 신경망의 한계점입니다.
피팅
복잡한 신경망의 일반적인 문제점은 이전에 본 적 없는 데이터에 대한 일반화 능력이 부족하다는 것입니다. 가중치가 많은 신경망은 훈련 데이터 세트의 특정 세부 사항을 매우 잘 식별할 수 있지만, 이는 종종 과적합으로 이어집니다. 데이터가 그룹 내에서 불균형한 경우(즉, 일부 그룹에 충분한 데이터가 없는 경우), 신경망은 훈련 과정에서는 매우 잘 학습하지만, 이전에 본 적 없는 데이터에 이러한 패턴을 일반화하는 능력이 부족해집니다.
절충점이 있습니다 기계 학습 최적화와 일반화의 사이.
- 모델을 최적화하려면 훈련 데이터 세트의 손실을 최소화하는 최적의 매개변수를 찾아야 합니다.
- 그러나 일반화는 보이지 않는 데이터에 대해 모델이 어떻게 작동하는지 알려줍니다.
모델이 훈련 데이터의 특정 세부 사항이나 원치 않는 패턴을 포착하는 것을 방지하기 위해 다양한 기법을 사용할 수 있습니다. 가장 좋은 방법은 충분한 양의 데이터를 포함하는 균형 잡힌 데이터셋을 사용하는 것입니다. 과적합을 줄이는 기술을 정규화라고 합니다. 아래 세 가지 기법은 일반적인 시작점입니다.
| 기술 | 그것이 제약하는 것은 무엇인가 | 이 튜토리얼에서 일반적으로 사용되는 설정입니다. |
|---|---|---|
| 네트워크 크기 | 레이어 수와 은닉 유닛 수 | 숨겨진 레이어 두 개, 각각 300개와 100개 유닛 |
| L1/L2 가중치 정규화 | 가중 계수의 크기 | l1_regularization_strength 및 l2_regularization_strength는 0.01입니다. |
| 탈락 | 훈련 단계별로 꺼진 장치의 비율 | 0.3의 탈락률 |
네트워크 크기
레이어와 은닉 유닛이 너무 많은 신경망은 지나치게 복잡한 것으로 알려져 있습니다. 모델의 복잡성을 줄이는 간단한 방법은 크기를 줄이는 것입니다. 레이어 수를 정하는 데 있어 단 하나의 최적 방법은 없습니다. 적은 수의 레이어로 시작하여 모델이 과적합될 때까지 크기를 늘려가야 합니다.
가중치 정규화
과적합을 방지하는 일반적인 기법은 신경망의 가중치에 제약을 추가하는 것입니다. 이 제약은 신경망의 가중치가 작은 값만 취하도록 합니다. 제약은 오류의 손실 함수에 추가됩니다. 정규화에는 두 가지 종류가 있습니다.
- L1 (올가미): 비용은 가중 계수의 절댓값에 비례합니다.
- L2(능선): 비용은 가중 계수 값의 제곱에 비례합니다.
탈락
드롭아웃은 다소 특이하지만 유용한 기법입니다. 드롭아웃이 적용된 신경망은 훈련 과정 중 일부 유닛이 무작위로 비활성화되어 해당 유닛의 출력 신호가 0이 됩니다. 예를 들어 가중치 배열이 [0.1, 1.7, 0.7, -0.9]라고 가정해 보겠습니다. 드롭아웃이 적용된 신경망은 무작위로 0이 분포된 [0.1, 0, 0, -0.9] 배열이 됩니다. 드롭아웃을 제어하는 매개변수는 드롭아웃 비율입니다. 이 비율은 비활성화되는 유닛의 수를 정의합니다. 일반적으로 0.2에서 0.5 사이의 비율이 많이 사용됩니다.
간단한 인터랙티브 예제를 통해 학습 과정을 쉽게 살펴볼 수 있습니다.
TensorFlow의 신경망 예
다음은 인공 신경망이 일반적인 분류 문제에서 어떻게 작동하는지 보여주는 예시입니다. 입력값은 x1과 x2 두 개이며, 각각 무작위 값을 가집니다. 출력값은 이진 분류입니다. 목표는 두 입력값을 기반으로 레이블을 분류하는 것입니다. 이 작업을 수행하기 위해 신경망 아키텍처는 다음과 같이 정의됩니다.
- 두 개의 숨겨진 레이어
- 첫 번째 레이어에는 XNUMX개의 완전히 연결된 뉴런이 있습니다.
- 두 번째 계층에는 두 개의 완전히 연결된 뉴런이 있습니다.
- 활성화 함수는 ReLU입니다.
- 학습률이 2인 L0.003 정규화를 추가합니다.
이 신경망은 배치 크기 10으로 180 에포크 동안 가중치를 최적화합니다. 아래 ANN 예시 애니메이션에서 시간이 지남에 따라 가중치가 어떻게 변화하고 신경망이 분류 맵을 어떻게 개선하는지 확인할 수 있습니다.ping.

우선, 네트워크는 모든 가중치에 임의의 값을 할당합니다.
- 최적화를 하지 않고 무작위 가중치를 사용했을 때 출력 손실은 0.453입니다. 아래 그림은 네트워크를 서로 다른 색상으로 나타낸 것입니다.
- 일반적으로 주황색은 음수 값을 나타내고 파란색은 양수 값을 나타냅니다.
- 데이터 포인트는 모두 동일한 방식으로 표현됩니다. 파란색은 긍정 레이블이고 주황색은 부정 레이블입니다.

두 번째 은닉층 내부에서 선들은 가중치의 부호에 따라 색이 지정됩니다. 주황색 선은 음의 가중치를, 파란색 선은 양의 가중치를 나타냅니다.
보시는 바와 같이 출력 맵에서ping네트워크가 상당히 많은 오류를 범하고 있습니다. 이제 최적화 후 네트워크가 어떻게 작동하는지 살펴보세요.
아래 인공신경망(ANN) 예시 그림은 최적화된 네트워크의 결과를 보여줍니다. 우선, 네트워크가 데이터 포인트를 분류하는 방법을 성공적으로 학습했음을 알 수 있습니다. 이전 그림과 비교해 보면, 초기 가중치는 -0.43이었지만 최적화 후에는 -0.95가 되었습니다.

이 아이디어는 은닉층과 뉴런 수가 더 많은 네트워크에도 일반화될 수 있습니다. 설정은 직접 실험해 볼 수 있습니다. TensorFlow 플레이그라운드.
아래 설명은 실제 데이터셋을 사용하여 동일한 아이디어를 코드로 구현하는 과정을 보여줍니다.
TensorFlow를 사용하여 신경망을 훈련하는 방법
다음은 신경망을 훈련시키는 단계별 과정입니다. TensorFlow API의 추정기인 DNNClassifier를 사용하는 인공신경망(ANN).
MNIST 데이터세트를 사용하여 첫 번째 신경망을 훈련하겠습니다. 신경망 훈련 TensorFlow 그다지 복잡하지 않습니다. 전처리 단계는 이전 튜토리얼과 완전히 동일합니다. 다음과 같이 진행하시면 됩니다.
- 데이터 가져 오기
- 데이터 변환
- 텐서를 구성하십시오
- 모델 구축
- 모델 학습 및 평가
- 모델 개선
버전 참고: 이 튜토리얼의 코드는 TensorFlow 1.x Estimator API를 대상으로 합니다. tf-estimator 패키지의 최종 릴리스는 TensorFlow 2.15에 포함되었으며, tf.estimator는 TensorFlow 2.16에서 제거되었습니다. 최신 릴리스에서 이 단계를 실행하려면 TensorFlow 2.15 버전을 고정하거나 tf.keras.layers.Dense와 model.fit()을 사용하여 동일한 2계층 네트워크를 다시 빌드하십시오.
1단계) 데이터 가져오기
우선 필요한 라이브러리를 가져와야 합니다. MNIST 데이터셋은 다음 명령어를 사용하여 가져올 수 있습니다. 사이 킷 학습 아래의 TensorFlow 신경망 예제에서 볼 수 있듯이.
MNIST 데이터셋은 새로운 기술이나 알고리즘을 테스트하는 데 가장 일반적으로 사용되는 데이터셋입니다. 이 데이터셋은 0부터 9까지의 손글씨 숫자가 각각 28×28 픽셀 크기로 표시된 이미지들의 모음입니다. 탄성 왜곡(elastic distortion)으로 훈련된 심층 컨볼루션 네트워크들이 이 데이터셋의 테스트 오류를 0.27%까지 낮추는 데 성공했습니다.
import numpy as np
import tensorflow as tf
np.random.seed(1337)
원래의 안내에서는 MNIST 파일을 수동으로 다운로드하고 fetch_mldata가 해당 폴더를 가리키도록 했습니다.
from sklearn.datasets import fetch_mldata
mnist = fetch_mldata(' /Users/Thomas/Dropbox/Learning/Upwork/tuto_TF/data/mldata/MNIST original')
print(mnist.data.shape)
print(mnist.target.shape)
API 참고 사항: mldata.org는 더 이상 온라인 상태가 아니며, fetch_mldata 함수는 scikit-learn 0.22 버전에서 제거되었습니다. 현재 설치된 환경에서는 위의 호출을 fetch_openml('mnist_784', version=1)로 대체하십시오. 이 함수는 동일한 70,000자리 숫자를 다운로드하고 동일한 데이터 및 대상 속성을 표시합니다.
그 후 데이터를 분할하고 두 데이터셋의 형태를 구합니다.
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(mnist.data, mnist.target, test_size=0.2, random_state=42)
y_train  = y_train.astype(int)
y_test  = y_test.astype(int)
batch_size =len(X_train)

print(X_train.shape, y_train.shape,y_test.shape )
2단계) 데이터 변환
이전 튜토리얼에서 이상치의 영향을 줄이기 위해 데이터를 변환해야 한다는 것을 배웠습니다. 이번 신경망 튜토리얼에서는 최소-최대 스케일러를 사용하여 데이터를 변환합니다. 공식은 다음과 같습니다.
(X-min_x)/(max_x - min_x)
scikit-learn에는 이미 MinMaxScaler()라는 함수가 있습니다.
## resclae
from sklearn.preprocessing import MinMaxScaler
scaler = MinMaxScaler()
# Train
X_train_scaled = scaler.fit_transform(X_train.astype(np.float64))
# test
X_test_scaled = scaler.fit_transform(X_test.astype(np.float64))
3단계) 텐서 구성
이제 여러분은 생성 방법을 숙지하셨습니다. 텐서 TensorFlow에서는 학습 데이터셋을 숫자형 열로 변환할 수 있습니다.
feature_columns = [tf.feature_column.numeric_column('x', shape=X_train_scaled.shape[1:])]
4단계) 모델 구축
신경망 구조는 2개의 은닉층으로 이루어져 있으며, 첫 번째 은닉층은 300개의 유닛, 두 번째 은닉층은 100개의 유닛을 가지고 있습니다. 이러한 값들은 공식이 아닌 경험에 의해 결정됩니다. 이 값들을 조정해 보면 신경망의 정확도에 어떤 영향을 미치는지 확인할 수 있습니다.
모델을 구축하려면 DNNClassifier 추정기를 사용합니다. 훈련 데이터 세트에 10개의 클래스가 있으므로 클래스 수를 10으로 설정해야 합니다. 추정기 객체의 구문은 이미 익숙하실 겁니다. feature_columns, n_classes, model_dir 인자는 이전 튜토리얼과 완전히 동일합니다. hidden_units 인자는 새롭게 추가된 인자로, 레이어 수와 각 레이어가 신경망에 연결하는 노드 수를 모두 제어합니다. 아래 코드에서는 두 개의 은닉 레이어가 있으며, 첫 번째 레이어는 300개의 노드에, 두 번째 레이어는 100개의 노드에 연결됩니다.
추정기를 빌드하려면 다음 매개변수와 함께 tf.estimator.DNNClassifier를 사용합니다.
- 기능 열: 네트워크에서 사용할 열을 정의합니다.
- 숨겨진 단위: 은닉 뉴런의 수를 정의하십시오.
- n_클래스: 예측할 클래스의 개수를 정의하세요
- 모델 디렉토리: 경로를 정의하세요 텐서 보드
estimator = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    n_classes=10,
    model_dir = '/train/DNN')
5단계) 모델 학습 및 평가
NumPy의 입력 함수를 사용하여 모델을 학습시키고 평가할 수 있습니다.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_train_scaled},
    y=y_train,
    batch_size=50,
    shuffle=False,
    num_epochs=None)
estimator.train(input_fn = train_input,steps=1000)
eval_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_test_scaled},
    y=y_test,
    shuffle=False,
    batch_size=X_test_scaled.shape[0],
    num_epochs=1)
estimator.evaluate(eval_input,steps=None)
출력:
{'accuracy': 0.9637143,
 'average_loss': 0.12014342,
 'loss': 1682.0079,
 'global_step': 1000}
현재 아키텍처는 평가 세트에서 약 96%의 정확도를 보여줍니다.
6단계) 모델 개선
정규화 매개변수를 추가하여 모델을 개선할 수 있습니다.
여기서 추정기는 드롭아웃 비율이 0.3이고 L1 및 L2 강도가 모두 0.01로 설정된 Proximal AdaGrad 옵티마이저를 사용합니다. TensorFlow 신경망에서 옵티마이저는 `train` 객체 뒤에 옵티마이저 이름을 붙여서 접근할 수 있습니다. TensorFlow는 Proximal AdaGrad 옵티마이저에 대한 내장 API를 제공합니다.
심층 신경망에 정규화를 추가하려면 다음 매개변수를 사용하여 tf.train.ProximalAdagradOptimizer를 사용할 수 있습니다.
- 학습률: 학습_속도
- L1 정규화: l1_정규화_강도
- L2 정규화: l2_정규화_강도
estimator_imp = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    dropout=0.3,
    n_classes = 10,
    optimizer=tf.train.ProximalAdagradOptimizer(
      learning_rate=0.01,
      l1_regularization_strength=0.01,
      l2_regularization_strength=0.01
    ),
    model_dir = '/train/DNN1')
estimator_imp.train(input_fn = train_input,steps=1000)
estimator_imp.evaluate(eval_input,steps=None)
출력:
{'accuracy': 0.95057142,
 'average_loss': 0.17318928,
 'loss': 2424.6499,
 'global_step': 2000}
과적합을 줄이기 위해 선택한 값들이 모델 정확도를 향상시키지 못했습니다. 첫 번째 모델의 정확도는 96%였지만, L2 정규화 항을 적용한 모델의 정확도는 95%입니다. 다른 값들을 시도해보고 정확도에 어떤 영향을 미치는지 확인해 보세요.
