
MongoDB インデックス作成: createIndex() および dropIndex()
 編集チーム
⚡ スマートサマリー
MongoDB インデックスは、コレクションのフィールドの順序付きサブセットを格納するため、クエリはすべてのレコードをスキャンすることなくドキュメントを検索できます。createIndex、getIndexes、およびdropIndexメソッドは、これらのパフォーマンスに重要な構造を構築、一覧表示、および削除します。
何ですか MongoDB インデックス?
インデックスはどのデータベースでも非常に重要です。 MongoDB 違いはありません。インデックスを使用すると、クエリの実行は MongoDB より効率的になります。
インデックスのない数千のドキュメントを含むコレクションがあり、特定のドキュメントを検索するためにクエリを実行する場合、 MongoDB 文書を見つけるにはコレクション全体をスキャンする必要があります。しかし、インデックスがあれば、 MongoDB これらのインデックスを使用して、コレクション内で検索する必要があるドキュメントの数を制限します。
インデックスは、コレクションのデータの一部を格納する特殊なデータセットです。データが部分的であるため、読み取りが容易になります。この部分的なデータセットには、特定のフィールドの値、またはフィールドのセットが、そのフィールドの値に基づいて順序付けられて格納されます。
インデックスの影響を理解する
序論ではインデックスがクエリに有効であることを示しましたが、インデックスが多すぎると、挿入、削除、更新などの他の操作が遅くなる可能性があります。
ドキュメントに対して挿入、削除、更新といった操作が頻繁に行われる場合、インデックスもそれに合わせて頻繁に変更する必要があり、それはコレクションにとって単なるオーバーヘッドとなる。
以下の例は、コレクション内のインデックスを構成するフィールド値を示しています。インデックスは、コレクション内の単一のフィールドに基づいて作成することも、複数のフィールドに基づいて作成することもできます。
以下の例では、従業員ID「1」と従業員Code 「AA」は、コレクション内の文書をインデックス化するために使用されます。そのため、クエリ検索が行われると、これらのインデックスが使用され、コレクション内の必要な文書を迅速かつ効率的に見つけることができます。
検索クエリが従業員に基づいている場合でもCode 「AA」と入力すると、その書類は返却されます。

インデックスの作成方法: createIndex()
インデックスの作成 MongoDB を使用して行われます インデックスの作成 方法。
次の例は、コレクションにインデックスを追加する方法を示しています。ここでは、フィールド名が「Employeeid」と「EmployeeName」である、同じ Employee コレクションがあると仮定します。

db.Employee.createIndex({Employeeid:1})
Code 説明:
- その インデックスの作成 メソッドは、ドキュメントの「Employeeid」に基づいてインデックスを作成するために使用されます。
- 「1」パラメータは、「Employeeid」フィールドの値でインデックスを作成する際に、昇順でソートする必要があることを示します。これは、各ドキュメントを一意に識別する_idフィールドとは異なることに注意してください。 MongoDB 自動的に作成されます。ドキュメントは今後、_idフィールドではなく、従業員IDに基づいてソートされます。
コマンドが正常に実行されると、以下の出力が表示されます。
出力:

- numIndexesBefore: 1 は、コマンド実行前のインデックス内のフィールド値の数を示します。各コレクションには _id フィールドがあり、これもフィールド値としてカウントされるため、numIndexesBefore は 1 になります。
- numIndexesAfter: 2 は、コマンド実行後にインデックスに含まれるフィールド値の数を示します。
- 「ok: 1」という出力は、操作が成功し、新しいインデックスがコレクションに追加されたことを示します。
上記のコードは、1つのフィールド値に基づいてインデックスを作成する方法を示していますが、複数のフィールド値に基づいてインデックスを作成することも可能です。次の例は、その方法を示しています。

db.Employee.createIndex({Employeeid:1, EmployeeName:1})
createIndex メソッドは、複数のフィールド値を考慮するようになりました。これにより、「Employeeid」と「EmployeeName」に基づいてインデックスが作成されます。Employeeid:1 と EmployeeName:1 は、インデックスをこれら 2 つのフィールド値に基づいて作成することを示し、:1 は昇順を表します。これは複合インデックスと呼ばれます。
インデックスの検索方法: getIndexes()
インデックスを見つける MongoDB を使用して行われます インデックスを取得する この方法。以下の例は、その方法を示しています。

db.Employee.getIndexes()
getIndexes メソッドは、コレクション内のすべてのインデックスを検索するために使用されます。
コマンドが正常に実行されると、以下の出力が表示されます。
出力:

出力結果には、コレクション内に_idフィールドとEmployeeidフィールドという2つのインデックスが存在することを示すドキュメントが表示されます。:1は、インデックス内のフィールド値が昇順で作成されることを示しています。
インデックスを削除する方法: dropIndex()
インデックスを削除する MongoDB を使用して行われます ドロップインデックス この方法。以下の例は、その方法を示しています。

db.Employee.dropIndex({Employeeid:1})
dropIndex メソッドは、インデックスから削除する必要のあるフィールド値を指定します。
コマンドが正常に実行されると、以下の出力が表示されます。
出力:
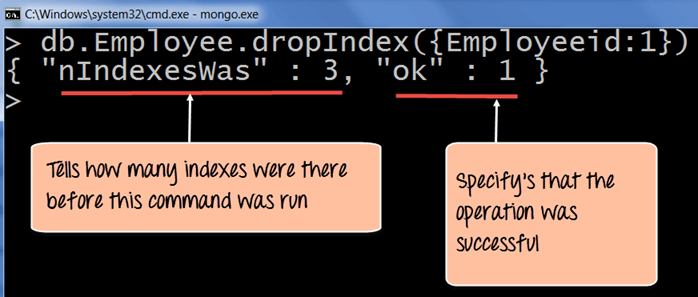
- nIndexesWas: 3 は、コマンド実行前のインデックス内のフィールド値の数を示します。各コレクションには _id フィールドがあり、これもフィールド値としてカウントされます。
- ok: 1 出力は、操作が成功したことを指定し、「Employeeid」フィールドがインデックスから削除されます。
コレクション内のすべてのインデックスを一度に削除するには、dropIndexes コマンドを使用します。次の例は、その方法を示しています。

db.Employee.dropIndexes()
dropIndexes メソッドは、_id インデックスを除くすべてのインデックスを削除します。
コマンドが正常に実行されると、以下の出力が表示されます。
出力:

- nIndexesWas: 2 は、コマンド実行前のインデックス内のフィールド値の数を示します。
- 各コレクションには_idフィールドがあり、これもフィールド値としてカウントされ、削除されません。 MongoDBそれがこのメッセージが示していることです。
- ok: 1 出力は、操作が成功したことを示します。
