
教師あり機械学習: Algorithms、種類と例
 エブリン・クラーク
⚡ スマートサマリー
教師あり機械学習は、ラベル付けされたサンプルを用いてアルゴリズムを訓練し、これまで見たことのないデータに対しても結果を予測できるようにします。数値的な対象には回帰分析を、スパムや詐欺などのカテゴリ的な対象には分類分析を用います。
教師あり機械学習とは?
教師あり機械学習とは、ラベル付けされた訓練データから学習し、未知のデータの予測に役立つアルゴリズムです。教師あり学習では、適切に「ラベル付け」されたデータを使用して機械を訓練します。つまり、一部のデータにはすでに正解がタグ付けされているということです。これは、監督者や教師の存在下での学習に例えることができます。
精度の高い教師あり機械学習モデルを構築、拡張、展開するには、高度なスキルを持つデータサイエンティストのチームによる時間と技術的な専門知識が必要です。また、データサイエンティストは、基となるデータが変化しても、モデルから得られる知見が常に正しい状態を保つよう、定期的にモデルを再構築する必要があります。
教師あり学習の仕組み
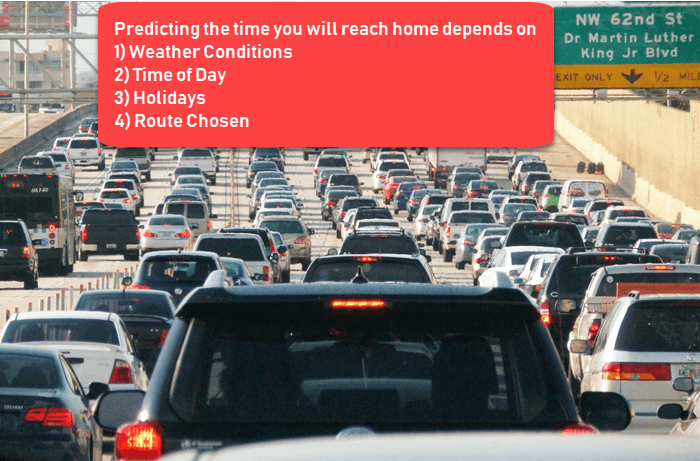
教師あり機械学習では、トレーニング データ セットを使用して、望ましい結果を達成します。 これらのデータ セットには、モデルの学習を高速化するのに役立つ入力と正しい出力が含まれています。 たとえば、職場から車で帰宅するまでにかかる時間を予測できるようにマシンをトレーニングしたいとします。
ここでは、ラベル付きデータのセットを作成することから始めます。 このデータには次のものが含まれます。
- 気象条件
- 時刻
- クリスマス・その他
- 選択されたルート
これらの詳細はすべて、この教師あり学習の例における入力値です。出力値は、下の画像に示すように、その特定の日に自宅まで車で帰るのにかかった時間です。
外が雨なら、家に帰るのに時間がかかることは、本能的にわかる。しかし、機械にはデータと統計が必要なのだ。
まず最初に作成する必要があるのは、トレーニングセットです。これには、通勤時間の合計と、天候や時間帯などの関連要因が含まれます。このトレーニングセットに基づいて、機械学習システムは、降雨量と帰宅時間の間に直接的な関係があることを認識する可能性があります。
つまり、雨が降れば降るほど、家に帰るまでの運転時間が長くなるということです。また、仕事が終わる時間と運転時間の関係も把握できるかもしれません。午後6時が近づくほど、家に帰るのに時間がかかるということです。
お使いのマシンは、ラベル付けされたデータとの関連性の一部を発見する可能性があります。その学習段階を以下に示します。
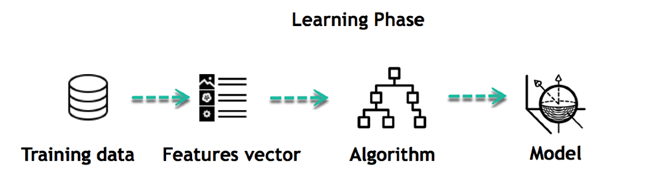
これがデータモデルの始まりです。雨が人々の運転行動にどのような影響を与えるか、また特定の時間帯に多くの人が移動するといった情報を記録し始めます。
教師あり機械学習の種類 Algorithms
教師あり機械学習アルゴリズムの種類は次のとおりです。
不具合
回帰分析手法は、訓練データを用いて単一の連続的な出力値を予測する。
例: 回帰を使用して、トレーニング データから住宅価格を予測できます。 入力変数は、地域、家のサイズなどになります。
長所:出力結果が解釈しやすく、アルゴリズムを正則化することで過学習を回避できる。
弱点:線形モデルは柔軟性に欠けるため、追加機能なしでは複雑な関係性を捉えることができない。
ここではいくつかのタイプの回帰を示します Algorithms:
- 線形回帰
- 多項式回帰
- リッジ回帰とラッソ回帰
- ロジスティック回帰(分類用)
- 決定木とランダムフォレスト回帰
- サポートベクター回帰
ロジスティック回帰:
ロジスティック回帰は、与えられた独立変数に基づいて離散値を推定するために使用されます。データをロジット関数に当てはめることで、事象の発生確率を予測するのに役立ちます。そのため、ロジット回帰とも呼ばれます。確率を予測するため、出力値は0から1の間になりますが、複数の決定境界や非線形の決定境界が存在する場合には、性能が低下する可能性があります。
欠陥種類の識別
分類とは、出力をクラス内にグループ化することです。アルゴリズムが入力を2つの異なるクラスに分類しようとする場合、それは二値分類と呼ばれます。3つ以上のクラスから選択する場合は、多クラス分類と呼ばれます。
例:ローンの債務不履行者になるかどうかを判断する。
長所:分類木は実用上非常に優れた性能を発揮する。
弱点:制約のない個々のツリーは過学習を起こしやすい。
ここではいくつかの種類の分類を示します Algorithms:
- 単純ベイズ分類器
- 決定木
- サポートベクターマシン
- K最近傍法
- ランダムフォレストと勾配ブースティング
単純ベイズ分類器
その ナイーブベイズ このモデルは構築が容易で、大規模なデータセットに非常に有効です。この手法は、1つの親ノードと複数の子ノードを持つ有向非巡回グラフで構成されています。子ノードは親ノードから独立していると仮定しています。
決定木
決定木は、特徴値に基づいてインスタンスを分類します。この手法では、各ノードは分類対象となるインスタンスの特徴を表し、各枝はノードが取り得る値を表します。これは分類において広く用いられている手法です。
回帰分析にも同じ構造が当てはまります。回帰ツリーは、実際の値(車の購入費用、通話回数、月間総売上高など)を推定するのに役立ちます。
サポートベクターマシン
サポートベクターマシン(SVM)は、1990年代に登場した学習アルゴリズムの一種です。この手法は、ウラジミール・ヴァプニクとその同僚によって開発された統計的学習理論に基づいています。
SVMはカーネル関数とも密接に関連しており、カーネル関数はほとんどの学習タスクの中心概念です。カーネルフレームワークとSVMはさまざまな分野で使用されています。これには、マルチメディア情報検索、バイオインフォマティクス、パターン認識などが含まれます。上記の各推定器は、チューニングパラメータとともにドキュメント化されています。 scikit-学ぶ 参照。
教師あり学習と教師なし学習の機械学習手法
メソッドを横に配置する 教師なし学習 その境界を明確にする。
| に基づく | 教師あり機械学習手法 | 教師なし機械学習手法 |
|---|---|---|
| 入力データ | Algorithms ラベル付きデータを使用してトレーニングされます。 | Algorithms ラベルの付いていないデータに対して使用される |
| 計算の複雑さ | 教師あり学習はより簡単な方法です。 | 教師なし学習は計算が複雑である |
| 精度 | 精度が高く信頼できる手法です。 | Less 正確かつ信頼できる方法。 |
| 典型的なアルゴリズム | ロジスティック回帰、決定木、SVM、ナイーブベイズ | K平均法、階層的クラスタリング、PCA |
| 結果の評価方法 | 既知の解答との比較によるスコア(正答率、RMSE) | 内部基準と人的評価に基づいて判断 |
教師あり機械学習における課題
教師あり機械学習で直面する課題は次のとおりです。
- トレーニングデータ内の無関係な入力特徴は、不正確な結果を生み出す可能性がある。
- データの準備と前処理は常に課題です。
- 不可能な値、あり得ない値、不完全な値がトレーニングデータとして入力されると、精度が低下する。
- 該当する専門家が見つからない場合は、別の方法として「総当たり」方式が用いられます。これは、機械学習にどの特徴量(入力変数)を用いるべきかを推測する必要があり、その推測は不正確である可能性があります。
教師あり学習の利点
こうした課題を踏まえると、教師あり機械学習の利点は以下のとおりです。
- 教師あり学習 機械学習 過去の経験からデータを収集したり、データ出力を作成したりすることができます
- 経験を活用してパフォーマンス基準を最適化するのに役立ちます
- 教師あり機械学習は、現実世界のさまざまな種類の計算問題を解決するのに役立ちます。
教師あり学習の欠点
教師あり機械学習の欠点は以下のとおりです。
- トレーニングセットにクラスに含めたい例が含まれていない場合、決定境界が過学習している可能性があります。
- 分類器をトレーニングする際には、各クラスから多くの良い例を選択する必要があります。
- ビッグデータの分類は、非常に困難な作業となる可能性がある。
- 教師あり学習のトレーニングには多くの計算時間が必要です。
指導付き学習のベストプラクティス
次のシーケンスはプロジェクトを維持します track:
- 何よりもまず、トレーニングセットとして使用するデータの種類を決定してください。
- 学習する関数の構造と学習アルゴリズムを決定する。
- 人間の専門家または測定値から対応する出力を収集する。
- モデルが決して見ないテストセットを保留し、そのスコアを報告する。
