
シェルソートアルゴリズム(例付き)
 サラ・チェン

シェルソートとは何ですか?
シェルソート(シェル法とも呼ばれる)は、効率的なインプレース比較ベースのソートアルゴリズムである。1959年にこのアイデアを提唱したドナルド・シェルにちなんで名付けられたこのアルゴリズムは、挿入ソートの一般化拡張であり、散在データに対する二次的な計算量の問題を克服している。
基本的な考え方は、離れた要素をグループ化し、挿入ソートを用いて各グループをソートし、ギャップを段階的に縮小していき、最終的に1に近づけるというものです。そうすれば、配列はほぼソートされた状態になります。
このギャップ、つまり間隔は、シェルのオリジナル、クヌース、ヒバード、セジウィックなどの選択されたシーケンスに従います。シェルのオリジナルは n/2, n/4, ..., 1.
シェルソートアルゴリズム
ステップ1) 配列のサイズをnとしたとき、区間値hをh = n/2で初期化します。
ステップ2) 区間hからの距離内にあるすべての要素をサブリストに格納します。
ステップ3) 各サブリストを挿入ソートを使用してソートします。
ステップ4) 新しい区間 h = h/2 を設定します。
ステップ5) h > 0 の場合は、ステップ 2 に戻ります。そうでない場合は、ステップ 6 に進みます。
ステップ6) 結果として得られた配列は完全にソートされています。
シェルソートの仕組み
挿入ソートでは、要素は一度に1つずつしか移動しません。一方、シェルソートは、配列を間隔に基づいて広く間隔を空けたサブリストに分割し、各サブリストに対して挿入ソートを実行します。
間隔が小さくなるにつれて、サブリストのサイズは大きくなります。以前のパスでデータが部分的にソートされているため、間隔が小さいほど、実行時よりもはるかに少ないスワップで済みます。 挿入ソート ゼロから始めます。下の図は、シェルソートの1回のパスを示しています。

シェルソートアルゴリズムの動作例
以下の配列をシェルソートを使ってソートしてみましょう。

ステップ1) 配列のサイズは8なので、初期区間値はh = 8/2 = 4です。
ステップ2) 4文字離れた要素をグループ化します。サブリスト: {8, 1}, {6, 4}, {7, 5}, {2, 3}。

ステップ3) 各サブリストを挿入ソートでソートします。要素が移動する間、一時変数に挿入される値を保持します。スワップ後、配列は次のようになります。

ステップ4) 間隔を狭めます。新しい間隔は h = 4/2 = 2 です。
ステップ5) 2 > 0 なので、ステップ 2 に戻り、2 つ離れた要素をグループ化します: {1, 5, 8, 7} と {4, 2, 6, 3}。

最初のサブリストをソートします。配列は次のようになります。
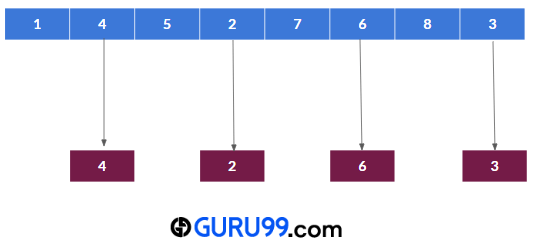
2番目のサブリストをソートした後:

間隔を再び縮小して h = 2/2 = 1 にします。間隔が 1 の場合、シェルソートは以下に示すように、配列全体に対して最終的な挿入ソート処理を実行します。


ステップ6) 区間を再度分割すると0になります。これで配列は完全にソートされました。
擬似-Code シェルソート用
Start
Input array a of size n
for (interval = n / 2; interval > 0; interval /= 2)
    for (i = interval; i < n; i += 1)
        temp = a[i];
        for (j = i; j >= interval && a[j - interval] > temp; j -= interval)
            a[j] = a[j - interval];
        a[j] = temp;
End
C言語のシェルソートプログラム/C++
入力:
//Shell Sort Program in C/C++
#include <bits/stdc++.h>
using namespace std;
void ShellSort(int data[], int size) {
    for (int interval = size / 2; interval > 0; interval /= 2) {
        for (int i = interval; i < size; i += 1) {
            int temp = data[i];
            int j;
            for (j = i; j >= interval && data[j - interval] > temp; j -= interval) {
                data[j] = data[j - interval];
            }
            data[j] = temp;
        }
    }
}
int main() {
    int data[] = {8, 6, 7, 2, 1, 4, 5, 3};
    int size = sizeof(data) / sizeof(data[0]);
    ShellSort(data, size);
    cout << "Sorted Output: \n";
    for (int i = 0; i < size; i++)
        cout << data[i] << " ";
    cout << "\n";
}
出力:
Sorted Output:

1 2 3 4 5 6 7 8
シェルソートの例 Python
入力:
#Shell Sort Example in Python
def ShellSort(data, size):
    interval = size // 2
    while interval > 0:
        for i in range(interval, size):
            temp = data[i]
            j = i
            while j >= interval and data[j - interval] > temp:
                data[j] = data[j - interval]
                j -= interval
            data[j] = temp
        interval //= 2
data = [8, 6, 7, 2, 1, 4, 5, 3]
ShellSort(data, len(data))
print('Sorted Output:')
print(data)
出力:
Sorted Output:
[1, 2, 3, 4, 5, 6, 7, 8]
シェルソートの応用例
シェルソートは、スタック容量やシンプルさが重要な現代のシステムでも依然として使用されています。
- その Linuxカーネル 呼び出しスタックを回避することが重要な箇所では、シェルソートを使用します。
- uClibc組み込みCライブラリは、メモリ使用量を抑えるためにシェルソートを使用しています。
- bzip2は、ブロックソート中の深い再帰を回避するためにシェルソートを使用します。
- 組み込みファームウェアは、再帰が制限される小規模なデータセットに対して、シェルソートを優先的に使用します。
シェルソートの利点と欠点
| 優位性 | デメリット |
|---|---|
| コールスタックは不要なので、組み込みシステムには最適です。 | 非常に大きな配列の場合、最速の選択肢ではありません。 |
| 少量のコードで簡単に実装できます。 | 要素が広範囲に分散しているデータでは、パフォーマンスが低下します。 |
| 中規模または部分的にソートされた配列に対して効率的です。 | 最悪の場合の時間計算量は、選択されたギャップシーケンスに大きく左右される。 |
| インプレース方式なので、補助メモリを常に一定量使用します。 | これは安定ソートではないため、同じキーを持つキーの相対的な順序が変わる可能性があります。 |
シェルソートの複雑性分析
シェルソートの時間計算量
シェルソートの時間計算量は、使用するギャップシーケンスに依存します。
最良の場合、配列がほぼ整列しているときは、各パスに必要なテストの回数は対数で済み、O(n log n) となります。
最悪の場合、配列は要素が最大の比較を必要とするように配置され、最後のインクリメントはシェルの元のシーケンスでO(n^2)で支配的になります。
- 最良の場合の計算量:O(n log n)
- 平均的なケースの複雑さ:ギャップシーケンスに応じてO(n log n)からO(n^(4/3))
- 最悪の場合の計算量:シェルの元のシーケンスではO(n^2)
汎用性の高い最適なギャップ配列は依然として未解決の研究課題であるが、セジウィック配列とシウラ配列は実際には良好な性能を発揮する。
シェルソートの空間計算量
シェルソートは補助配列を必要としないため、入力サイズに関係なく空間計算量はO(1)となり、これはシェルソートの最も強力な実用的な利点の1つです。
