
MongoDB Order By の例を使用した Sort() および Limit() クエリ
 スティーブン・トウェイン
⚡ スマートサマリー
MongoDB sort() および limit() クエリ修飾子は、クエリが返すドキュメントの数と順序を制御します。limit() メソッドは結果の件数を制限し、sort() メソッドは 1 または -1 の値を使用してドキュメントを昇順または降順に並べ替えます。

クエリの変更とは何ですか?
Mongo DB クエリを実行する際の柔軟性を高めるために、「limit」や「Orders」句などのクエリ修飾子が用意されています。次のクエリ修飾子を見てみましょう。
MongoDB クエリ結果を制限する
この修飾子は、クエリの結果セットで返されるドキュメントの数を制限するために使用されます。次の例は、これを実行する方法を示しています。
db.Employee.find().limit(2).forEach(printjson);
Code 説明
- 上記のコードは、コレクション内のすべてのドキュメントを返す find 関数を使用しますが、limit 句を使用して、返されるドキュメントの数を 2 つに制限します。
出力
コマンドが正常に実行されると、次の出力が表示されます。
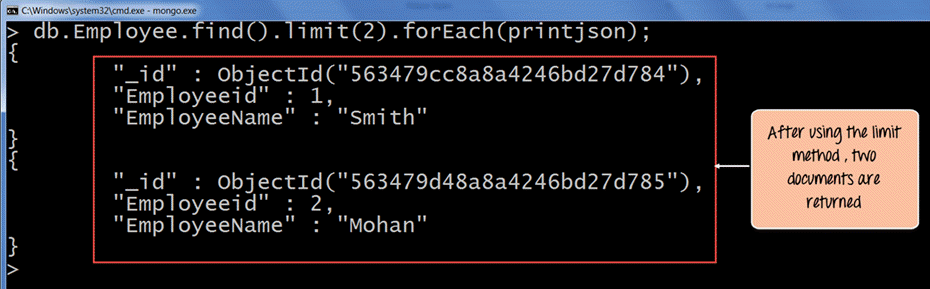
出力は、limit 修飾子があるため、ObjectId に基づいて昇順で結果セットの一部として最大 2 つのレコードだけが返されることを明確に示しています。
MongoDB 降順で並べ替え
コレクション内の任意のキーの昇順または降順に基づいて、返されるドキュメントの順序を指定できます。次の例は、これを実行する方法を示しています。
db.Employee.find().sort({Employeeid:-1}).forEach(printjson)
Code 説明
- 上記のコードは、コレクション内のすべてのドキュメントを返すsort関数を使用しますが、修飾子を使用してレコードが返される順序を変更します。 ここで、-1 は、従業員 ID の降順に基づいてドキュメントを返すことを示します。
コマンドが正常に実行されると、次の出力が表示されます。
出力

出力には、Employeeid の降順で返されるドキュメントが明確に示されています。
昇順は値 1 で定義されます。
MongoDB 昇順で並べ替え
sort() 関数は、ドキュメントを降順で返すことができるのと同様に、昇順で返すこともできます。昇順は、sort オブジェクトの値 1 によって定義されます。これにより、ドキュメントは最小値から最大値へと並べられ、古いレコードから新しいレコード、または A から Z の順にリスト表示する場合に役立ちます。
次の例では、すべての従業員ドキュメントを従業員IDの昇順でソートします。
db.Employee.find().sort({Employeeid:1}).forEach(printjson)
クエリの仕組みは以下のとおりです。
- find() は、Employee コレクション内のすべてのドキュメントを取得します。
- sort({Employeeid:1}) は、Employeeid フィールドに基づいて、ID が小さい順から大きい順に結果を並べ替えます。
- forEach(printjson) は、各ドキュメントを読みやすい JSON 形式で出力します。
このコマンドを実行すると、ドキュメントは従業員IDの昇順で表示されます。昇順はデフォルトの方向でもあるため、値を1のままにしておくと、選択したフィールドで低い順から高い順になります。結果を反転させるには、値を1から-1に変更するだけです。また、limit() 関数を連結して、ソートされた最初の数件のレコードのみを返すこともできます。
MongoDB ページネーションのスキップ()
skip() メソッドは、 MongoDB 指定された数のドキュメントを無視してから、残りのドキュメントを返します。skip() 単体ではあまり役に立ちませんが、limit() と組み合わせることでページネーションが実現し、結果を一度に 1 ページずつ表示できます。
次の例では、最初の2人の従業員をスキップして、次の2人を返します。
db.Employee.find().skip(2).limit(2).forEach(printjson)
ページごとのナビゲーションを作成するには、次のパターンに従ってください。
- ページサイズを決定します。例えば、1ページに2つの文書を配置するなどです。
- スキップ値を求めるには、ページサイズにページ番号から1を引いた値を掛けます。
- skip() にその値を渡し、limit() にページサイズを渡します。
例えば、ページ 1 では skip(0).limit(2) を使用し、ページ 2 では skip(2).limit(2) を使用し、ページ 3 では skip(4).limit(2) を使用します。ドキュメントの順序がページ間で安定するように、必ず sort() も追加してください。非常に大きな skip 値は、大きなコレクションでは遅くなる可能性があることに注意してください。 MongoDB スキップされたドキュメントも引き続きスキャンして破棄しますが、範囲ベースのページネーションは大規模な場合にはより高速です。
複数のフィールドで並べ替え MongoDB
MongoDB 一度に複数のフィールドでソートできます。ソートオブジェクトにフィールドを優先順位順にリストし、 MongoDB 最初のフィールドでソートし、次に次のフィールドを使用して同順位を解消し、以下同様に続けます。
次の例では、従業員を名前の昇順で並べ替え、同名の従業員については従業員IDの降順で並べ替えます。
db.Employee.find().sort({EmployeeName:1, Employeeid:-1}).forEach(printjson)
ソートオブジェクト内のキーの順序は重要です。EmployeeName は最初に表示されるため、最初に適用されます。この複数キーによるソートは、1 つのフィールドでグループ化し、各グループ内で順位付けを行うレポートに役立ちます。大規模なコレクションで最高のパフォーマンスを得るには、ソートで使用されるフィールドと方向に一致する複合インデックスを作成してください。
