
機械学習におけるガウスカーネル: Python カーネルメソッド
 編集チーム
⚡ スマートサマリー
ガウスカーネル法は、高次元特徴マップを構築することなく、分離不可能なデータを線形分離可能にします。このチュートリアルでは、多項式マップを示します。ping 手動でモデルを作成し、その後TensorFlowでランダムフーリエカーネル分類器をトレーニングします。
このチュートリアルの目的は、データセットを線形分離可能にすることです。 チュートリアルは XNUMX つの部分に分かれています。
- 特徴変換
- TensorFlowを使用してカーネル分類器をトレーニングする
最初のパートでは、機械学習におけるカーネル法の背後にある考え方を理解し、2番目のパートではカーネル分類器をトレーニングする方法を見ていきます。 TensorFlow成人データセットを使用します。このデータセットの目的は、各世帯の行動パターンを把握した上で、収入が5万ドル未満と5万ドル以上を分類することです。
なぜカーネルメソッドが必要なのでしょうか?
すべての分類器の目的は、クラスを正しく予測することです。そのためには、データセットは分離可能である必要があります。下のグラフを見てください。黒線より上の点はすべて第1クラスに属し、それ以外の点は第2クラスに属していることが容易にわかります。しかし、このように単純なデータセットは非常にまれです。ほとんどの場合、データは分離不可能であり、分離不可能なデータは、ロジスティック回帰のような単純な分類器にとって大きな課題となります。
import numpy as np
  import matplotlib.pyplot as plt
  from mpl_toolkits.mplot3d import Axes3D
  x_lin = np.array([1,2,3,4,5,6,7,8,9,10])
  y_lin = np.array([2,2,3,2,2,9,6,8,8,9])
  label_lin = np.array([0,0,0,0,0,1,1,1,1,1])

  fig = plt.figure()
  ax=fig.add_subplot(111)
  plt.scatter(x_lin, y_lin, c=label_lin, s=60)
  plt.plot([-2.5, 10], [12.5, -2.5], 'k-', lw=2)
  ax.set_xlim([-5,15])
  ax.set_ylim([-5,15])plt.show()

下の図は、線形分離できないデータセットを示しています。直線を引くと、ほとんどの点が正しいクラスに分類されません。
この問題を解決する一つの方法は、データセットを取り出し、データを別の特徴マップに変換することです。つまり、関数を使ってデータを別の平面(線形分離可能な平面)に移動させるということです。
x = np.array([1,1,2,3,3,6,6,6,9,9,10,11,12,13,16,18])
y = np.array([18,13,9,6,15,11,6,3,5,2,10,5,6,1,3,1])
label = np.array([1,1,1,1,0,0,0,1,0,1,0,0,0,1,0,1])
fig = plt.figure()
plt.scatter(x, y, c=label, s=60)
plt.show()
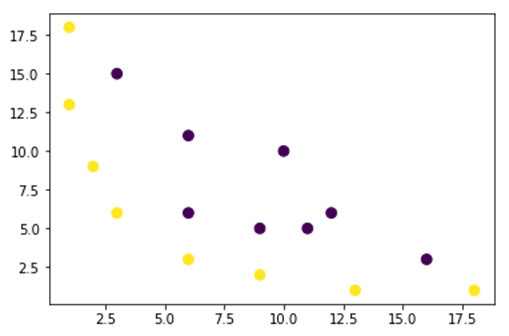
上の図のデータは2次元平面上にあり、分離できません。このデータを3次元に変換することで、3つの軸を持つ図を作成できます。
ガウスカーネルの例では、多項式マップを適用します。ping データを3次元に変換します。データ変換の式は以下のとおりです。

ガウスカーネルで関数を定義する Python 新しいフィーチャマップを作成する。
あなたが使用することができます NumPy 上記の数式をコード化します。以下の各行は、マップの1つの項をペアにしています。ping それを生成する配列式とともに、小さな画像は2の平方根の因数を示しています。
| 式 | 同等のNumPyコード |
|---|---|
| x | x[:,0] |
| y | x[:,1] |
| x² | x[:,0]**2 |
 |
np.sqrt(2)* |
| xy | x[:,0]*x[:,1] |
| y² | x[:,1]**2 |
### illustration purpose
def mapping(x, y):
	x = np.c_[(x, y)]
    if len(x) >	2:
    	x_1 = x[:,0]**2
        x_2 = np.sqrt(2)*x[:,0]*x[:,1]
        x_3 = x[:,1]**2
    else:
    	x_1 = x[0]**2
        x_2 = np.sqrt(2)*x[0]*x[1]
        x_3 = x[1]**2
   trans_x = np.array([x_1, x_2, x_3])
   return trans_x
新しいマップping 3次元で16個の点を持つ。
x_1  = mapping(x, y)
x_1.shape
(3, 16)
次に、x軸、y軸、z軸の3つの軸を持つ新しいグラフを作成します。
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[2], c=label, s=60)
ax.view_init(30, 185)ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')
plt.show()

改善が見られるが、プロットの向きを変えると、データセットが分離可能になったことが明らかになる。
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[1], c=label, s=60)
ax.view_init(0, -180)ax.set_ylim([150,-50])
ax.set_zlim([-10000,10000])
ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')plt.show()

大規模なデータセットを操作して2次元を超えるデータを作成する必要がある場合、上記の方法では大きな問題に直面します。実際には、すべてのデータポイントを変換する必要があり、これは明らかに持続可能な方法ではありません。処理に膨大な時間がかかり、コンピュータのメモリが不足する可能性があります。
この問題を解決する最も一般的な方法は、カーネルを使用することです。
機械学習におけるカーネルとは何ですか?
そのアイデアは、上の図に示すように、より高次元の特徴空間を使用してデータをほぼ線形分離可能にすることです。
データ点を分離可能にする高次元空間は数多く存在する。例えば、多項式写像はping 素晴らしいスタートです。
また、データ量が多い場合、これらの変換は効率的ではないことも実証しました。その代わりに、機械学習のカーネル関数を使用することで、新しい特徴平面に移行することなくデータを変更できます。
カーネルの真髄は、高次元計算に伴うあらゆる問題を回避できる関数を見つけることにある。カーネルの結果はスカラー値、つまり一次元空間に戻るということだ。
この関数を見つけたら、それを標準の線形分類器に組み込むことができます。
カーネル機械学習の概念を具体的に示す例を以下に示します。2つのベクトルx1とx2があります。目的は、多項式マップを使用してより高次元のベクトルを作成することです。ping出力は新しい特徴マップのドット積に等しくなります。上記の方法から、次の操作を行う必要があります。
- x1 と x2 を新しい次元に変換します
- ドット積の計算: すべてのカーネルに共通
x1 と x2 を新しい次元に変換します
上で作成した関数を使用して、より高い次元を計算できます。
## Kernel
x1 = np.array([3,6])
x2 = np.array([10,10])

x_1 = mapping(x1, x2)
print(x_1)
出力
[[  9.         100.        ]
      [ 25.45584412 141.42135624]
      [ 36.         100.        ]]
ドット積を計算する
オブジェクトドットを使用できます NumPy x_1に格納されている最初のベクトルと2番目のベクトルの内積を計算します。
print(np.dot(x_1[:,0], x_1[:,1]))
8100.0
出力は8100です。問題点はお分かりでしょう。ドット積を計算するために、新しい特徴マップをメモリに保存する必要があるのです。数百万件のレコードを含むデータセットの場合、これは計算効率が非常に悪くなります。
代わりに、多項式カーネルを使用して、ベクトルを変換せずに内積を計算できます。この関数は、x1とx2の内積を、あたかもこれらの2つのベクトルが高次元に変換されたかのように計算します。言い換えれば、カーネル関数は、別の特徴空間から内積の結果を計算します。
多項式カーネル関数は次のように記述できます。 Python 以下のとおりです。
def polynomial_kernel(x, y, p=2):
	return (np.dot(x, y)) ** p
これは XNUMX つのベクトルの内積のべき乗です。 以下では、多項式カーネルの XNUMX 次を返します。 出力は他の方法と同じです。 これがカーネルの魔法です。
polynomial_kernel(x1, x2, p=2)
8100
カーネルメソッドの種類
カーネルにはさまざまな手法があります。最も単純なのは線形カーネルです。この関数はテキスト分類に非常に有効です。その他のカーネルは次のとおりです。
- 多項式カーネル
- ガウス カーネル
以下の表は、それぞれの機能と、医療従事者がどのような状況でそれらを使用するのかをまとめたものです。
| カーネル | 計算内容 | 典型的な使用 |
|---|---|---|
| 線形 | 元のフィーチャー空間における単純なドット積 | 既に分離可能なデータと高次元テキスト特徴 |
| 多項式 | ドット積をp次数まで上げることで、特徴間の相互作用を捉える。 | 相互作用が重要であることがわかっている場合の曲線境界 |
| ガウス分布(RBF) | 距離に基づく類似度で、点が離れるにつれてゼロに近づく。 | 境界形状が不明な場合の一般的な第一選択肢 |
TensorFlow の例では、ランダムフーリエ特徴量を使用します。TensorFlow には、新しい特徴空間を計算するための組み込みの推定器があります。ランダムフーリエ特徴量マッパーは、以下に示すガウスカーネル関数の近似です。

ガウス フィルター関数は、より高次元の空間におけるデータ ポイント間の類似性を計算します。
理論が確立されたところで、このチュートリアルの残りの部分では、ガウスカーネルを実際のデータセットに適用してみます。
TensorFlow を使用してガウス カーネル分類器をトレーニングする
アルゴリズムの目的は、世帯収入が 50 を超えるか、またはそれ以下かを分類することです。
まず、ベンチマークモデルとしてロジスティック回帰を評価します。その後、カーネル分類器を訓練して、より良い結果が得られるかどうかを確認します。
成人データセットから次の変数を使用します。
- 年齢
- ワーククラス
- fnlwgt
- 教育
- 教育番号
- 夫婦の
- 職業
- 関係
- レース
- セックス
- 資本利得
- 資本損失
- 時間_週
- 母国
- ラベル
モデルのトレーニングと評価を行う前に、以下の手順に従ってください。
- ライブラリをインポートする
- データをインポートする
- データを準備する
- ロジスティックモデルの構築:ベースラインモデル
- モデルを評価する
- カーネル分類器を構築し、評価する
バージョンノート: 以下のコードスニペットはすべて TensorFlow 1.x を対象としています。real_valued_column、RandomFourierFeatureMapper、KernelLinearClassifier を提供する tf.contrib 名前空間は TensorFlow 2.0 で削除され、tf.estimator 自体も TensorFlow 2.16 で削除されました。最新リリースでは、tf.keras.layers.experimental.RandomFourierFeatures レイヤーの後に Dense 出力レイヤーを追加するか、scikit-learn の RBFSampler と SGDClassifier のペアを使用して、同じパイプラインを構築してください。
ステップ 1) ライブラリをインポートする
カーネル モデルをインポートしてトレーニングするには Artificial IntelligenceTensorFlowをインポートする必要があります。 パンダ そしてNumPy。
#import numpy as np
from sklearn.model_selection
import train_test_split
import tensorflow as tf
import pandas as pd
import numpy as np
ステップ 2) データをインポートする
データをダウンロードします UCI成人データセットページ そして、それをpandas DataFrameとしてインポートします。
## Define path data
COLUMNS = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital', 'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss', 'hours_week', 'native_country', 'label']
PATH = "https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.data"
PATH_test ="https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.test
"## Import
df_train = pd.read_csv(PATH, skipinitialspace=True, names = COLUMNS, index_col=False)
df_test = pd.read_csv(PATH_test,skiprows = 1, skipinitialspace=True, names = COLUMNS, index_col=False)
トレーニングセットとテストセットが定義されたので、列ラベルを文字列から整数に変更できます。TensorFlowはラベルに文字列値を受け付けません。
label = {'<=50K': 0,'>50K': 1}
df_train.label = [label[item] for item in df_train.label]
label_t = {'<=50K.': 0,'>50K.': 1}
df_test.label = [label_t[item] for item in df_test.label]
df_train.shape
(32561, 15)
ステップ3) データを準備する
このデータセットには、連続変数とカテゴリ変数の両方が含まれています。連続変数の値を標準化するのが良い方法です。StandardScaler 関数を使用できます。 scikit-学ぶまた、トレーニングセットとテストセットの変換を容易にするために、ユーザー定義関数を作成します。連続変数とカテゴリ変数を共通のデータセットに連結し、配列の型をfloat32にすることに注意してください。
COLUMNS_INT = ['age','fnlwgt','education_num','capital_gain', 'capital_loss', 'hours_week']
CATE_FEATURES = ['workclass', 'education', 'marital', 'occupation', 'relationship', 'race', 'sex', 'native_country']
from sklearn.preprocessing import StandardScaler
from sklearn import preprocessing

def prep_data_str(df):
	scaler = StandardScaler()
    le = preprocessing.LabelEncoder()
    df_toscale = df[COLUMNS_INT]
    df_scaled = scaler.fit_transform(df_toscale.astype(np.float64))
    X_1 = df[CATE_FEATURES].apply(le.fit_transform)
    y = df['label'].astype(np.int32)
    X_conc = np.c_[df_scaled, X_1].astype(np.float32)
    return X_conc, y
変換関数が準備できたので、データセットを変換してinput_fn関数を作成できます。
X_train, y_train = prep_data_str(df_train)
X_test, y_test = prep_data_str(df_test)
print(X_train.shape)
(32561, 14)
次のステップでは、ロジスティック回帰をトレーニングします。 ベースラインの精度が得られます。 目的は、別のアルゴリズム、つまりカーネル分類子を使用してベースラインを上回ることです。
ステップ 4) ロジスティック モデルの構築: ベースライン モデル
オブジェクト real_valued_column を使用して特徴列を構築します。 すべての変数が高密度の数値データであることが確認されます。
feat_column = tf.contrib.layers.real_valued_column('features', dimension=14)
推定器はTensorFlow Estimator APIを使用して定義されます。特徴量の列とグラフの保存場所を指定します。
estimator = tf.estimator.LinearClassifier(feature_columns=[feat_column],
                                          n_classes=2,
                                          model_dir = "kernel_log"
                                         )
INFO:tensorflow:Using default config.INFO:tensorflow:Using config: {'_model_dir': 'kernel_log', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a2003f780>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
ロジスティック回帰の学習には、200個のデータからなるミニバッチを使用します。
# Train the model
train_input_fn = tf.estimator.inputs.numpy_input_fn(
	x={"features": X_train},
    y=y_train,
    batch_size=200,
    num_epochs=None,
    shuffle=True)
モデルは1,000回の反復で学習させることができます。
estimator.train(input_fn=train_input_fn, steps=1000)
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into kernel_log/model.ckpt.
INFO:tensorflow:loss = 138.62949, step = 1
INFO:tensorflow:global_step/sec: 324.16
INFO:tensorflow:loss = 87.16762, step = 101 (0.310 sec)
INFO:tensorflow:global_step/sec: 267.092
INFO:tensorflow:loss = 71.53657, step = 201 (0.376 sec)
INFO:tensorflow:global_step/sec: 292.679
INFO:tensorflow:loss = 69.56703, step = 301 (0.340 sec)
INFO:tensorflow:global_step/sec: 225.582
INFO:tensorflow:loss = 74.615875, step = 401 (0.445 sec)
INFO:tensorflow:global_step/sec: 209.975
INFO:tensorflow:loss = 76.49044, step = 501 (0.475 sec)
INFO:tensorflow:global_step/sec: 241.648
INFO:tensorflow:loss = 66.38373, step = 601 (0.419 sec)
INFO:tensorflow:global_step/sec: 305.193
INFO:tensorflow:loss = 87.93341, step = 701 (0.327 sec)
INFO:tensorflow:global_step/sec: 396.295
INFO:tensorflow:loss = 76.61518, step = 801 (0.249 sec)
INFO:tensorflow:global_step/sec: 359.857
INFO:tensorflow:loss = 78.54885, step = 901 (0.277 sec)
INFO:tensorflow:Saving checkpoints for 1000 into kernel_log/model.ckpt.
INFO:tensorflow:Loss for final step: 67.79706.


<tensorflow.python.estimator.canned.linear.LinearClassifier at 0x1a1fa3cbe0>
ステップ 5) モデルを評価する
モデルを評価するためのNumPy入力関数を定義します。評価にはテストセット全体を使用します。
# Evaluation
test_input_fn = tf.estimator.inputs.numpy_input_fn(
    x={"features": X_test},
    y=y_test,
    batch_size=16281,
    num_epochs=1,
    shuffle=False)
estimator.evaluate(input_fn=test_input_fn, steps=1)
INFO:tensorflow:Calling model_fn.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:22
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from kernel_log/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Evaluation [1/1]
INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:23
INFO:tensorflow:Saving dict for global step 1000: accuracy = 0.82353663, accuracy_baseline = 0.76377374, auc = 0.84898686, auc_precision_recall = 0.67214864, average_loss = 0.3877216, global_step = 1000, label/mean = 0.23622628, loss = 6312.495, precision = 0.7362797, prediction/mean = 0.21208474, recall = 0.39417577
{'accuracy': 0.82353663,
 'accuracy_baseline': 0.76377374,
 'auc': 0.84898686,
 'auc_precision_recall': 0.67214864,
 'average_loss': 0.3877216,
 'global_step': 1000,
 'label/mean': 0.23622628,
 'loss': 6312.495,
 'precision': 0.7362797,
 'prediction/mean': 0.21208474,
 'recall': 0.39417577}
精度は82パーセントです。次のセクションでは、カーネル分類器を使ってロジスティック分類器の精度を上回ることを目指します。
ステップ 6) カーネル分類器を構築する
カーネル推定器は、少なくとも構成の点では、従来の線形分類器とそれほど違いはありません。その背後にある考え方は、明示的なカーネルマップの力を組み合わせることです。ping 線形分類器を用いる。
カーネル分類器をトレーニングするには、TensorFlow で使用できる XNUMX つの事前定義された推定器が必要です。
- ランダムフーリエ特徴マッパー
- KernelLinearClassifier
最初のセクションで、カーネル関数を使用して低次元を高次元に変換する必要があることを学びました。より正確には、ガウス関数を近似するランダムフーリエ特徴量を使用します。TensorFlow 1.x では、この変換が提供されています。ping RandomFourierFeatureMapper として、また、推定器 KernelLinearClassifier を使用してモデルをトレーニングできます。
モデルを構築するには、次の手順に従います。
- 高次元カーネル関数の設定
- L2ハイパーパラメータを設定する
- モデルを構築する
- モデルを訓練する
- モデルを評価する
ステップA)高次元カーネル関数を設定する
現在のデータセットには14個の特徴量が含まれており、これらを5,000次元の新しいベクトルに変換します。変換にはランダムフーリエ特徴量を使用します。ガウスカーネルの式を思い出すと、標準偏差パラメータを定義する必要があることがわかります。このパラメータは、分類中に使用される類似度尺度を制御します。標準偏差が小さいと、カーネルは非常に近い点のみを類似点として扱い、大きいと決定境界を滑らかにします。
RandomFourierFeatureMapper のすべてのパラメーターを次のように調整できます。
- input_dim = 14
- output_dim = 5000
- 標準偏差 = 4
### Prep Kernel
kernel_mapper = tf.contrib.kernel_methods.RandomFourierFeatureMapper(input_dim=14, output_dim=5000, stddev=4, name='rffm')
以前に作成した機能列を使用してカーネル マッパーを構築する必要があります: feat_column
### Map Kernel
kernel_mappers = {feat_column: [kernel_mapper]}
ステップB)L2ハイパーパラメータを設定する
過学習を防ぐため、損失関数にL2正則化項を適用します。L2のハイパーパラメータを0.1、学習率を5に設定します。
optimizer = tf.train.FtrlOptimizer(learning_rate=5, l2_regularization_strength=0.1)
ステップC)モデルを構築する
次のステップは線形分類と同様です。組み込みの推定器であるKernelLinearClassifierを使用します。ただし、以前に定義したカーネルマッパーを追加し、モデルディレクトリを変更する必要があることに注意してください。
### Prep estimator
estimator_kernel = tf.contrib.kernel_methods.KernelLinearClassifier(
    n_classes=2,
    optimizer=optimizer,
    kernel_mappers=kernel_mappers,
    model_dir="kernel_train")
以下の非推奨警告は、TensorFlow 1.x では想定されるものです。なぜなら、kernel_methods モジュールは古い tf.contrib.learn 推定器に基づいて構築されているからです。
WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/kernel_methods/python/kernel_estimators.py:305: multi_class_head (from tensorflow.contrib.learn.python.learn.estimators.head) is deprecated and will be removed in a future version. Instructions for updating: Please switch to tf.contrib.estimator.*_head. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:1179: BaseEstimator.__init__ (from tensorflow.contrib.learn.python.learn.estimators.estimator) is deprecated and will be removed in a future version. Instructions for updating: Please replace uses of any Estimator from tf.contrib.learn with an Estimator from tf.estimator.* WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:427: RunConfig.__init__ (from tensorflow.contrib.learn.python.learn.estimators.run_config) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.RunConfig instead. INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_task_type': None, '_task_id': 0, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a200ae550>, '_master': '', '_num_ps_replicas': 0, '_num_worker_replicas': 0, '_environment': 'local', '_is_chief': True, '_evaluation_master': '', '_train_distribute': None, '_tf_config': gpu_options { per_process_gpu_memory_fraction: 1.0 } , '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_secs': 600, '_log_step_count_steps': 100, '_session_config': None, '_save_checkpoints_steps': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_model_dir': 'kernel_train'}
ステップD)モデルをトレーニングする
カーネル分類器が構築されたので、いよいよ学習を開始します。ここでは、モデルを2,000回反復学習させることを選択します。
### estimate
estimator_kernel.fit(input_fn=train_input_fn, steps=2000)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/head.py:678: ModelFnOps.__new__ (from tensorflow.contrib.learn.python.learn.estimators.model_fn) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.EstimatorSpec. You can use the `estimator_spec` method to create an equivalent one. INFO:tensorflow:Create CheckpointSaverHook. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Saving checkpoints for 1 into kernel_train/model.ckpt. INFO:tensorflow:loss = 0.6931474, step = 1 INFO:tensorflow:global_step/sec: 86.6365 INFO:tensorflow:loss = 0.39374447, step = 101 (1.155 sec) INFO:tensorflow:global_step/sec: 80.1986 INFO:tensorflow:loss = 0.3797774, step = 201 (1.247 sec) INFO:tensorflow:global_step/sec: 79.6376 INFO:tensorflow:loss = 0.3908726, step = 301 (1.256 sec) INFO:tensorflow:global_step/sec: 95.8442 INFO:tensorflow:loss = 0.41890752, step = 401 (1.043 sec) INFO:tensorflow:global_step/sec: 93.7799 INFO:tensorflow:loss = 0.35700393, step = 501 (1.066 sec) INFO:tensorflow:global_step/sec: 94.7071 INFO:tensorflow:loss = 0.35535482, step = 601 (1.056 sec) INFO:tensorflow:global_step/sec: 90.7402 INFO:tensorflow:loss = 0.3692882, step = 701 (1.102 sec) INFO:tensorflow:global_step/sec: 94.4924 INFO:tensorflow:loss = 0.34746957, step = 801 (1.058 sec) INFO:tensorflow:global_step/sec: 95.3472 INFO:tensorflow:loss = 0.33655524, step = 901 (1.049 sec) INFO:tensorflow:global_step/sec: 97.2928 INFO:tensorflow:loss = 0.35966292, step = 1001 (1.028 sec) INFO:tensorflow:global_step/sec: 85.6761 INFO:tensorflow:loss = 0.31254214, step = 1101 (1.167 sec) INFO:tensorflow:global_step/sec: 91.4194 INFO:tensorflow:loss = 0.33247527, step = 1201 (1.094 sec) INFO:tensorflow:global_step/sec: 82.5954 INFO:tensorflow:loss = 0.29305756, step = 1301 (1.211 sec) INFO:tensorflow:global_step/sec: 89.8748 INFO:tensorflow:loss = 0.37943482, step = 1401 (1.113 sec) INFO:tensorflow:global_step/sec: 76.9761 INFO:tensorflow:loss = 0.34204718, step = 1501 (1.300 sec) INFO:tensorflow:global_step/sec: 73.7192 INFO:tensorflow:loss = 0.34614792, step = 1601 (1.356 sec) INFO:tensorflow:global_step/sec: 83.0573 INFO:tensorflow:loss = 0.38911164, step = 1701 (1.204 sec) INFO:tensorflow:global_step/sec: 71.7029 INFO:tensorflow:loss = 0.35255936, step = 1801 (1.394 sec) INFO:tensorflow:global_step/sec: 73.2663 INFO:tensorflow:loss = 0.31130585, step = 1901 (1.365 sec) INFO:tensorflow:Saving checkpoints for 2000 into kernel_train/model.ckpt. INFO:tensorflow:Loss for final step: 0.37795097. KernelLinearClassifier(params={'head': <tensorflow.contrib.learn.python.learn.estimators.head._BinaryLogisticHead object at 0x1a2054cd30>, 'feature_columns': {_RealValuedColumn(column_name='features_MAPPED', dimension=5000, default_value=None, dtype=tf.float32, normalizer=None)}, 'optimizer': <tensorflow.python.training.ftrl.FtrlOptimizer object at 0x1a200aec18>, 'kernel_mappers': {_RealValuedColumn(column_name='features', dimension=14, default_value=None, dtype=tf.float32, normalizer=None): [<tensorflow.contrib.kernel_methods.python.mappers.random_fourier_features.RandomFourierFeatureMapper object at 0x1a200ae400>]}})
ステップE)モデルを評価する
最後に、モデルのパフォーマンスを評価します。 ロジスティック回帰を克服できるはずです。
# Evaluate and report metrics.
eval_metrics = estimator_kernel.evaluate(input_fn=test_input_fn, steps=1)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:50 INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from kernel_train/model.ckpt-2000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Evaluation [1/1] INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:51 INFO:tensorflow:Saving dict for global step 2000: accuracy = 0.83975184, accuracy/baseline_label_mean = 0.23622628, accuracy/threshold_0.500000_mean = 0.83975184, auc = 0.8904007, auc_precision_recall = 0.72722375, global_step = 2000, labels/actual_label_mean = 0.23622628, labels/prediction_mean = 0.23786618, loss = 0.34277728, precision/positive_threshold_0.500000_mean = 0.73001117, recall/positive_threshold_0.500000_mean = 0.5104004
最終的な精度は84%で、ロジスティック回帰のベースライン(0.82353663)を約1.6パーセントポイント上回りました(0.83975184)。精度向上と計算コストの間にはトレードオフが存在します。より負荷の高い分類器によってかかる時間に見合うだけの精度向上が得られるか、また、それがビジネスにどれほど大きな影響を与えるかを検討する必要があります。
