
挿入ソートアルゴリズム Java プログラム例付き
 ジェームズ・ハートマン
挿入ソートアルゴリズムとは何ですか?
挿入ソートは、小さなデータセットに適したシンプルなソートアルゴリズムです。 各反復中に、アルゴリズムは次のことを行います。
- 配列から要素を削除します。
- 最大値と比較します 配列.
- 要素を正しい位置に移動します。
この動作は、カードゲームでプレイヤーが手札を並べる方法に似ています。新しいカードは1枚ずつ手に取られ、より大きなカードを追い越して左に押し出され、適切な位置に収まるまで移動されます。すべての移動は元の配列内で行われるため、挿入ソートはインプレースかつ安定しています。
初心者向けの同じファミリーに属します Java ソートルーチンとして バブルソートしかし、既に部分的に順序付けられているデータに対しては、通常は書き込み回数がはるかに少なくなります。
挿入ソートアルゴリズムプロセス
挿入ソート アルゴリズム プロセスがどのように動作するかを図で示します。
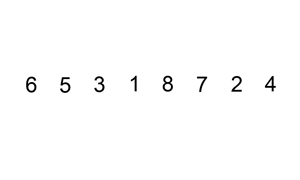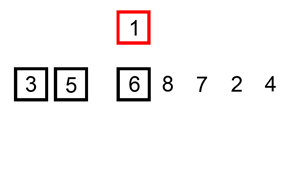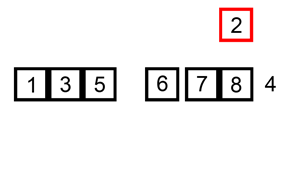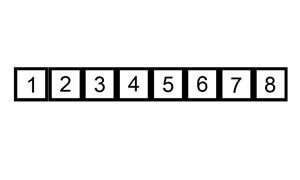
アニメーションは同じ3つのステップを繰り返します Java 以下のプログラムが実行されます。ドライランテーブル tracプログラムが実行時に出力する手順とまったく同じように、サンプル配列 {860, 8, 200, 9} に対してこれらの手順を実行します。
| 合格 | 重要な要素 | 比較が行われた | パス後の配列 |
|---|---|---|---|
| 1 | 8 | 8対860 | 8 860 200 9 |
| 2 | 200 | 200対860 | 8 200 860 9 |
| 3 | 9 | 9対860、そして9対200 | 8 9 200 860 |
パス3では、キー9が2つのより大きな値を通過する必要があるため、2回の比較が必要になることに注意してください。したがって、比較回数は、各要素の開始順序のずれに応じて増加します。
Java 挿入ソートアルゴリズムを使用して配列をソートするプログラム例:
以下のプログラムは配列 {860, 8, 200, 9} をソートし、実行中の解説を出力するので、すべての比較とすべてのシフトが確認できます。 InsertionSortExample.java そして、JDK 8以降のリリースでコンパイルしてください。
package com.guru99;

public class InsertionSortExample {


    public static void main(String a[])
    {
        int[] myArray  = {860,8,200,9};

        System.out.println("Before Insertion Sort");

        printArray(myArray);

        insertionSort(myArray);//sorting array using insertion sort

        System.out.println("After Insertion Sort");

        printArray(myArray);
    }
 public static void insertionSort(int arr[])
	{
        int n = arr.length;

        for (int i = 1; i < n; i++)
        {   System.out.println("Sort Pass Number "+(i));
            int key = arr[i];
            int j = i-1;

            while ( (j > -1) && ( arr [j] > key ) )
            {
            System.out.println("Comparing "+ key  + " and " + arr [j]);
                arr [j+1] = arr [j];
                j--;
            }
            arr[j+1] = key;
            System.out.println("Swapping Elements: New Array After Swap");
            printArray(arr);
        }
    }
 static void printArray(int[] array){

	    for(int i=0; i < array.length; i++)
		{
			System.out.print(array[i] + " ");
		}
	    System.out.println();

	}
}
クラスを実行すると、 trace はここに示されています。 ソートパス番号 各行は外側のループの1回の反復を示し、各スワップの後に表示される行は、その時点での配列の状態を示します。
Code 出力:
Before Insertion Sort
860 8 200 9
Sort Pass Number 1
Comparing 8 and 860
Swapping Elements: New Array After Swap
8 860 200 9
Sort Pass Number 2
Comparing 200 and 860
Swapping Elements: New Array After Swap
8 200 860 9
Sort Pass Number 3
Comparing 9 and 860
Comparing 9 and 200
Swapping Elements: New Array After Swap
8 9 200 860
After Insertion Sort
8 9 200 860
挿入ソートの時間計算量と空間計算量
挿入ソートのパフォーマンスは、入力データが既にどれだけ順序付けられているかに大きく依存するため、最良の場合と最悪の場合では、成長率が1桁も異なるのです。
| 事例 | 入力条件 | 時間の複雑さ |
|---|---|---|
| おすすめ! | 配列は既にソートされているため、内側のwhileループは実行されません。 | O(N) |
| 平均 | 要素はランダムな順序で到着します | O(n²) |
| 最悪 | 配列は逆順にソートされているため、すべてのキーが先頭に移動します。 | O(n²) |
スペースの使い方ははるかにシンプルです。カウンターだけ i, j, n (NAIST) と key が作成され、配列はインプレースで再配置されるため、入力がどれだけ大きくなっても補助スペースはO(1)になります。
挿入ソートは、より小さい値に到達するとすぐに内側のループが停止するため、適応型であると言えます。つまり、入力がソートされた順序に近づくほど、実行時間は線形に近づきます。
挿入ソートの利点と欠点
挿入ソートは、平均計算量が2乗になるケースがあるにもかかわらず、定数係数が非常に小さく、動作が予測可能であるため、実用ライブラリで依然として広く利用されている。
優位性
- 書きやすく、 trac手書きなので、教育やインタビューに適しています。
- 安定しているため、同じキーを共有するレコードは元の相対的な順序を維持します。
- インプレース方式なので、入力配列以外にO(1)の追加メモリしか必要としません。
- 適応型で、既にほぼソート済みのデータに対してO(n)の計算量を達成する。
- オンラインであるため、新しい要素が到着している間でもリストを並べ替えることができます。
デメリット
- ランダム入力や逆順入力の場合、処理時間が2乗に比例するため、大規模な配列には適さない。
- 各シフトは配列に書き込むため、選択ソートよりも多くのデータを移動します。
- 入力要素が数十個を超えると、マージソートやクイックソートの方がはるかに優れた性能を発揮する。
実用的なルールとしては、配列が小さい場合、データがほぼ順序通りになっている場合、または分割統治法によるソートでパーティションが少数の要素にまで縮小された場合に、挿入ソートを使用するのが良いでしょう。
挿入ソート対 Bubblソートと選択ソートの比較
これら3つのアルゴリズムはすべて二次比較ソートですが、安定性、順序付き入力への反応、および書き込み回数において違いがあります。
| 基準 | 挿入ソート | Bubble 並べ替え | 選択ソート |
|---|---|---|---|
| 最良の場合 | O(N) | 早期終了フラグ付きでO(n) | O(n²) |
| 平均および最悪の場合 | O(n²) | O(n²) | O(n²) |
| 余分なスペース | O(1) | O(1) | O(1) |
| 安定した | はい | はい | いいえ、標準配列バージョンでは |
| 適応 | はい | はい、フラグ最適化が使用されている場合 | いいえ |
| 配列に書き込みます | シフトは多いが、順序付けられたデータに基づくものは少ない | 多くのスワップ | ちょうどn-1回のスワップ |
選択ソートは書き込みコストが高い場合に最も勝る。なぜなら、スワップ回数が最も少ないからである。挿入ソートは、この規模ではほぼあらゆる場面で勝る。特に部分的に順序付けられたデータの場合、ライブラリソートが優れている。これが、ライブラリソートが使用される理由である。 一般的な Java 演習 そして、JDKの内部では、非常に小さなパーティションの場合にそれに切り替わります。
