
AI(人工知能)におけるエキスパートシステムとは何ですか? 例付き
 エブリン・クラーク
エキスパートシステムとは何ですか?
エキスパートシステム エキスパートシステムは、事実とヒューリスティックの両方を用いて複雑な意思決定問題を解決する、対話型で信頼性の高いコンピュータベースの意思決定システムです。エキスパートシステムの目的は、特定の分野における最も複雑な問題を解決することです。
人工知能のエキスパート システム
人工知能におけるエキスパートシステムは、通常であれば人間の専門家を必要とする多くの問題を解決することができます。これは、専門家から得られた知識に基づいています。 Artificial Intelligence エキスパートシステムは、ある知識領域について表現し、推論することができる。エキスパートシステムは、現代のシステムの先駆けである。 人工知能、深層学習、機械学習 システム。
エキスパートシステムの例
エキスパート システムの例を次に示します。
- マイシン: これは後方連鎖推論に基づいており、急性感染症を引き起こす可能性のある様々な細菌を特定することができた。また、患者の体重に基づいて薬剤を推奨することもできた。これはエキスパートシステムの優れた事例の一つである。
- デンドラル: 分子構造を予測するために化学分析に用いられるエキスパートシステム。
- PXDE: 肺がんの進行度と種類を予測するために使用されるエキスパートシステムの例。
- カデット: がんを早期段階で発見できる、最も優れたエキスパートシステムの一例。
エキスパートシステムの特徴
これらの事例には共通の特徴があり、それは以下の図にまとめられています。

なぜエキスパートシステムが必要なのでしょうか?
AI におけるエキスパート システムの重要な特性は次のとおりです。
- 最高レベルの専門知識: AIにおけるエキスパートシステムは、最高レベルの専門知識を提供します。効率性、正確性、そして独創的な問題解決能力を実現します。
- 時間通りの反応: エキスパートシステムは妥当な時間内に応答し、理想的には人間の専門家が同じ結論に達するよりも速く応答する。
- 優れた信頼性: AIにおけるエキスパートシステムは信頼性が高くなければならず、間違いを犯してはならない。
- フレキシブル: エキスパートシステムは柔軟性を維持する必要があり、ドメインの変化に応じて知識ベースを拡張または修正できるようにしなければならない。
- 効果的なメカニズム: システムには、既に保有している知識を整理・更新するための効率的な仕組みが必要である。
- 困難な決断や問題に対処できる能力: エキスパートシステムは、困難な意思決定問題を処理し、解決策を提供する能力を備えている。
エキスパートシステムのコンポーネント
これらの特性は、ブロック図に示すように、互いに情報を伝達する3つの部分によって実現されます。

AI のエキスパート システムは、次のコンポーネントで構成されます。
ユーザーインターフェース
ユーザーインターフェースは、エキスパートシステムソフトウェアにおいて最も重要な部分です。このコンポーネントは、ユーザーのクエリを読みやすい形式で受け取り、推論エンジンに渡します。その後、結果をユーザーに表示します。言い換えれば、ユーザーインターフェースは、ユーザーがエキスパートシステムとコミュニケーションをとるためのツールです。
推論エンジン
推論エンジンはエキスパートシステムの頭脳です。特定の問題を解決するためのルールを含み、知識ベースに格納されている知識を参照します。ユーザーのクエリに答える際に適用する事実とルールを選択し、問題を分解して結論を導き出します。
ナレッジベース
知識ベースは事実のリポジトリです。 問題のドメインに関するすべての知識が保存されます。 これは、特定の分野のさまざまな専門家から得られる知識の大きな容器のようなものです。
したがって、エキスパート システム ソフトウェアの成功は主に、非常に正確で正確な知識に依存していると言えます。
エキスパート システムで使用されるその他の重要な用語
事実とルール
事実は重要な情報のほんの一部です。 事実それ自体の用途は非常に限られています。 ルールは、事実を選択してユーザーの問題に適用するために不可欠です。
知識の獲得
知識獲得という用語は、エキスパートシステムが必要なドメイン知識を取得する方法を意味します。プロセス全体は、trac人間の専門家から知識を取得し、取得した知識をルールに変換し、開発したルールを知識ベースに注入する。 trac下の図に示されています。
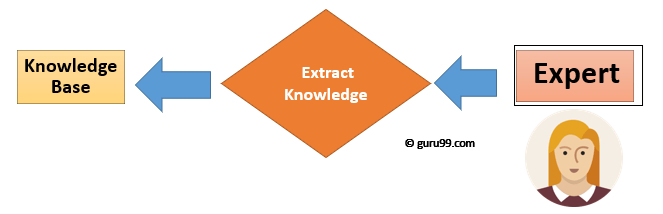
知識の実験tractionプロセス
エキスパートシステム開発参加者
| 参加者 | 職種 |
| ドメインエキスパート | エキスパートシステムの開発にあたり、その専門知識と知見が求められる個人またはグループ。 |
| 知識エンジニア | その知識をコンピュータシステムに統合する技術者。 |
| エンドユーザー | 専門家システムを利用して、専門家から直接得られないような助言を得る個人またはグループ。 |
エキスパートシステムの構築プロセス
- 問題の特徴を判断する
- ナレッジ エンジニアとドメインの専門家が連携して問題を定義します
- 知識エンジニアは、知識をコンピュータが理解できる言語に変換し、必要に応じてその知識を利用できる推論エンジン、つまり推論構造を設計する。
- 知識エンジニアは、不確実な知識を推論プロセスにどのように組み込むか、またどのような種類の説明が有用かを判断する。
従来のシステムとエキスパートシステムの比較
エキスパートシステムを通常のプログラムと並べて比較すると、その設計がより明確になる。
| 従来のシステム | エキスパートシステム |
| 知識と処理が XNUMX つのユニットに結合されます。 | ナレッジ データベースと処理メカニズムは XNUMX つの別個のコンポーネントです。 |
| このプログラムは(プログラミング上のエラーがない限り)エラーを起こしません。 | エキスパートシステムは間違いを犯す可能性があります。 |
| システムは完全に開発された場合にのみ運用可能です。 | エキスパートシステムは継続的に最適化されており、少数のルールで起動できます。 |
| 固定されたアルゴリズムに従って段階的に実行する必要があります。 | 実行は論理的かつヒューリスティックに行われます。 |
| 完全な情報が必要です。 | 情報が十分であっても不十分であっても機能する可能性があります。 |
人間のエキスパート vs エキスパート システム
| 人間の専門家 | 人工的な専門知識 |
| 腐りやすい | 正社員 |
| 転送が難しい | 譲渡可能 |
| 文書化が難しい | 文書化が簡単 |
| 予測できない | 一貫性のある |
| 高価な | 費用対効果の高いシステム |
エキスパートシステムのメリット
人工知能 (AI) におけるエキスパート システムの主な利点は次のとおりです。
- 意思決定の質が向上します
- 問題解決のために専門家に相談する費用を削減します
- 狭い専門分野の問題に対して迅速かつ効率的なソリューションを提供します。
- 希少な専門知識を集め、それを効率的に活用することができる。
- 繰り返し発生する問題に対して一貫した解決策を提供する
- 意思決定についての適切な説明
- 複雑で困難な問題を解決する能力
- 人工知能エキスパート システムは、感情的になったり、緊張したり、疲労したりすることなく、安定して作業できます。
エキスパートシステムの限界
AI におけるエキスパート システムの欠点/制限は次のとおりです。
- 異常事態で創造的な対応ができない
- ナレッジベースのエラーは誤った決定につながる可能性があります
- エキスパートシステムの維持費は高すぎる
- 問題はそれぞれ異なるため、人間の専門家による解決策も異なり、より創造的なものになる可能性があります。
エキスパートシステムの応用
人気のある エキスパートシステムの応用:
- 情報管理
- 病院および医療施設
- ヘルプデスク管理
- 従業員の業績評価
- ローン分析
- ウイルス検出
- 修理やメンテナンスのプロジェクトに役立ちます
- 倉庫の最適化
- 計画とスケジューリング
- 製造されたオブジェクトの構成
- 財務上の意思決定
- 知識出版
- プロセスの監視と制御
- 株式市場取引
- 航空会社のスケジュールと貨物のスケジュール
⚡ スマートサマリー
エキスパートシステムとは、対話型でルールに基づいた意思決定プログラムであり、蓄積された事実とヒューリスティックを組み合わせることで、その分野の訓練を受けた専門家が通常期待するレベルの判断力で、狭く複雑な問題を解決する。
