
データウェアハウス Archi構造、コンポーネント、図 Concepts
 編集チーム
⚡ スマートサマリー
データウェアハウス Archi構造とは、多くの情報源からの履歴データや累積データを、階層化されたレイヤーと接続されたコンポーネントにどのように整理するかを定義するものであり、組織の意思決定や予測のための信頼性の高いレポート作成、分析、そして単一の真実の情報源を可能にします。
データウェアハウス Concepts
A データウェアハウス これは、企業が意思決定や予測を行う際に、信頼できる唯一の情報源を提供するために存在する。これは、1つまたは複数の情報源から収集された履歴データと累積データを保持する情報システムである。
データウェアハウスは、データを取引単位ではなく分析単位で整理することで、組織全体のレポート作成と分析作業を簡素化します。

データウェアハウスの特徴
データウェアハウスには、通常の運用データベースとは一線を画す4つの特徴があります。
- 主題指向
- Integrated
- 時変型
- 不揮発性
主題指向
データウェアハウスは、企業の日常業務ではなく、特定のテーマに関する情報を提供するという点で、主題指向型である。典型的な主題としては、販売、マーケティング、流通などが挙げられる。
日常的な処理ではなく、このデータウェアハウスは意思決定のためのモデリングと分析を重視しています。各対象についてシンプルで簡潔なビューを提供し、意思決定プロセスをサポートしないデータは除外します。
Integrated
統合は、主題指向と密接に関連している。データウェアハウスにおける統合とは、異なるデータベースから抽出された類似データすべてに対して共通の測定単位を確立し、そのデータを共通の、普遍的に受け入れられる方法で保存することを意味する。
データウェアハウスは、メインフレーム、リレーショナルデータベース、フラットファイルなど、さまざまなソースからのデータを統合して構築されます。また、命名規則、フォーマット、コーディングの一貫性を維持する必要があります。
命名規則、属性測定方法、およびエンコード構造におけるこの一貫性こそが、効果的な分析を可能にするのです。次の例を考えてみましょう。
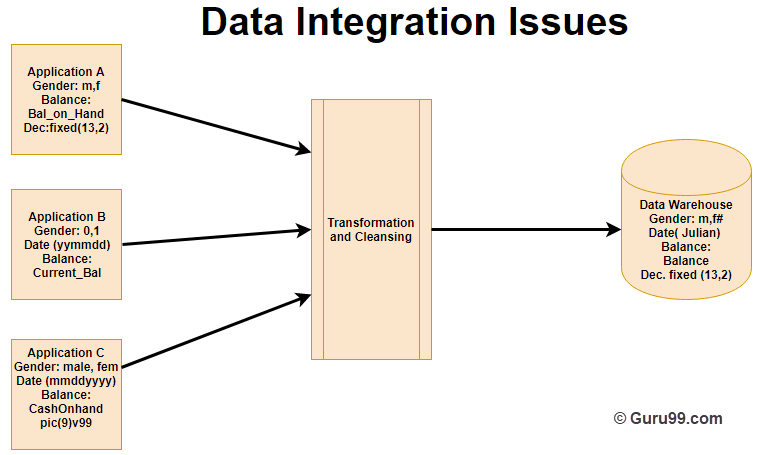
上記の例では、A、B、Cというラベルの付いた3つのアプリケーションがそれぞれ性別、日付、残高情報を保存していますが、各アプリケーションは異なる方法でこれらの情報を保存しています。
- アプリケーションAは、性別フィールドをMやFなどの論理値として格納します。
- アプリケーションBは、性別フィールドを数値として保存します。
- アプリケーションCは、性別フィールドを文字値として格納します。
- 日付と残高のフィールドにも同様のバリエーションが適用されます。
変換およびクリーニング処理後、これらのデータはすべてデータウェアハウス内の共通フォーマットに保存されます。
時変型
データウェアハウスの時間軸は、運用システムの時間軸よりもはるかに広い。データは特定の期間で認識され、歴史的な視点を提供するため、明示的または暗黙的に常に時間要素を含んでいる。
この時間的な差異が現れる箇所の一つは、レコードキーの構造です。データウェアハウス内のすべての主キーには、日、週、月といった時間要素が含まれている必要があります。
時間的変動のもう一つの側面は、データがデータウェアハウスに一度挿入されると、更新や変更ができなくなるという点です。
不揮発性
データウェアハウスは不揮発性であるため、新しいデータが到着しても以前のデータは消去されません。データは読み取り専用で定期的に更新されるため、アナリストは過去のデータを分析し、何がいつ起こったのかを理解するのに役立ちます。
データウェアハウスはトランザクション処理、リカバリ、同時実行制御を必要としないため、運用アプリケーションで一般的な削除、更新、挿入といった処理は行いません。データウェアハウスで実行されるデータ操作は、次の2つのみです。
- データの読み込み
- データアクセス
以下の表は、運用アプリケーションとデータウェアハウスの主な違いをいくつか示しています。
| Operaアプリケーション | データウェアハウス |
|---|---|
| データ アップグレード プロセスが最終製品の高い整合性を維持するようにするには、複雑なプログラムをコーディングする必要があります。 | データ更新が行われていないため、このような問題は発生しません。 |
| データは正規化された形式で配置され、冗長性が最小限に抑えられます。 | データは正規化された形式で保存されません。 |
| トランザクション、データ復旧、ロールバック、デッドロック解消といった問題に対応するために必要な技術は非常に複雑である。 | 比較的シンプルなテクノロジーを提供します。 |
データウェアハウス Archi構造
データウェアハウス Archiシステムが複数のソースからの履歴データと累積データを保存するため、構造は複雑です。データウェアハウスの階層を構築するには、単層、二層、三層の3つのアプローチがあります。
単層アーキテクチャ 冗長性を排除することで保存されるデータ量を最小限に抑えることを目的としている。しかし、実際にはほとんど使用されていない。
2層アーキテクチャ 物理的に利用可能なデータソースとデータウェアハウスを分離する。拡張性が低く、サポートできるエンドユーザー数も少なく、ネットワークの制限により接続の問題が発生する可能性がある。
XNUMX 層アーキテクチャ これは、データウェアハウスの設計の中で最も広く用いられているものです。
それは、最上層、中間層、最下層から構成されています。
- 最下層: 倉庫のデータベースは最下層として機能します。通常はリレーショナルデータベースシステムであり、バックエンドツールを使用してデータがクレンジング、変換され、この層にロードされます。
- 中間層: ミドルティアは、ROLAPまたはMOLAPモデルを使用して実装されたOLAPサーバーです。tracデータベースのtedビューを持ち、エンドユーザーとデータベース間の仲介役として機能します。
- トップティア: 最上位層はフロントエンドのクライアント層です。クエリツール、レポートツール、マネージドクエリツール、分析ツール、データマイニングツールなど、データウェアハウスに接続してデータを取り出すために使用されるツールとAPIが格納されています。
データウェアハウスのコンポーネント
データウェアハウスの構成要素と全体的なアーキテクチャは、以下の図に示すように連携して動作します。
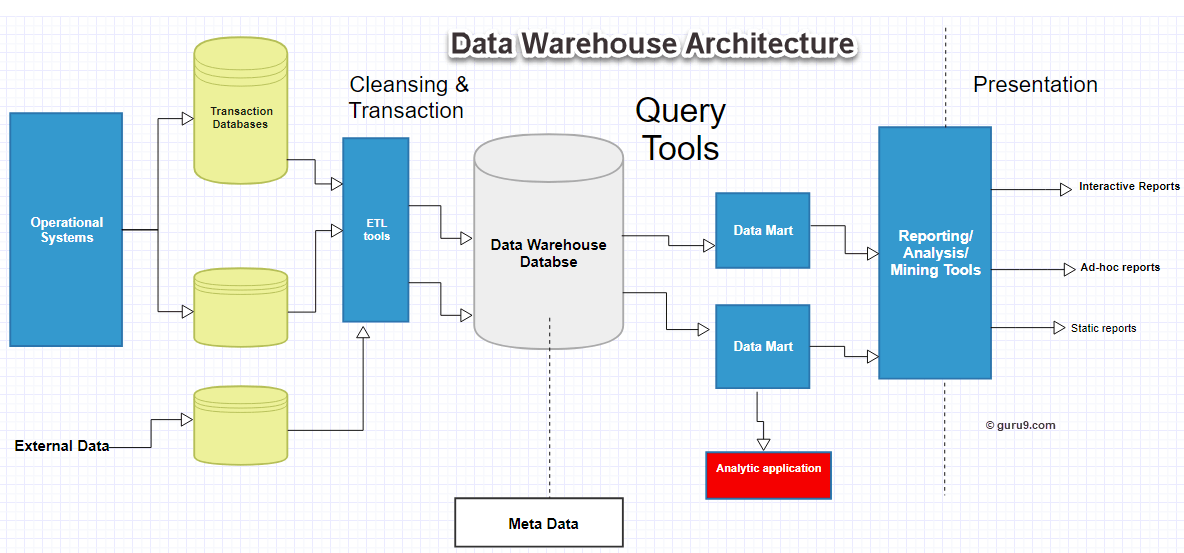
データウェアハウスは、RDBMSサーバーを基盤としており、中央情報リポジトリは、環境全体を機能的、管理可能、かつアクセス可能な状態に保つための主要コンポーネントに囲まれています。
データウェアハウスは、以下に説明する5つの主要な構成要素から成り立っています。
データ ウェアハウス データベース
中央データベースは倉庫環境の基盤であり、 RDBMS テクノロジー。従来のRDBMSはデータウェアハウスではなくトランザクション処理に最適化されているため、アドホッククエリ、複数テーブルの結合、集計などのリソースを大量に消費する操作は処理速度を低下させる可能性があります。
そのため、代替的なデータベース手法が用いられる。
- リレーショナルデータベースは、スケーラビリティを確保するために並列に展開され、さまざまなマルチプロセッサ構成や大規模並列構成において、共有メモリ型または共有なし型のモデルが使用されます。
- 新しいインデックス構造は、リレーショナルテーブルのスキャンを回避し、速度を向上させるために使用されます。
- 多次元データベース(MDDB)は、リレーショナルウェアハウスモデルの限界を克服するために使用されます。例としては、Essbase が挙げられます。 Oracle.
調達、取得、クリーンアップおよび変換ツール (ETL)
データソース、変換、移行ツールは、データを統一されたウェアハウス形式に変換するために必要なすべての変換、集計、変更を実行します。tract、変換、ロード(ETL)ツール。
その機能には以下のものが含まれます。
- 規制規定に従ってデータを匿名化します。
- 倉庫にデータを搬入する前に、運用データベースから不要なデータを削除してください。
- さまざまなソースから到着するデータの一般的な名前と定義を検索して置き換えます。
- 要約値と派生データを計算する。
- 欠落しているデータにはデフォルト値を代入する。
- 複数のソースから送られてくる重複データを削除する。
ボーマン ETLツール 定期的にデータウェアハウスを更新し、メタデータの維持に役立つcronジョブ、バックグラウンドジョブ、COBOLプログラム、シェルスクリプトを生成する場合があります。
ETLツールは多くのシステムからデータを取得するため、データベースやデータの異質性にも対応する必要がある。
メタデータは高度な概念のように聞こえるかもしれませんが、簡単に言えば、データウェアハウスを定義するデータに関するデータのことです。これは、ウェアハウスの構築、維持、管理に使用されます。
アーキテクチャ内では、メタデータはデータのソース、用途、値、および特徴を指定し、データの変更および処理方法を定義することで、データがデータウェアハウスと密接に連携するようにします。
例えば、販売データベースの行には次のような情報が含まれる場合があります。
4030 KJ732 299.90
メタデータによって、これがモデル番号4030、販売代理店ID KJ732、および総売上高299.90ドルを表していることが説明されるまでは、これは無意味です。
したがって、メタデータはデータを知識に変換する上で不可欠な要素であり、次のような疑問に答えるのに役立ちます。
- ウェアハウスにはどのようなテーブル、属性、キーが含まれていますか?
- データはどこから来たのでしょうか?
- データは何回再読み込みされますか?
- どのような変容と浄化が行われたのか?
メタデータは2つのカテゴリに分類されます。
- 技術メタデータ: これは、倉庫の設計者や管理者向けに、倉庫の構造や運営方法を説明するものです。
- ビジネス メタデータ: これにより、エンドユーザーはデータウェアハウスに保存されている情報を容易に理解できるようになります。
クエリツール
データウェアハウスの主な目的は、企業が戦略的な意思決定を行うために必要な情報を提供することであり、クエリツールはユーザーがシステムとやり取りするための手段となる。
これらのツールは4つのカテゴリーに分類されます。
- クエリおよびレポートツール
- アプリケーション開発ツール
- データマイニングツール
- OLAPツール
クエリとレポートツール
クエリおよびレポート作成ツールは、レポート作成ツールとマネージドクエリツールの2つのグループに分けられます。
報告ツール さらに、生産レポートツールとデスクトップレポート作成ツールに細分化されます。
- レポート作成者: これらは、独自の分析を行うエンドユーザー向けに設計されています。
- 生産報告: これらにより、組織は定期的な運用レポートを生成し、印刷や計算などの大量のバッチジョブをサポートできます。一般的な例としては、Brio、Business Objects、 OraclePowerSoft、およびSAS Institute。
マネージドクエリツール ユーザーとデータベースの間にメタレイヤーを挿入することで、エンドユーザーを支援し、SQLやデータベース構造の複雑さを隠蔽します。
アプリケーション開発ツール
組織の分析ニーズを満たすために、組み込みのグラフィックツールや分析ツールが使用できない場合は、アプリケーション開発ツールを使用してカスタムレポートが作成されます。
データマイニングツール
データマイニングは、大量のデータの中から意味のある新たな相関関係、パターン、傾向を発見するものであり、データマイニングツールはその発見を自動化する。
OLAPツール
OLAP これらのツールは多次元データベースに基づいて構築されており、ユーザーは精緻な多次元ビューを通してデータを分析することができる。
データウェアハウスバス Archi構造
データウェアハウスバスは、データがウェアハウス内をどのように流れるかを決定します。その流れは、インフロー、アップフロー、ダウンフロー、アウトフロー、およびメタフローに分類できます。
バスを設計する際には、データマートにまたがる共通の次元と事実を考慮に入れる必要があります。
データマート
A データマート データマートは、ユーザーにデータを配信するために使用されるアクセス層です。構築にかかる時間とコストが少ないため、大規模なデータウェアハウスに適していますが、データマートの定義は統一されていません。
簡単に言うと、データマートはデータウェアハウスの補助的な役割を担います。特定のユーザーグループ向けにデータを分割し、ウェアハウスと同じデータベース内、または物理的に別のデータベース内に配置することができます。
データウェアハウス Archiベストプラクティスを構築する
健全なデータウェアハウスアーキテクチャを設計するには、以下のベストプラクティスに従ってください。
- 情報検索に最適化されたデータウェアハウスモデルを使用する。 次元の非正規化、またはハイブリッドアプローチ。
- トップダウン方式かボトムアップ方式か、適切な設計手法を選択してください。
- データを迅速かつ正確に処理し、単一の真実の情報源に統合するようにしてください。
- データウェアハウスのデータ取得およびデータクレンジングプロセスを慎重に設計してください。
- データウェアハウスのコンポーネント間でメタデータを共有できるメタデータアーキテクチャを設計する。
- 考える Operaデータ取得ニーズがデータアブソリュートの底に近い場合の、国家データストア(ODS)モデルtrac機能ピラミッド、または複数の運用ソースにアクセスする必要がある場合。
- データモデルは単に統合するのではなく、統合されていることを確認してください。その場合、第3正規形(3NF)のデータモデルを使用するのが理想的です。これは、ETLツールやデータクレンジングツールを導入する際にも最適です。
