
Bubbleソートアルゴリズム Python リストの例を使用する
 サラ・チェン
⚡ スマートサマリー
Bubblソートは、隣接する値を繰り返し比較して交換することにより、リスト項目を昇順に並べます。ping 左側の要素が大きい場合に、それらの要素を除外します。この単純な比較によるソートは、小規模なデータセットやほぼソート済みのデータセットに適しており、基本的なソートロジックを効果的に学習できます。
何が Bubble ソート?
Bubble 並べ替え これは、隣接する2つの値を比較してリスト項目を昇順に並べ替えるために使用されるソートアルゴリズムです。最初の値が2番目の値より大きい場合、最初の値が2番目の値の位置を占め、2番目の値が最初の値の位置を占めます。最初の値が2番目の値より小さい場合は、スワップは行われません。ping 終わらせる。
このプロセスは、リスト内のすべての値が比較され、必要に応じて交換されるまで繰り返されます。 各反復は通常、パスと呼ばれます。 バブル ソートのパス数は、リスト内の要素の数から XNUMX を引いたものと等しくなります。
この中の Bubble ソート Python チュートリアル このコードが解決する問題、最適化された形式、段階的な視覚的解説、動作例を学びます。 Python プログラムとその性能特性。
の実装 Bubbleソートアルゴリズム
実装は、問題、解決策、そしてあらゆる言語でコードを書くために使用できるアルゴリズムという3つのステップに分けて説明します。
問題
品目リストがランダムな順序で提示されているので、それらを整然とした順序に並べたい。
次のリストを検討してください。
[21, 6, 9, 33, 3]
ソリューション
リストを反復処理し、隣接する2つの要素を比較して交換します。ping 最初の値が2番目の値より大きい場合は、それらを使用します。
結果は次のようになります。
[3, 6, 9, 21, 33]
アルゴリズム
バブルソートアルゴリズムは次のように動作します。
ステップ1) 要素の総数を取得します。指定されたリスト内の項目の総数を取得します。
ステップ2) 実行すべき外側パスの数(n - 1)を決定します。その長さはリストから1を引いたものです。
ステップ3) 外側パス1に対して、内側パスを(n-1)回実行します。最初の要素の値を取得し、2番目の値と比較します。2番目の値が最初の値より小さい場合は、位置を交換します。
ステップ4) ステップ3のパスを外側のパス(n-1)に到達するまで繰り返します。リスト内の次の要素を取得し、すべての値が正しい昇順になるまでステップ3で実行したプロセスを繰り返します。
ステップ5) すべての処理が完了したら、結果を返します。ソートされたリストの結果を返します。
ステップ6) アルゴリズムを最適化する。
リストまたは隣接する値がすでにソートされている場合は、不要な内部パスを避けてください。 たとえば、提供されたリストに昇順で並べ替えられた要素がすでに含まれている場合、ループを早期に中断できます。
最適化 Bubbleソートアルゴリズム
デフォルトでは、バブルソートのアルゴリズムは Python リストがすでにソートされているかどうかに関係なく、リスト内のすべての項目を比較します。指定されたリストがすでにソートされている場合、すべての値を比較するのは時間とリソースの無駄になります。
バブルソートを最適化すると、不必要な繰り返しを回避し、時間とリソースを節約できます。
たとえば、最初の項目と2番目の項目がすでにソートされている場合、残りの値を反復処理する必要はありません。反復処理は終了し、次の反復処理が開始され、プロセスが完了するまで続きます。 Bubble ソートの例。
最適化は以下の手順で行われます。
ステップ1) スワップが発生したかどうかを監視するフラグ変数を作成します。ping 内側のループで発生しました。
ステップ2) 値の位置が入れ替わった場合は、次の反復処理に進みます。
ステップ3) 値の位置が入れ替わっていない場合は、内側のループを終了し、外側のループを続行する。
最適化されたバブル ソートは、必要なステップのみを実行し、不要なステップをスキップするため、より効率的です。
視覚的表現
5つの要素のリストが与えられた場合、以下の図はバブルソートが値をソートする際にどのように値を反復処理するかを示しています。
以下の画像は、ソートされていないリストを示しています。

最初の反復
ステップ1)

値 21 と 6 を比較して、どちらが他方よりも大きいかを確認します。

21は6より大きいので、21は6が占めていた位置に入り、6は21が占めていた位置に入ります。

変更されたリストは上記のようになります。
ステップ2)
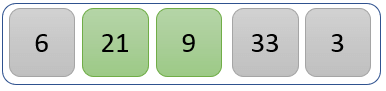
値 21 と 9 が比較されます。

21は9より大きいので、21と9の位置を入れ替えます。

新しいリストは上記のとおりです。
ステップ3)

値 21 と 33 を比較して、大きい方を見つけます。

値33は21より大きいので、交換は不要です。ping 行われます。
ステップ4)

値 33 と 3 を比較して、大きい方を見つけます。

値 33 は 3 より大きいため、それらの位置を交換します。

最初の反復処理の最後に得られるソート済みリストは、上記のものと同様です。
XNUMX回目の反復
2回目の反復処理後の新しいリストは以下のとおりです。

XNUMX回目の反復
3回目の反復処理後の新しいリストは以下のとおりです。

XNUMX 回目の反復
4回目の反復処理後の新しいリストは以下のとおりです。

Python 例
次のコードは、 Bubbleソートアルゴリズム Python.
def bubbleSort(theSeq):
    n = len(theSeq)

    for i in range(n - 1):
        flag = 0

        for j in range(n - 1):
            if theSeq[j] > theSeq[j + 1]:
                tmp = theSeq[j]
                theSeq[j] = theSeq[j + 1]
                theSeq[j + 1] = tmp
                flag = 1

        if flag == 0:
            break

    return theSeq

el = [21, 6, 9, 33, 3]
result = bubbleSort(el)
print(result)
上記のバブルソートプログラムを実行すると、 Python 次のような結果が生成されます。
[3, 6, 9, 21, 33]
Code 説明
説明は Python Bubbleソートプログラムのコードは以下のとおりです。
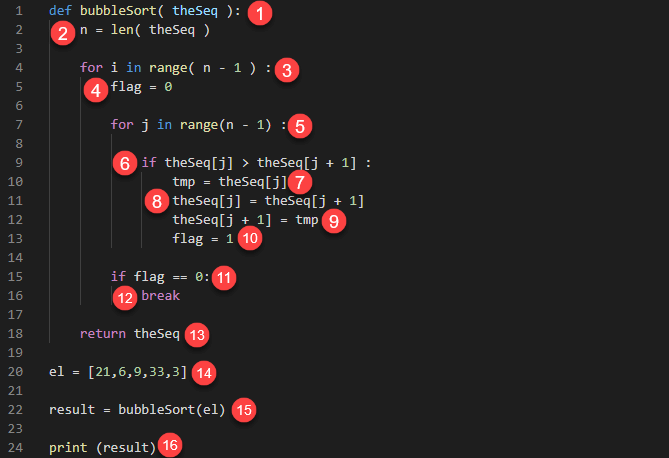
ここに、
- パラメータ theSeq を受け取る関数 bubbleSort を定義します。 コードは何も出力しません。
- 配列の長さを取得し、その値を変数nに代入します。このコードは何も出力しません。
- バブルソートアルゴリズムを(n-1)回実行するforループを開始します。これは外側のループです。このコードは何も出力しません。
- スワップが発生したかどうかを判断するために使用されるフラグ変数を定義します。これは最適化のためです。このコードは何も出力しません。
- リスト内のすべての値を最初から最後まで比較する内部ループを開始します。コードは何も出力しません。
- if ステートメントを使用して、左側の値がすぐ右側の値より大きいかどうかを確認します。 コードは何も出力しません。
- 条件が真と評価された場合、theSeq[j] の値を一時変数 tmp に代入します。このコードは何も出力しません。
- theSeq[j + 1] の値が theSeq[j] の位置に代入されます。このコードは何も出力しません。
- 変数tmpの値は、位置theSeq[j + 1]に代入されます。このコードは何も出力しません。
- フラグ変数には、スワップが行われたことを示す値1が割り当てられます。このコードは何も出力しません。
- if文を使って変数flagの値が0かどうかをチェックします。このコードは何も出力しません。
- 値が 0 の場合、break ステートメントを呼び出して内部ループから抜け出します。
- ソート後の theSeq の値を返します。 このコードは、ソートされたリストを出力します。
- 乱数のリストを含む変数 el を定義します。コードは何も出力しません。
- 関数 bubbleSort の値を変数の結果に割り当てます。
- 変数結果の値を出力します。
Bubbleソートの利点
バブルソートアルゴリズムの利点は以下のとおりです。
- わかりやすいですね。
- リストが既にソートされているか、ほぼソートされている場合に、非常に優れたパフォーマンスを発揮します。
- 大容量のメモリは必要ありません。
- アルゴリズムのコードを書くのは簡単だ。
- 他のソートアルゴリズムと比較して、必要なスペースは最小限です。
Bubbleソートのデメリット
バブルソートアルゴリズムの欠点は以下のとおりです。
- 大きなリストを並べ替える場合は、パフォーマンスが良くありません。 時間とリソースがかかりすぎます。
- これは主に学術目的で使用され、実社会での応用には用いられていない。
- リストをソートするのに必要なステップ数は n のオーダーです。2.
複雑性分析 Bubble 並べ替え
複雑さには3つの種類があります。
1) ソートの複雑さ
ソートの複雑度とは、リストをソートするのに必要な実行時間とメモリ容量を表す指標です。バブルソートでは、リストの要素総数をnとした場合、(n - 1)回の反復処理でリストをソートします。
2) 時間計算量
バブルソートの時間計算量はO(n2).
時間の複雑さは次のように分類できます。
- 最悪の場合 – ここでは、提供されたリストが降順で表示されます。 このアルゴリズムは、[Big-O] O(n として表される最大実行数を実行します)2).
- 最良の場合 これは、提供されたリストが既にソートされている場合に発生します。アルゴリズムは、[ビッグオメガ] Ω(n) で表される最小限の実行回数を実行します。
- 平均的なケース これはリストがランダムな順序になっている場合に発生します。平均複雑度は [Big-theta] ⊝(n2).
3) 空間の複雑さ
空間計算量は、リストをソートするために必要な追加スペースの量を測定するものです。バブルソートでは、スワップに使用される一時変数用に1つの追加スペースのみが必要です。ping 値。したがって、空間計算量はO(1)です。
