
TensorFlow を使用した人工ニューラルネットワーク (ANN) チュートリアル
 編集チーム
⚡ スマートサマリー
人工ニューラルネットワークは、入力データを接続された層に通し、損失関数で結果を評価し、オプティマイザで重みを調整することで学習します。このチュートリアルでは、TensorFlowで人工ニューラルネットワークを構築し、MNISTの数字を分類する方法を説明します。
人工ニューラルネットワークとは何ですか?
An 人工ニューラルネットワーク (ANN) 人工ニューラルネットワークは、生物学的ニューラルネットワークに着想を得たコンピュータシステムであり、人工ニューロンと呼ばれる接続されたユニットの集合に基づいて人工脳を構築します。人間と同じように情報を分析・処理するように設計されています。人工ニューラルネットワークは自己学習能力を備えており、利用可能なデータが増えるにつれてより良い結果を生み出します。
下の図 tracこれは、生の入力から重みを修正するオプティマイザまで、そのようなネットワークを1回完全に通過することを意味します。

人工ニューラル ネットワーク (ANN) は、次の XNUMX つの主要なオブジェクトで構成されます。
- 層: 学習はすべて各層で行われます。層は3つあります。1) 入力層、2) 隠れ層、3) 出力層です。
- 特徴とラベル: ネットワークへの入力データ(特徴量)とネットワークからの出力(ラベル)
- 損失関数: 学習フェーズのパフォーマンスを評価するために使用される指標
- オプティマイザ: ネットワーク内の知識を更新することで学習効果を高める
ニューラルネットワークは入力データを受け取り、それを複数の層からなるアンサンブルに投入します。そして、損失関数を用いてその性能を評価します。損失関数は、ネットワークが知識を習得するまでに辿るべき道筋を示します。ネットワークは最適化アルゴリズムを用いて、その知識を向上させていきます。
上の図を見ると、根底にあるメカニズムが理解できるでしょう。
このプログラムはいくつかの入力値を受け取り、それらを2つの全結合層に送り込みます。数学の問題を解くことを想像してみてください。まず最初に、その問題を解くための該当章を読みます。そして、その知識を問題に適用します。しかし、必ずしも高得点が取れるとは限りません。ネットワークも同様です。初めてデータを見て予測を行うとき、結果は実際のデータと完全に一致するわけではありません。
ネットワークは知識を向上させるためにオプティマイザを使用します。この例えで言えば、オプティマイザは章を読み返すことに例えることができます。読み返すことで新たな洞察が得られます。同様に、ネットワークはオプティマイザを使用して知識を更新し、その新しい知識をテストして、まだどれだけ学習する必要があるかを確認します。プログラムは、可能な限り低いエラーになるまでこの手順を繰り返します。
数学の問題に例えるなら、教科書の章を何度も読み返して、授業内容を完全に理解するまで続けるということです。何度も読んでも間違いが続く場合は、その教材の知識の限界に達したことを意味します。スコアを上げるには、別の教科書を使うか、別の方法を試す必要があります。ニューラルネットワークの場合も同じです。エラーが減少しなくなり、損失曲線が横ばいになった場合、現在のアーキテクチャではそれ以上学習できないことを意味します。知識を向上させるには、ネットワークをより最適化する必要があります。
これら4つのオブジェクトは、ネットワークを設計する際に構成するコンポーネントに直接対応しています。
ニューラルネットワーク Archi構造
人工ニューラルネットワークのアーキテクチャは、以下のコンポーネントで構成されています。
- 層
- アクティベーション機能
- 損失関数
- オプティマイザ
層
層とは、すべての学習が行われる場所です。層の中には、それぞれ独自の重みを持つ任意の数のニューロンが存在します。典型的なニューラルネットワークは、多くの場合、密結合層(全結合層とも呼ばれる)によって処理されます。これは、すべての入力が出力に接続されていることを意味します。
典型的なニューラルネットワークは、入力ベクトルとラベルを含むスカラー値を入力として受け取ります。最も単純な構成は、0と1の2つのクラスのみを持つ二値分類です。
ネットワークは入力を受け取り、接続されているすべてのノードに送信し、活性化関数を用いて信号を計算します。下の番号付き図は、単一のノードを拡大表示して、重み付き和と活性化ステップを個別に確認できるようにしたものです。

上の図はこの考え方を図示したものです。最初の層には入力値が保持されます。2番目の層は隠れ層と呼ばれ、前の層から重み付けされた入力を受け取ります。
- 最初のノードは入力値です。
- ニューロンは入力部と活性化関数に分解されます。左側の部分は前の層からのすべての入力を受け取ります。右側の部分は、活性化関数に渡された入力の合計です。
- 隠れ層から計算された出力値は、予測を行うために使用されます。分類の場合、出力値はクラス数に等しくなります。回帰の場合、予測される値は1つだけです。
アクティベーション機能
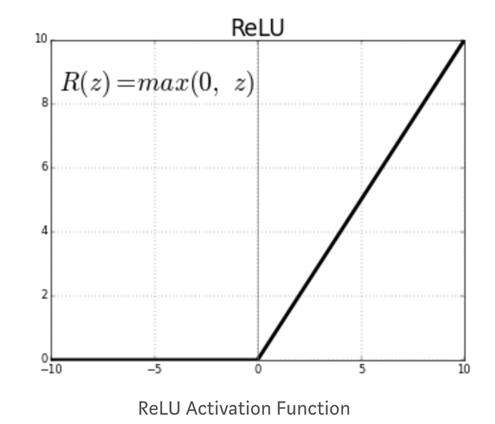
ノードの活性化関数は、一連の入力に対してどのような出力を与えるかを定義します。ネットワークが非線形パターンを学習できるようにするには、活性化関数が必要です。一般的な活性化関数として、ReLU(Rectified Linear Unit)があります。この関数は、負の値に対してはすべてゼロを返します。
他の活性化関数は次のとおりです。
- 区分線形
- シグモイド
- タン
- リーキーReLU
下のグラフは、ReLUがなぜそのように説明されるのかを示しています。曲線は、負の入力に対してはゼロで平坦になり、その後は直線的に上昇します。
ニューラル ネットワークを構築する際に行う重要な決定は次のとおりです。
- ニューラルネットワークの層の数
- 各レイヤーの隠れユニットの数
層と隠れユニットを多数持つニューラルネットワークは、データの複雑な表現を学習できるが、ネットワークの計算コストが非常に高くなる。
損失関数
隠れ層と活性化関数を定義した後、損失関数とオプティマイザーを指定する必要があります。
二値分類では、二値交差エントロピー損失関数を使用するのが一般的です。 線形回帰平均二乗誤差を使用します。
損失関数は、オプティマイザーのパフォーマンスを推定するための重要なメトリックです。 トレーニング中、このメトリクスは最小化されます。 対処している問題の種類に応じて、この量を慎重に選択する必要があります。
オプティマイザ
損失関数は、モデルの性能を測る指標です。オプティマイザは、損失を減らすためにネットワークの重みを調整します。利用可能なオプティマイザはいくつかありますが、最も一般的なのは確率的勾配降下法です。
従来のオプティマイザは次のとおりです。
- Momentum 最適化
- ネステロフ加速勾配
- アダグラッド
- アダムの最適化
Archi構造だけでは、実用的なモデルを保証するものではない。
ニューラルネットワークの限界
ニューラルネットワークの限界は以下のとおりです。
オーバーフィット
複雑なニューラルネットワークに共通する問題点の一つは、未知のデータへの一般化が難しいことです。重みの数が多いニューラルネットワークは、訓練データセット内の特定の詳細を非常にうまく識別できますが、それが過学習につながることがよくあります。グループ内でデータが不均衡な場合(つまり、一部のグループで十分なデータがない場合)、ネットワークは訓練中に非常にうまく学習しますが、そのようなパターンをこれまで見たことのないデータに一般化する能力は持ち合わせていません。
トレードオフがある 機械学習 最適化と汎化の間。
- モデルを最適化するには、訓練データセットの損失を最小限に抑える最適なパラメータを見つける必要がある。
- ただし、一般化すると、目に見えないデータに対してモデルがどのように動作するかがわかります。
モデルがトレーニングデータの特定の詳細や望ましくないパターンを捉えてしまうのを防ぐには、さまざまな手法を用いることができます。最良の方法は、十分な量のデータを含むバランスの取れたデータセットを用意することです。過学習を抑制する手法は正則化と呼ばれます。以下の3つの手法は、一般的な出発点となります。
| 技術 | それが制約するもの | このチュートリアルにおける典型的な設定 |
|---|---|---|
| ネットワークサイズ | 層の数と隠れユニット数 | 2つの隠し層、300ユニットと100ユニット |
| L1/L2重み正則化 | 重み係数の大きさ | l1_regularization_strengthとl2_regularization_strengthは0.01 |
| ドロップアウト | トレーニングステップごとにオフになったユニットの割合 | ドロップアウト率0.3 |
ネットワークサイズ
層や隠れユニットが多すぎるニューラルネットワークは、非常に複雑であることが知られています。モデルの複雑さを軽減する簡単な方法は、サイズを小さくすることです。層の数を決定するための唯一のベストプラクティスはありません。まずは少数の層から始め、モデルが過学習を起こすまでサイズを増やしていく必要があります。
重みの正規化
過学習を防ぐための標準的な手法は、ネットワークの重みに制約を追加することです。この制約により、ネットワークの重みは小さな値しか取らなくなります。制約は誤差の損失関数に追加されます。正則化には2種類あります。
- L1(投げ縄): コストは、重み係数の絶対値に比例する。
- L2(リッジ): コストは、重み係数の値の二乗に比例する。
ドロップアウト
ドロップアウトは、一見奇妙に思えるかもしれませんが、非常に便利な手法です。ドロップアウトを備えたネットワークでは、トレーニング中に一部のユニットがランダムにオフになり、出力信号がゼロになります。例えば、重みの配列が [0.1, 1.7, 0.7, -0.9] であるとします。ニューラルネットワークにドロップアウトがあると、配列は [0.1, 0, 0, -0.9] となり、0 がランダムに分布します。ドロップアウトを制御するパラメータはドロップアウト率です。この率は、オフになるユニットの数を定義します。一般的には、0.2 から 0.5 の間の値が使用されます。
簡単なインタラクティブな例を用いることで、トレーニングループを簡単に観察できます。
TensorFlow のニューラル ネットワークの例
以下に、人工ニューラルネットワークの動作例を示します。これは、ニューラルネットワークが典型的な分類問題でどのように機能するかを示しています。入力は x1 と x2 の 2 つで、それぞれランダムな値です。出力はバイナリクラスです。目的は、2 つの特徴に基づいてラベルを分類することです。このタスクを実行するために、ニューラルネットワークのアーキテクチャは次のように定義されます。
- XNUMX つの隠れ層
- 最初の層には完全に接続された XNUMX つのニューロンがあります
- XNUMX 番目の層には完全に接続された XNUMX つのニューロンがあります
- 活性化関数はReLUです
- 学習率 2 の L0.003 正則化を追加します。
ネットワークは、バッチサイズ10で180エポックにわたって重みを最適化します。以下のANNの例のアニメーションでは、重みが時間とともにどのように変化し、ネットワークが分類マップをどのように改善していくかを確認できます。ping.

まず、ネットワークはすべての重みにランダムな値を割り当てます。
- ランダムな重み、つまり最適化を行わない場合、出力損失は0.453です。下の図は、異なる色で表されたネットワークを示しています。
- 一般に、オレンジ色は負の値を表し、青色は正の値を示します。
- データポイントは同じ表現方法で表されます。青色のポイントは正のラベル、オレンジ色のポイントは負のラベルを表します。

2番目の隠し層では、線は重みの符号に応じて色分けされています。オレンジ色の線は負の重みを、青色の線は正の重みを表します。
ご覧のとおり、出力マップではpingつまり、ネットワークはかなり多くの間違いを犯しているということです。では、最適化後のネットワークの動作を見てみましょう。
以下のANNの例の図は、最適化されたネットワークの結果を示しています。まず、ネットワークがデータポイントの分類方法を正常に学習していることがわかります。前の図と比較すると、初期の重みは-0.43でしたが、最適化後は-0.95になっています。

このアイデアは、より多くの隠れ層とニューロンを持つネットワークにも一般化できます。設定は自分で試すことができます。 TensorFlow プレイグラウンド.
以下のチュートリアルでは、実際のデータセットに対して、同じアイデアをコードで構築します。
TensorFlow を使用してニューラル ネットワークをトレーニングする方法
ニューラルネットワークをトレーニングする方法のステップバイステップのプロセスは次のとおりです。 TensorFlow APIの推定器であるDNNClassifierを使用したANN。
MNIST データセットを使用して、最初のニューラル ネットワークをトレーニングします。 ニューラルネットワークをトレーニングする TensorFlow それほど複雑ではありません。前処理の手順は、以前のチュートリアルと全く同じです。以下の手順に従ってください。
- データをインポートする
- データを変換する
- テンソルを構築する
- モデルを構築する
- モデルのトレーニングと評価
- モデルを改善する
バージョンノート: このチュートリアルで使用するコードは、TensorFlow 1.x Estimator API を対象としています。tf-estimator パッケージの最終リリースは TensorFlow 2.15 に同梱され、tf.estimator は TensorFlow 2.16 で削除されました。最新リリースでこれらの手順を実行するには、TensorFlow 2.15 に固定するか、tf.keras.layers.Dense と model.fit() を使用して同じ 2 層ネットワークを再構築してください。
ステップ 1) データをインポートする
まず、必要なライブラリをインポートする必要があります。MNISTデータセットは、以下の方法でインポートできます。 scikit-学ぶ 以下のTensorFlowニューラルネットワークの例に示すように。
MNISTデータセットは、新しい技術やアルゴリズムをテストする際に最も一般的に使用されるデータセットです。これは、それぞれ0から9までの手書き数字が描かれた28×28ピクセルの画像の集合です。弾性歪みを用いて学習させた深層畳み込みネットワークの委員会は、テスト誤差を0.27パーセントまで低減しました。
import numpy as np
import tensorflow as tf
np.random.seed(1337)
元の手順では、MNISTファイルを手動でダウンロードし、fetch_mldataにそのフォルダを指定していました。
from sklearn.datasets import fetch_mldata
mnist = fetch_mldata(' /Users/Thomas/Dropbox/Learning/Upwork/tuto_TF/data/mldata/MNIST original')
print(mnist.data.shape)
print(mnist.target.shape)
APIに関する注記: mldata.org は現在オンラインではなく、fetch_mldata は scikit-learn 0.22 で削除されました。最新のインストール環境では、上記の呼び出しを fetch_openml('mnist_784', version=1) に置き換えてください。これにより、同じ 70,000 桁の数字がダウンロードされ、同一のデータとターゲット属性が利用可能になります。
その後、データを分割して、両方のデータセットの形状を取得します。
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(mnist.data, mnist.target, test_size=0.2, random_state=42)
y_train  = y_train.astype(int)
y_test  = y_test.astype(int)
batch_size =len(X_train)

print(X_train.shape, y_train.shape,y_test.shape )
ステップ 2) データを変換する
前回のチュートリアルでは、外れ値の影響を抑えるためにデータを変換する必要があることを学びました。今回のニューラルネットワークのチュートリアルでは、最小最大スケーラーを使用してデータを変換します。その式は次のとおりです。
(X-min_x)/(max_x - min_x)
scikit-learnには既にそのための関数があります:MinMaxScaler()
## resclae
from sklearn.preprocessing import MinMaxScaler
scaler = MinMaxScaler()
# Train
X_train_scaled = scaler.fit_transform(X_train.astype(np.float64))
# test
X_test_scaled = scaler.fit_transform(X_test.astype(np.float64))
ステップ 3) テンソルを構築する
これで作成方法がわかりました テンソル TensorFlowでは、トレーニングセットを数値列に変換できます。
feature_columns = [tf.feature_column.numeric_column('x', shape=X_train_scaled.shape[1:])]
ステップ 4) モデルを構築する
ニューラルネットワークのアーキテクチャは、2つの隠れ層で構成されており、第1層は300ユニット、第2層は100ユニットです。これらの値は、公式ではなく経験に基づいて決定されています。これらの値を調整して、ネットワークの精度にどのような影響を与えるかを確認できます。
モデルを構築するには、推定器 DNNClassifier を使用します。トレーニング セットには 10 個のクラスがあるため、クラス数を 10 に設定する必要があります。推定器オブジェクトの構文は既にご存知でしょう。引数 feature_columns、n_classes、model_dir は、前回のチュートリアルとまったく同じです。引数 hidden_units は新しい引数で、レイヤーの数と、各レイヤーがニューラル ネットワークに接続するノードの数を制御します。以下のコードでは、2 つの隠れ層があり、最初のレイヤーは 300 個のノードを、2 番目のレイヤーは 100 個のノードを接続しています。
推定子を構築するには、次のパラメータを指定して tf.estimator.DNNClassifier を使用します。
- 特徴列: ネットワークで使用する列を定義します
- 隠しユニット: 隠れニューロンの数を定義する
- n_classes: 予測するクラスの数を定義する
- モデルディレクトリ: パスを定義する テンソルボード
estimator = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    n_classes=10,
    model_dir = '/train/DNN')
ステップ 5) モデルのトレーニングと評価
NumPyの入力関数を使用して、モデルの学習と評価を行うことができます。
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_train_scaled},
    y=y_train,
    batch_size=50,
    shuffle=False,
    num_epochs=None)
estimator.train(input_fn = train_input,steps=1000)
eval_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_test_scaled},
    y=y_test,
    shuffle=False,
    batch_size=X_test_scaled.shape[0],
    num_epochs=1)
estimator.evaluate(eval_input,steps=None)
出力:
{'accuracy': 0.9637143,
 'average_loss': 0.12014342,
 'loss': 1682.0079,
 'global_step': 1000}
現在のアーキテクチャでは、評価セットにおける精度は約96パーセントとなる。
ステップ 6) モデルを改善する
正則化パラメーターを追加して、モデルの改善を試みることができます。
ここでは、推定器はドロップアウト率0.3、L1およびL2強度をともに0.01に設定したProximal AdaGradオプティマイザを使用します。TensorFlowニューラルネットワークでは、trainオブジェクトの後にオプティマイザの名前を指定することでオプティマイザにアクセスできます。TensorFlowには、Proximal AdaGradオプティマイザ用の組み込みAPIが用意されています。
深層ニューラルネットワークに正則化を追加するには、tf.train.ProximalAdagradOptimizer を以下のパラメータで使用できます。
- 学習率: Learning_rate
- L1正則化: l1正則化の強度
- L2正則化: l2正則化の強度
estimator_imp = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    dropout=0.3,
    n_classes = 10,
    optimizer=tf.train.ProximalAdagradOptimizer(
      learning_rate=0.01,
      l1_regularization_strength=0.01,
      l2_regularization_strength=0.01
    ),
    model_dir = '/train/DNN1')
estimator_imp.train(input_fn = train_input,steps=1000)
estimator_imp.evaluate(eval_input,steps=None)
出力:
{'accuracy': 0.95057142,
 'average_loss': 0.17318928,
 'loss': 2424.6499,
 'global_step': 2000}
過学習を抑制するために選択した値は、モデルの精度を向上させませんでした。最初のモデルの精度は96%でしたが、L2正則化を適用したモデルの精度は95%でした。さまざまな値を試して、精度への影響を確認してみてください。
