
Informatica でのアグリゲーター変換の例
 デビッドカーター
⚡ スマートサマリー
Informaticaにおけるアグリゲーター変換は、行のグループ全体にわたって合計、平均、カウントなどの計算を実行するアクティブなオブジェクトであり、各グループの処理が完了するまで、それらの行を集計キャッシュに保持します。
アグリゲーター変換とは何ですか?
集計変換とは、合計、平均、個数などの集計計算を実行するアクティブな変換です。
例えば、全従業員の給与を部署ごとに合計したい場合は、アグリゲーター変換を使用できます。
集計操作は行のグループに対して実行されるため、これらすべてのレコードを保存して計算を実行するには一時的なプレースホルダーが必要です。
このためには、アグリゲータキャッシュが使用されます。これは、アグリゲータ変換に割り当てられた一時的なメインメモリであり、このような操作を実行するために使用されます。アグリゲータキャッシュは2つの部分に分かれており、インデックスキャッシュにはグループ値が格納され、データキャッシュには集計対象の行データが格納されます。
この変換処理は、パイプライン内の行数を変更するため、アクティブな処理です。数千件の従業員レコードがパイプラインに入力され、部門ごとに1行のみが出力されます。
Informaticaでアグリゲーター変換を使用する方法
この例では、部門別に給与の合計を計算します。このためには、この合計を格納するための新しい列が必要です。まず、新しい列を準備します。
ステップ1) 以下のスクリプトを使用して、たとえば「sum_sal_deptwise」という新しいデータベースターゲットテーブルを作成します。新しいデータベースターゲットテーブルは、 Target次のステップでsフォルダを開きます。
上記のCreate_table_sal_deptwise.txtファイルをダウンロードします。
ステップ2) 新しいを作成します 地図ping 「m_sum_sal_deptwise」
新しい地図を作成するためにpingマップにはソーステーブル(EMP)とターゲットテーブル(sum_sal_deptwise)が必要ですping デザイナーなので、
- マップにターゲットテーブル「sum_sal_deptwise」をインポートします。ping.
- ソーステーブル「emp」をインポートします。
両方の定義が、以下に示すようにキャンバス上に表示されます。
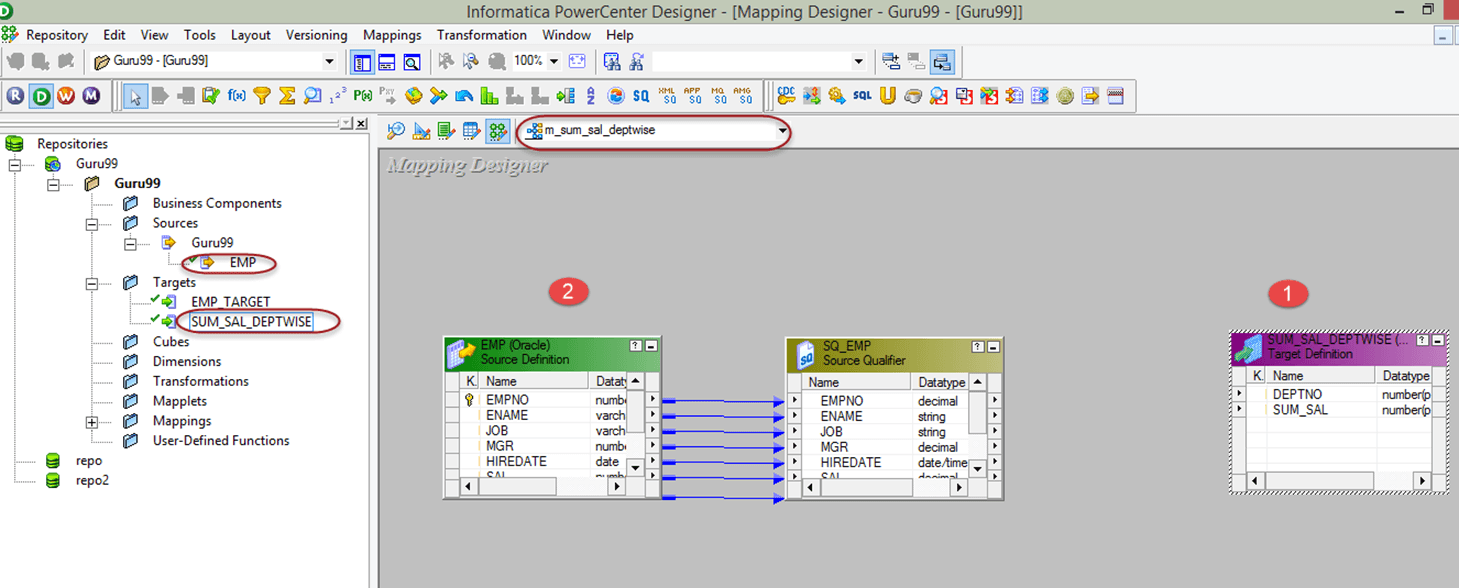
ステップ3) 地図上でping,
- ノーザンダイバー社の ソース修飾子empno、ename、job、mgr、hiredate、comm の列を削除し、deptno と sal の列だけを残します。
- スクリーンショットに示すように、ツールボックスメニューを使用して新しいアグリゲーター変換を作成します。アグリゲーターアイコンをクリックすると、新しいアグリゲーター変換が作成されます。
新しいAGGTRANSオブジェクトは、トリミングされたソース修飾子の横に表示されます。

ステップ4) ソース修飾子(SQ_EMP)からSAL列とDEPTNO列をアグリゲーター変換にドラッグアンドドロップします。これで2つのポートがAGGTRANSにリンクされます。

ステップ5) Double-アグリゲーター変換をクリックしてプロパティを開き、
- 変換に新しいポートを追加します
- ポート名をSUM_SALに変更する
- この新しいポートのデータ型をdoubleに変更します
- 出力ポートのチェックボックスを選択して、このポートを出力ポートにします。
- 表現オプションをクリックします
「ポート」タブに、SAL、DEPTNO、および新しい出力ポートSUM_SALが表示されるようになりました。

ステップ6) 式エディターウィンドウで
- 式 sum(SAL) を追加してください。この式は自分で記述する必要があります。
- 「OK」ボタンを選択すると、「変換の編集」ウィンドウが再び表示されます。
式エディタには、SUM_SALに割り当てられた集計式が表示されます。

ステップ7) 「変換の編集」ウィンドウで、「deptno」列のチェックボックスをオンにして「GroupBy」オプションを選択し、「OK」をクリックします。deptnoに対して「GroupBy」を選択することで、Informaticaに給与をdeptnoごとにグループ化するように指示します。

ステップ8) Aggregator変換のdeptno列とsum_sal列をターゲットテーブルにリンクします。ping すると、ソースからターゲットまで処理が完了します。

これでマップを保存できますping そして新しいものを作成した後にそれを実行する セッション この地図についてはpingターゲットテーブルには、部門別の給与の合計が含まれます。このようにして、アグリゲーター変換を使用して集計結果を計算できます。
アグリゲーター変換におけるポートによるグループ化
上記の手順で、単一のポートを「グループ化」として指定しました。これにより、会社全体の合計値が部門ごとの合計値に変換されます。入力ポート、入出力ポート、出力ポート、可変ポートなど、どのポートでも同様の方法でグループ化できます。
結果セットを決定する3つのルール:
- グループごとに1行。 値がグループ化される場合、統合サービスは、グループ化ポートの固有の組み合わせごとに1行を生成します。
- グループ化なし、1行。 ポートが指定されていない場合、入力全体が単一のグループとして扱われ、すべての入力行に対して1行が返されます。
- 最後列が勝ちです。 集計結果に加えて、統合サービスは通常、グループ内で受信した最後の行を渡します。ただし、FIRSTなどの関数によって別の行が指定されている場合は除きます。
複数の港がマークされている場合、港の順序によってグループが決定されますping 順序によって結果が変わる可能性があります。ping DEPTNO と JOB はグループとは異なりますping 2列目の値は必ずしも一意ではないため、JOB、次にDEPTNOの順で並べます。
アグリゲーター変換プロパティ
「変換の編集」ウィンドウの「プロパティ」タブには、キャッシュの保存場所と使用量を決定する設定があります。以下の表にそれらの設定を示します。
| Setting | 制御するもの |
|---|---|
| キャッシュディレクトリ | 統合サービスがインデックスファイルとデータキャッシュファイルを作成するローカルディレクトリ。デフォルトでは、ワークフローマネージャで設定されているプロセス変数$PMCacheDirが使用されます。 |
| Tracレベル | この変換処理に関してセッションログに書き込まれる詳細情報の量。 |
| ソートされた入力 | 受信データがポートごとにグループ分けされていることを宣言します。マップがping 本当にきちんと整理されたデータを提供してくれる。 |
| アグリゲーターデータキャッシュサイズ | データキャッシュのサイズ。デフォルト値は2,000,000バイトで、「自動」を選択すると統合サービスがサイズを決定します。 |
| アグリゲーターインデックスキャッシュサイズ | インデックスキャッシュのサイズ。デフォルト値は1,000,000バイトで、「自動」を選択すると統合サービスがサイズを決定します。 |
| 変革の範囲 | 各トランザクション、またはすべての受信データに対してロジックを適用します。「すべての入力」を選択すると、受信トランザクションの境界は破棄されます。 |
増分集計が有効になっている場合、インテグレーションサービスは実行ごとにキャッシュファイルのバックアップを作成するため、キャッシュディレクトリには1セットではなく2セットのファイルが格納される必要があります。
集計式のルールとパフォーマンスに関するヒント
集計式は、集計関数と条件節、および非集計関数を組み合わせることができ、これにより、1つのポート内で条件付き合計とカウントが可能になります。記述できる内容は、2つのルールによって制限されます。
- 入れ子構造は1段階。 集約関数は1つだけを別の集約関数の中にネストすることができ、内側の式が先に評価されます。
- 混ぜないでください。 変換には、単一レベルの関数またはネストされた関数のいずれかを含めることができますが、両方を含めることはできません。両方が含まれている場合、デザイナーはマップにマークを付けます。ping 無効なため、ロジックを2つのアグリゲーター変換に分割します。
チューニングに関しては、以下の3つの設定でほとんどの作業が行われます。
- ソートされた入力。 ポートごとにグループ分けされた行が到着すると、各グループは最後の行が到着次第すぐに解放されるため、キャッシュされるデータ量が少なくなり、セッションの実行速度が向上します。ただし、ソートされた入力は増分集計と組み合わせることはできません。
- 段階的な集計。 新しいソース行はマップを通して渡されますping また、履歴を再計算するのではなく、履歴キャッシュと組み合わせることで、毎晩の読み込みによる累計値への反映に適しています。
- 早めに選別する。 合計に貢献しない行は、ソース修飾子クエリまたはアグリゲーターの前に削除する必要があります。 フィルタ変換なぜなら、アグリゲーターに到達する行ごとにキャッシュメモリが消費されるからです。これは、処理中の標準的なチェックの 1 つです。 性能調整.
