
隣接リストとグラフの行列表現
 サラ・チェン
⚡ スマートサマリー
グラフの隣接リスト表現と隣接行列表現は、頂点と辺をメモリに格納し、アルゴリズムがネットワークを走査できるようにする。隣接リストは頂点ごとにリンクリストを使用するのに対し、隣接行列は正方形の2次元グリッドを使用する。
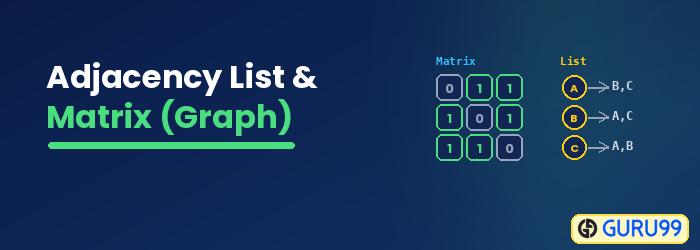
見た目は違っても、みんな グラフの種類 同様の方法で表現できます。グラフ表現には一般的に2種類あります。
- 隣接行列
- 隣接リスト
隣接リスト
隣接リストは連結リストで構成されます。各頂点は配列のインデックスとみなされ、各要素は連結リストを表します。これらの連結リストには、インデックス頂点と辺を共有する頂点が含まれます。
隣接リストの例を以下に示します。

グラフに頂点がV個、辺がE個あるとする。隣接リストの空間計算量は O(V + E)これは、考えられるすべての頂点のペアではなく、実際のエッジの数に応じてスケーリングされます。
最悪の場合の空間計算量は O(V²) 与えられたグラフが完全グラフである場合、すべての頂点が他のすべての頂点と接続されます。
隣接行列
隣接行列は2次元配列で構成されます。頂点数がVのグラフの場合、行列のサイズは次のようになります。 V × V.
いう matrix[i][j] = 5これは、ノード i とノード j の間に重みが 5 のエッジが存在することを意味します。
次のグラフとその隣接行列を見てみましょう。

私たちは 2D配列 次の手順を使用します。
ステップ1) 頂点Aは頂点Bと直接辺で結ばれており、その重みは5です。したがって、A行B列のセルには5が入ります。A行の残りのセルには0が入ります。
ステップ2) 頂点Bは頂点Cと直接辺で結ばれており、その重みは4です。したがって、B行C列のセルには4が入ります。Bは他のどのノードにも出ていないため、B行の残りのセルには0が入ります。
ステップ3) 頂点Cは他のどの頂点とも直接的な辺を持たない。したがって、行Cはすべてゼロで埋められる。
ステップ4) 頂点Dは、頂点Aおよび頂点Cと有向辺で結ばれている。
- D行A列のセルには7の値が入ります。D行C列のセルには2の値が入ります。
- 行 D の残りのセルはゼロで埋められます。
ステップ5) 頂点EはBおよびDと有向辺で結ばれています。E行B列のセルには6の値が入ります。E行D列のセルには3の値が入ります。E行の残りのセルには0が入ります。
注意すべき点がいくつかあります。
- 隣接行列の主対角線が0の場合、グラフには自己ループは存在しない。
- グラフは、(a, b)と(b, a)のセルが同じ値を持たない場合に有向グラフとなる。そうでない場合は無向グラフとなる。
- いずれかのセルの値が1より大きい場合、そのグラフは重み付きグラフである。
隣接行列の主な問題点は、正方形のメモリ領域を必要とすることである。存在しないエッジであっても、メモリ上にセルを割り当ててしまう。
例えば、100個のノードを持つグラフがある場合、それを格納するために10,000個のセルが必要になります。 RAMグラフのエッジが少ない場合、このような大きなメモリを割り当てるのは無駄になる可能性があります。したがって、隣接行列を使用した空間計算量は次のようになります。 O(N²)ここで、Nはグラフ内のノード数である。
隣接リストと隣接行列の比較
表現方法を選択する前に、実際のグラフワークロードで支配的な操作に関して、両方のモデルを並べて比較することが役立ちます。
| Opera生産 | 隣接行列 | 隣接リスト |
|---|---|---|
| 空間複雑性 | O(V²) | O(V + E) |
| 頂点を追加する | O(V²) | O(1) |
| エッジを加える | O(1) | O(1) |
| 端を取り除く | O(1) | O(エ) |
| エッジ(i, j)が存在するかどうかを確認します。 | O(1) | O(iの次数) |
| i の近傍を反復処理する | O(V) | O(iの次数) |
| ベスト | 密なグラフ、頻繁なエッジクエリ | 疎なグラフ、走査負荷の高いタスク |
要するに、隣接行列は定数時間でのエッジ検索に優れており、隣接リストはメモリと隣接ノードの反復処理に優れているため、BFS、DFS、ダイクストラ法などのアルゴリズムは通常、隣接リストと組み合わせて使用される。
グラフ表現の利点と欠点
それぞれの表現方法には、独自のトレードオフが存在します。両モデルの長所と短所を理解することで、解決しようとしている問題に最適なモデルを選択することができます。
隣接行列の利点:
- 任意の2つの頂点間の辺の存在確認クエリは定数時間O(1)で実行できます。
- 固定インデックスを用いることで、フロイド・ウォーシャル法や推移閉包法といった行列ベースのアルゴリズムを容易に実装できる。
- 重み付けされたエッジは、単一のマトリックスセル内に自然に収まります。
隣接行列の欠点:
- グラフが疎な場合、O(V²)のメモリを無駄に消費する。
- 新しい頂点を追加するには、行列全体のサイズを変更する必要があります。
- 単一の頂点の隣接頂点を反復処理するには、その頂点が少数のエッジしか持たない場合でも、O(V) の時間がかかります。
隣接リストの利点:
- 使用するメモリ量はO(V + E)のみで、これは疎グラフにおける実際のエッジ数に近い値です。
- 新しい頂点や辺を追加するのはO(1)です。
- BFSやDFSなどの探索アルゴリズムは、O(次数)で隣接ノードを反復処理するため、全体の実行時間はO(V + E)となります。
隣接リストの欠点:
- 特定のエッジが存在するかどうかを確認するのにかかる時間は、O(1)ではなくO(次数)になります。
- リンクリストはメモリ全体に分散しているため、キャッシュの局所性は弱くなります。
- 重み付きエッジには、対応するフィールドまたはペアのリストが必要となり、データ構造がやや複雑になります。
隣接リストと隣接行列の使い分け
表現方法の選択は、グラフの密度と最も頻繁に実行する操作によって異なります。適切な構造を選択するには、以下のクイックガイドを参照してください。
- 隣接行列を優先する グラフが密である場合(E が V² に近い場合)、エッジがほとんど変化しない場合、およびアルゴリズムが「i と j の間にエッジはありますか?」と何度も尋ねる場合。
- 隣接リストを優先する グラフが疎である場合 (E が V² よりはるかに小さい場合)、実行中に頂点またはエッジのセットが増加する場合、BFS、DFS、または ダイクストラの最短経路アルゴリズム.
- 混合モデルを好む (隣接リストとエッジのハッシュセット)高速な隣接反復と O(1) のエッジクエリの両方が必要な場合、追加のメモリを犠牲にして使用します。
NetworkXやigraphといった最新のグラフライブラリは、隣接リストをデフォルトとして使用します。これは、ソーシャルネットワーク、道路地図、ウェブページ、パッケージの依存関係など、現実世界のグラフのほとんどが疎で、走査処理が多いためです。
