
Incorporamento di parole e Word2Vec con esempio
 Evelyn Clarke
⚡ Riepilogo intelligente
Word Embedding e Word2Vec convertono il testo in vettori numerici densi, consentendo ai modelli di apprendimento automatico di riconoscere parole con significato simile. Questa risorsa illustra la tecnica, le sue architetture CBOW e Skip-Gram, le funzioni di attivazione e un'implementazione completa in Gensim per applicazioni reali.
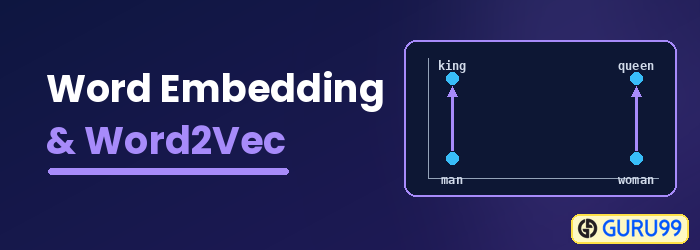
Cos'è l'incorporamento di parole?
Incorporamento di parole è un tipo di rappresentazione delle parole che consente agli algoritmi di apprendimento automatico di comprendere parole con significati simili. È una tecnica di modellazione del linguaggio e di apprendimento delle caratteristiche per mappare le parole in vettori di numeri reali utilizzando reti neurali, modelli probabilistici o riduzione della dimensionalità sulla matrice di co-occorrenza delle parole. Alcuni modelli di word embedding sono Word2vec (Google), GloVe (Stanford) e fastText (Facebook).
L'embedding di parole è anche chiamato modello semantico distribuito, modello rappresentato distribuito, spazio vettoriale semantico o modello di spazio vettoriale. Mentre leggi questi nomi, ti imbatti nella parola semanticoCiò significa categorizzare insieme parole simili. Ad esempio, frutti come mela, mango e banana dovrebbero essere posizionati vicini, mentre i libri saranno posizionati lontani da queste parole. In senso più ampio, l'embedding di parole creerà un vettore di frutti che sarà posizionato lontano dalla rappresentazione vettoriale dei libri.
Dove viene utilizzato l'incorporamento delle parole?
L'incorporamento di parole (word embedding) è utile per la generazione di caratteristiche, il clustering di documenti, la classificazione del testo e le attività di elaborazione del linguaggio naturale. Elenchiamo queste applicazioni e analizziamole una per una.
- Calcola parole simili: L'embedding di parole viene utilizzato per suggerire parole simili alla parola sottoposta al modello di previsione. Oltre a ciò, suggerisce anche parole dissimili, nonché le parole più comuni.
- Crea un gruppo di parole correlate: Viene utilizzato per il gruppo semanticopingche raggruppa elementi con caratteristiche simili e allontana quelli dissimili.
- Funzionalità per la classificazione del testo: Il testo viene mappato in array di vettori che vengono forniti al modello per l'addestramento e la previsione. I modelli di classificazione basati sul testo non possono essere addestrati su stringhe, quindi questo converte il testo in un formato addestrabile automaticamente. Le sue funzionalità di costruzione semantica contribuiscono ulteriormente alla classificazione basata sul testo.
- Cluster di documenti: Questa è un'altra applicazione in cui Word Embedding e Word2vec sono ampiamente utilizzati.
- Elaborazione del linguaggio naturale: Esistono molte applicazioni in cui l'incorporamento di parole è utile e prevale sull'expressione delle funzionalitàtracfasi di analisi, come l'etichettatura delle parti del discorso, l'analisi del sentiment e l'analisi sintattica.
Ora che avete capito dove viene applicato l'embedding di parole, analizziamo il modello più diffuso utilizzato per creare questi embedding.
Cos'è Word2vec?
Parola2vec È una tecnica o un modello che produce word embedding per una migliore rappresentazione delle parole. Si tratta di un metodo di elaborazione del linguaggio naturale che cattura un gran numero di precise relazioni sintattiche e semantiche tra le parole. È una rete neurale a due strati poco profonda che, una volta addestrata, può rilevare parole sinonime e suggerire parole aggiuntive per frasi parziali.
Prima di procedere, si prega di osservare la differenza tra una rete neurale superficiale e una rete neurale profonda, come mostrato nel diagramma di esempio di word embedding riportato di seguito:
Una rete neurale superficiale è composta da un solo strato nascosto tra input e output, mentre una rete neurale profonda contiene più strati nascosti tra input e output. L'input è gestito dai nodi, mentre lo strato nascosto, così come lo strato di output, contiene neuroni.
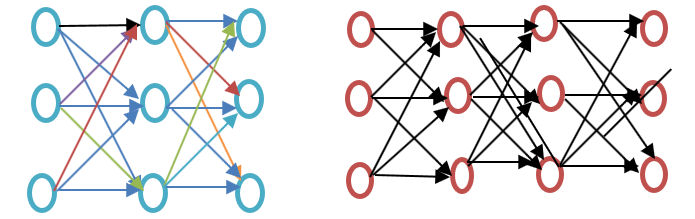
Word2vec è una rete a due strati composta da un input, uno strato nascosto e un output.
Word2vec è stato sviluppato da un gruppo di ricercatori guidato da Tomas Mikolov presso GoogleWord2vec è migliore e più efficiente del modello di analisi semantica latente.
Perché Word2vec?
Word2vec rappresenta le parole in uno spazio vettoriale. Le parole sono rappresentate sotto forma di vettori e il loro posizionamento è tale che le parole con significato simile appaiano vicine, mentre quelle con significato diverso siano distanti tra loro. Questa viene anche definita relazione semantica. Le reti neurali non comprendono il testo, ma solo i numeri. Word Embedding offre un modo per convertire il testo in un vettore numerico.
Word2vec ricostruisce il contesto linguistico delle parole. Prima di procedere, cerchiamo di capire cosa si intende per contesto linguistico. In generale, quando parliamo o scriviamo per comunicare, gli altri cercano di capire lo scopo della frase. Ad esempio, "Qual è la temperatura dell'India?" In questo caso, il contesto è che l'utente vuole sapere "la temperatura dell'India". In breve, lo scopo principale di una frase è il contesto. Le parole o le frasi che circondano il linguaggio parlato o scritto aiutano a determinare il significato del contesto. Word2vec apprende la rappresentazione vettoriale delle parole attraverso questi contesti.
Cosa fa Word2vec?
Prima dell'incorporamento delle parole
È importante sapere quale approccio veniva utilizzato prima dell'embedding di parole e quali sono i suoi svantaggi, per poi vedere come questi svantaggi vengono superati dall'embedding di parole tramite l'approccio Word2vec. Infine, passeremo a spiegare come funziona Word2vec, poiché è fondamentale comprenderne il funzionamento.
Approccio per l'analisi semantica latente
Questo è l'approccio utilizzato prima degli word embedding. Si basava sul concetto di "bag of words" (sacchetto di parole), in cui le parole sono rappresentate sotto forma di vettori codificati. Si tratta di una rappresentazione vettoriale sparsa in cui la dimensione è pari alla dimensione del vocabolario. Se la parola è presente nel dizionario, viene conteggiata; altrimenti, non lo è. Per maggiori informazioni, si prega di consultare il programma seguente.
Esempio Word2vec

from sklearn.feature_extraction.text import CountVectorizer

vectorizer = CountVectorizer()
data_corpus = ["guru99 is the best site for online tutorials. I love to visit guru99."]
vocabulary = vectorizer.fit(data_corpus)
X = vectorizer.transform(data_corpus)

print(X.toarray())
print(vectorizer.get_feature_names_out())
Produzione:
[[1 2 1 1 1 1 1 1 1 1]]
[u'best', u'guru99', u'is', u'love', u'online', u'sitefor', u'the', u'to', u'tutorials', u'visit']
Code Spiegazione
- CountVectorizer è il modulo utilizzato per memorizzare il vocabolario in base alla corrispondenza delle parole al suo interno. Viene importato da sklearn.
- Crea l'oggetto utilizzando la classe CountVectorizer.
- Scrivi i dati nell'elenco che devono essere inseriti nel CountVectorizer.
- I dati sono inseriti nell'oggetto creato dalla classe CountVectorizer.
- Applica un approccio "bag-of-words" per contare le parole nei dati utilizzando il vocabolario. Se una parola o un token non è presente nel vocabolario, la relativa posizione dell'indice viene impostata a zero.
- La variabile alla riga 5, che è x, viene convertita in un array (un metodo disponibile per x). Questo fornisce il conteggio di ogni token nella frase o nell'elenco fornito alla riga 3.
- Questo mostra le caratteristiche che fanno parte del vocabolario quando viene adattato utilizzando i dati nella riga 4.
Nell'approccio semantico latente, la riga rappresenta le parole uniche, mentre la colonna rappresenta il numero di volte in cui quella parola compare nel documento. Si tratta di una rappresentazione delle parole sotto forma di matrice documento-documento. Il metodo TF-IDF (Term Frequency-Inverse Document Frequency) viene utilizzato per contare la frequenza delle parole nel documento, ovvero la frequenza del termine nel documento divisa per la frequenza del termine nell'intero corpus.
Difetto del metodo Bag of Words
- Ignora l'ordine delle parole; ad esempio, questo non va bene = è grave questo.
- Ignora il contesto delle parole. Supponiamo di scrivere la frase "Amava i libri. L'istruzione si trova al meglio nei libri". Creerebbe due vettori: uno per "Amava i libri" e un altro per "L'istruzione si trova al meglio nei libri". Li tratterebbe entrambi come ortogonali, rendendoli indipendenti, ma in realtà sono correlati tra loro.
Per superare queste limitazioni, è stata sviluppata la tecnica di word embedding, e Word2vec è uno degli approcci utilizzati per implementarla.
Come funziona Word2vec?
Word2vec impara una parola prevedendo il contesto circostante. Ad esempio, prendiamo la parola "He ama Calcio."
Vogliamo calcolare il Word2vec per la parola: ama.
Supponiamo:
loves = Vin. P(Vout / Vin) is calculated
where,
Vin is the input word.
P is the probability of likelihood.
Vout is the output word.
La parola ama Il programma analizza ogni parola del corpus. Vengono codificate sia le relazioni sintattiche che quelle semantiche tra le parole. Questo aiuta a trovare parole simili e analoghe.
Tutte le caratteristiche casuali della parola ama vengono calcolate. Queste caratteristiche vengono modificate o aggiornate rispetto alle parole vicine o di contesto con l'aiuto di un Propagazione posteriore metodo.
Un altro modo di imparare è che se i contesti di due parole sono simili, o se due parole hanno caratteristiche simili, allora tali parole sono correlate.
Parola2vec Architectura
Word2vec utilizza due architetture:
- Borsa continua di parole (CBOW)
- Salta-gramma
Prima di procedere oltre, analizziamo perché queste architetture o modelli sono importanti dal punto di vista della rappresentazione delle parole. L'apprendimento della rappresentazione delle parole è essenzialmente non supervisionato, ma sono necessari target/etichette per addestrare il modello. Skip-gram e CBOW convertono la rappresentazione non supervisionata in una forma supervisionata per l'addestramento del modello.
In CBOW, la parola corrente viene prevista utilizzando la finestra delle finestre di contesto circostanti. Ad esempio, se wi-1, wi-2, wi + 1, wi + 2 vengono fornite parole o contesto, questo modello fornirà wi.
Skip-Gram esegue l'opposto di CBOW, il che implica che predice la sequenza o il contesto dato dalla parola. Puoi invertire l'esempio per capirlo. Se wi dato, questo predice il contesto, o wi-1, wi-2, wi + 1, wi + 2.
Word2vec offre la possibilità di scegliere tra CBOW (Continuous Bag of Words) e skip-gram. Tali parametri vengono forniti durante l'addestramento del modello. È inoltre possibile utilizzare il campionamento negativo o un livello softmax gerarchico.
Sacco continuo di parole
Disegniamo un semplice diagramma di esempio di Word2vec per comprendere l'architettura continua del modello bag-of-words.

Calcoliamo matematicamente le equazioni. Supponiamo che V sia la dimensione del vocabolario e N sia la dimensione dello strato nascosto. L'input è definito come { xi-1, Xi-2, Xi + 1, Xi + 2 }. Otteniamo la matrice dei pesi moltiplicando V * N. Un'altra matrice si ottiene moltiplicando il vettore di input per la matrice dei pesi. Questo può essere compreso anche tramite la seguente equazione.
h = xitW
dove xit W e φ rappresentano rispettivamente il vettore di input e la matrice dei pesi.
Per calcolare la corrispondenza tra il contesto e la parola successiva, fare riferimento all'equazione riportata di seguito.
u = rappresentazione prevista * h
dove la rappresentazione prevista è ottenuta dal modello nell'equazione precedente.
Modello Skip-Gram
L'approccio Skip-Gram viene utilizzato per prevedere una frase a partire da una parola di input. Per comprenderlo meglio, osserviamo il diagramma mostrato nell'esempio Word2vec qui sotto.

Si può considerare questo modello come l'inverso del modello Continuous Bag of Words, dove l'input è la parola e il modello fornisce il contesto o la sequenza. Possiamo anche concludere che l'obiettivo viene fornito in input e il livello di output viene replicato più volte per adattarsi al numero di parole di contesto scelto. Il vettore di errore di tutti i livelli di output viene sommato per regolare i pesi tramite un metodo di retropropagazione.
Quale modello scegliere?
CBOW è diverse volte più veloce di skip-gram e fornisce una frequenza migliore per le parole frequenti, mentre skip-gram richiede una piccola quantità di dati di addestramento e rappresenta anche parole o frasi rare. La tabella seguente confronta le due architetture a colpo d'occhio.
| Aspetto | CBOW | Salta Gram |
|---|---|---|
| Predizione | Prevede la parola target dal contesto | Prevede il contesto a partire dalla parola target |
| Velocità di allenamento | Faster | Più lentamente |
| Parole frequenti | Maggiore precisione | Precisione inferiore |
| Parole rare | Rappresentanza più debole | Una rappresentanza più forte |
| Dati di allenamento | Servono più dati | Funziona con meno dati |
La relazione tra Word2vec e NLTK
NLTK è il Naturale Language ToolKit. Viene utilizzato per la preelaborazione del testo. È possibile eseguire diverse operazioni come l'etichettatura delle parti del discorso, la lemmatizzazione, lo stemming, la rimozione delle stop-word e la rimozione delle parole rare o meno utilizzate. Aiuta a pulire il testo e a preparare le caratteristiche dalle parole efficaci. D'altra parte, Word2vec viene utilizzato per la corrispondenza semantica (elementi strettamente correlati) e sintattica (sequenza). Utilizzando Word2vec è possibile trovare parole simili, parole dissimili, ridurre la dimensionalità e molto altro. Un'altra importante caratteristica di Word2vec è la conversione della rappresentazione ad alta dimensionalità del testo in vettori a dimensionalità inferiore.
Dove usare NLTK e Word2vec?
Se si devono svolgere attività di carattere generale come quelle menzionate in precedenza, ad esempio la tokenizzazione, l'etichettatura POS e il parsing, è necessario utilizzare NLTK, mentre per la previsione di parole in base al contesto, la modellazione di argomenti o la similarità tra documenti, è opportuno utilizzare Word2vec.
Relazione tra NLTK e Word2vec con l'aiuto del codice
NLTK e Word2vec possono essere utilizzati insieme per trovare rappresentazioni di parole simili o corrispondenze sintattiche. Il toolkit NLTK può essere utilizzato per caricare molti pacchetti inclusi in NLTK, e un modello può essere creato utilizzando Word2vec. Può quindi essere testato su parole reali. Vediamo la combinazione di entrambi nel codice seguente. Prima di procedere ulteriormente, si prega di dare un'occhiata ai corpus forniti da NLTK. È possibile scaricarli utilizzando il comando:
nltk(nltk.download('all'))

Si prega di vedere lo screenshot per il codice.
import nltk
import gensim
from nltk.corpus import abc

model = gensim.models.Word2Vec(abc.sents())
X = list(model.wv.vocab)
data = model.most_similar('science')
print(data)

Produzione:
[('law', 0.9415997266769409), ('practice', 0.9276568293571472), ('discussion', 0.9259148836135864), ('agriculture', 0.9257254004478455), ('media', 0.9232194423675537), ('policy', 0.922248125076294), ('general', 0.9166069030761719), ('undertaking', 0.916458249092102), ('tight', 0.9129181504249573), ('board', 0.9107444286346436)]
Spiegazione di Code
- La libreria nltk è stata importata e da lì è possibile scaricare il corpus abc che utilizzeremo nel passaggio successivo.
- Gensim è stato importato. Se Gensim Word2vec non è installato, installarlo utilizzando il comando "pip3 install gensim". Si prega di consultare lo screenshot qui sotto.

- Importa il corpus abc, che è stato scaricato utilizzando nltk.download('abc').
- Passa i file al modello Word2vec, che viene importato tramite Gensim, sotto forma di frasi.
- Il vocabolario viene memorizzato sotto forma di variabile.
- Il modello viene testato sulla parola campione scienza, poiché questi file sono relativi alla scienza.
- Qui, il modello prevede la presenza della parola "scienza", che è simile.
Attivatori e Word2Vec
La funzione di attivazione di un neurone definisce l'output di quel neurone in base a una serie di input. Essa si ispira biologicamente all'attività cerebrale, dove diversi neuroni vengono attivati da stimoli differenti. Analizziamo la funzione di attivazione attraverso il seguente diagramma.

Qui x1, x2, … x4 sono i nodi della rete neurale.
w1, w2, w3 sono i pesi dei nodi.
La somma (Σ) di tutti i pesi e i valori dei nodi funge da funzione di attivazione.
Perché la funzione di attivazione?
Se non viene utilizzata alcuna funzione di attivazione, l'output sarebbe lineare, ma la funzionalità di una funzione lineare è limitata. Per ottenere funzionalità complesse come il rilevamento di oggetti, la classificazione di immagini,ping Per la generazione di testo tramite voce e per molti altri output non lineari, è necessaria una funzione di attivazione.
Come viene calcolato il livello di attivazione nella parola incorporamento (Word2vec)
Il livello Softmax (funzione esponenziale normalizzata) è la funzione del livello di output che attiva o spara ogni nodo. Un altro approccio utilizzato è il softmax gerarchico, dove la complessità è calcolata da O(log2V), mentre nel softmax è O(V), dove V è la dimensione del vocabolario. La differenza tra i due è la riduzione della complessità nello strato softmax gerarchico. Per comprenderne il funzionamento, si prega di osservare l'esempio di word embedding riportato di seguito:

Supponiamo di voler calcolare la probabilità di osservare la parola amore dato un certo contesto. Il flusso dalla radice al nodo foglia si sposterà prima al nodo 2 e poi al nodo 5. Quindi, se abbiamo una dimensione del vocabolario di 8, sono necessari solo tre calcoli. Ciò consente di scomporre il calcolo della probabilità di una parola (amore).
Quali altre opzioni sono disponibili oltre a Hierarchical Softmax?
In generale, le opzioni di word embedding disponibili sono: Softmax differenziato, CNN-Softmax, campionamento per importanza, campionamento adattivo per importanza, stima contrastiva del rumore, campionamento negativo, autonormalizzazione e normalizzazione infrequente.
Parlando nello specifico di Word2vec, disponiamo del campionamento negativo.
Il campionamento negativo è un metodo per campionare i dati di addestramento. È in qualche modo simile alla discesa del gradiente stocastico, ma con alcune differenze. Il campionamento negativo cerca solo esempi di addestramento negativi. Si basa sulla stima contrastiva del rumore e campiona casualmente le parole che non sono presenti nel contesto. È un metodo di addestramento veloce e sceglie il contesto in modo casuale. Se la parola prevista appare nel contesto scelto casualmente, i due vettori sono vicini tra loro.
Quale conclusione si può trarre?
Gli attivatori attivano i neuroni proprio come i nostri neuroni vengono attivati da stimoli esterni. Il livello Softmax è una delle funzioni del livello di output che attiva i neuroni nel caso degli embedding di parole. In Word2vec, abbiamo opzioni come il softmax gerarchico e il campionamento negativo. Utilizzando gli attivatori, è possibile convertire una funzione lineare in una funzione non lineare e implementare un algoritmo di apprendimento automatico complesso utilizzando tali funzioni.
Cos'è Gensim?
Gensim è un toolkit open source per la modellazione di argomenti e l'elaborazione del linguaggio naturale implementato in Python e Cython. Il toolkit Gensim consente agli utenti di importare Word2vec per la modellazione degli argomenti al fine di scoprire la struttura nascosta nel corpo del testo. Gensim fornisce non solo un'implementazione di Word2vec, ma anche di Doc2vec e FastText.
Questa sezione è incentrata su Word2vec, quindi ci atterremo all'argomento attuale.
Come implementare Word2vec utilizzando Gensim
Finora abbiamo discusso di cosa sia Word2vec, delle sue diverse architetture, del perché si stia passando da un modello "bag of words" a Word2vec, della relazione tra Word2vec e NLTK con codice eseguibile e delle funzioni di attivazione.
Di seguito è riportata la procedura dettagliata per implementare Word2vec utilizzando Gensim:
Passaggio 1) Raccolta dati
Il primo passo per implementare qualsiasi modello di apprendimento automatico o per implementare l'elaborazione del linguaggio naturale è la raccolta dei dati.
Si prega di osservare i dati per creare un chatbot intelligente come mostrato nell'esempio Gensim Word2vec riportato di seguito.
[{"tag": "welcome",
"patterns": ["Hi", "How are you", "Is any one to talk?", "Hello", "hi are you available"],
"responses": ["Hello, thanks for contacting us", "Good to see you here", "Hi there, how may I assist you?"]
        },
{"tag": "goodbye",
"patterns": ["Bye", "See you later", "Goodbye", "I will come back soon"],
"responses": ["See you later, thanks for visiting", "have a great day ahead", "Wish you Come back again soon."]
        },
{"tag": "thankful",
"patterns": ["Thanks for helping me", "Thank your guidance", "That's helpful and kind from you"],
"responses": ["Happy to help!", "Any time!", "My pleasure", "It is my duty to help you"]
        },
        {"tag": "hoursopening",
"patterns": ["What hours are you open?", "Tell your opening time?", "When are you open?", "Just your timing please"],
"responses": ["We're open every day 8am-7pm", "Our office hours are 8am-7pm every day", "We open office at 8 am and close at 7 pm"]
        },
{"tag": "payments",
"patterns": ["Can I pay using credit card?", "Can I pay using Mastercard?", "Can I pay using cash only?"],
"responses": ["We accept VISA, Mastercard and credit card", "We accept credit card, debit cards and cash. Please don't worry"]
        }
   ]
Ecco cosa abbiamo capito dai dati:
- Questi dati contengono tre elementi: tag, modello e risposte. Il tag rappresenta l'intento (qual è l'argomento della discussione).
- I dati sono in formato JSON.
- Un modello è una domanda che gli utenti porranno al bot.
- Le risposte sono le risposte che il chatbot fornirà alla domanda/schema corrispondente.
Passaggio 2) Preelaborazione dei dati
È molto importante elaborare i dati grezzi. Se i dati puliti vengono forniti alla macchina, il modello risponderà in modo più accurato e apprenderà i dati in modo più efficiente.
Questo passaggio prevede la rimozione delle stop word, la riduzione alla radice, l'eliminazione delle parole superflue, ecc. Prima di procedere, è importante caricare i dati e convertirli in un data frame. Si prega di consultare il codice seguente per questo scopo.
import json
json_file = 'intents.json'
with open('intents.json', 'r') as f:
    data = json.load(f)
Spiegazione di Code:
- Poiché i dati sono in formato JSON, il file JSON viene importato.
- Il file viene memorizzato nella variabile.
- Il file viene aperto e caricato nella variabile dati.
Ora che i dati sono stati importati, è il momento di convertirli in un dataframe. Per il passaggio successivo, consultare il codice riportato di seguito.
import pandas as pd
df = pd.DataFrame(data)
df['patterns'] = df['patterns'].apply(', '.join)
Spiegazione di Code:
1. I dati vengono convertiti in un data frame utilizzando pandas, che è stato importato in precedenza.
2. Converte l'elenco presente nei modelli di colonna in una stringa.
from nltk.corpus import stopwords
from textblob import Word
stop = stopwords.words('english')
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x.lower() for x in x.split()))
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if x not in string.punctuation))
df['patterns'] = df['patterns'].str.replace('[^\w\s]', '')
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if not x.isdigit()))
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if x not in stop))
df['patterns'] = df['patterns'].apply(lambda x: " ".join([Word(word).lemmatize() for word in x.split()]))
Code Spiegazione:
1. Le parole non significative (stop words) inglesi vengono importate utilizzando il modulo stop-word del toolkit NLTK.
2. Tutte le parole del testo vengono convertite in minuscolo utilizzando una condizione for e una funzione lambda. A Funzione Lambda è una funzione anonima.
3. Tutte le righe di testo nel data frame vengono controllate per la presenza di punteggiatura e, se presenti, vengono filtrate.
4. Caratteri come numeri o punti vengono rimossi utilizzando un'espressione regolare.
5. Digivengono rimossi dal testo.
6. Le parole d'arresto vengono rimosse in questa fase.
7. Le parole vengono ora filtrate e le diverse forme della stessa parola vengono rimosse tramite lemmatizzazione. Con questi passaggi, abbiamo completato la preelaborazione dei dati.
Produzione:
, patterns, responses, tag
0,hi one talk hello hi available,"['Hello, thanks for contacting us', 'Good to see you here', ' Hi there, how may I assist you?']",welcome
1,bye see later goodbye come back soon,"['See you later, thanks for visiting', 'have a great day ahead', 'Wish you Come back again soon.']",goodbye
2,thanks helping thank guidance thats helpful kind,"['Happy to help!', 'Any time!', 'My pleasure', 'It is my duty to help you']",thankful
3,hour open tell opening time open timing please,"[""We're open every day 8am-7pm"", 'Our office hours are 8am-7pm every day', 'We open office at 8 am and close at 7 pm']",hoursopening
4,pay using credit card pay using mastercard pay using cash,"['We accept VISA, Mastercard and credit card', 'We accept credit card, debit cards and cash. Please dont worry']",payments
Passaggio 3) Creazione di una rete neurale utilizzando Word2vec
Ora è il momento di costruire un modello utilizzando il modulo Word2vec di Gensim. Dobbiamo importare Word2vec da Gensim. Facciamolo, poi lo compileremo e, nella fase finale, verificheremo il modello su dati in tempo reale.
from gensim.models import Word2Vec
Ora possiamo creare con successo il modello utilizzando Word2Vec. Fare riferimento alla riga di codice successiva per imparare come creare il modello con Word2Vec. Il testo viene fornito al modello sotto forma di elenco, quindi convertiremo il testo dal dataframe in un elenco utilizzando il codice seguente.
Bigger_list = []
for i in df['patterns']:
     li = list(i.split(""))
     Bigger_list.append(li)
Model = Word2Vec(Bigger_list, min_count=1, size=300, workers=4)
Spiegazione di Code:
1. È stata creata la lista più grande (bigroom_list) a cui è stata aggiunta la lista interna. Questo è il formato che viene fornito al modello Word2Vec.
2. Viene implementato un ciclo e ogni elemento della colonna "patterns" del data frame viene iterato.
3. Ogni elemento dei modelli di colonna viene suddiviso e memorizzato nell'elenco interno li.
4. All'elenco interno viene aggiunto l'elenco esterno.
5. Questo elenco viene fornito al modello Word2Vec. Analizziamo alcuni dei parametri qui indicati.
Conteggio_min: Ignora tutte le parole con una frequenza totale inferiore a questa.
Dimensioni: Indica la dimensionalità dei vettori di parole.
Lavoratori: Questi sono i thread per addestrare il modello.
Sono disponibili anche altre opzioni, alcune delle quali importanti sono illustrate di seguito.
finestra: Distanza massima tra la parola corrente e quella prevista all'interno di una frase.
Sig.: Si tratta di un algoritmo di addestramento: 1 per skip-gram e 0 per Continuous Bag of Words. Li abbiamo discussi in dettaglio in precedenza.
Ora: Se il valore è 1, si utilizza l'algoritmo softmax gerarchico per l'addestramento; se è 0, si utilizza il campionamento negativo.
Alfa: Tasso di apprendimento iniziale.
Mostriamo il codice finale di seguito:
# list of libraries used by the code
import string
from gensim.models import Word2Vec
import logging
from nltk.corpus import stopwords
from textblob import Word
import json
import pandas as pd
# data in json format
json_file = 'intents.json'
with open('intents.json', 'r') as f:
    data = json.load(f)
# displaying the list of stopwords
stop = stopwords.words('english')
# dataframe
df = pd.DataFrame(data)

df['patterns'] = df['patterns'].apply(', '.join)
# cleaning the data using the NLP approach
print(df)
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x.lower() for x in x.split()))
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if x not in string.punctuation))
df['patterns'] = df['patterns'].str.replace('[^\w\s]', '')
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if not x.isdigit()))
df['patterns'] = df['patterns'].apply(lambda x: ' '.join(x for x in x.split() if x not in stop))
df['patterns'] = df['patterns'].apply(lambda x: " ".join([Word(word).lemmatize() for word in x.split()]))
# taking the outer list
bigger_list = []
for i in df['patterns']:
    li = list(i.split(" "))
    bigger_list.append(li)
# structure of data to be taken by the model.word2vec
print("Data format for the overall list:", bigger_list)
# custom data is fed to machine for further processing
model = Word2Vec(bigger_list, min_count=1, size=300, workers=4)
Passaggio 4) Salvataggio del modello
Il modello può essere salvato in formato binario (bin) e in formato modello (model). Bin è il formato binario. Consultare le righe seguenti per salvare il modello.
model.save("word2vec.model")
model.save("model.bin")
Spiegazione del codice sopra
1. Il modello viene salvato sotto forma di file .model.
2. Il modello viene salvato sotto forma di file .bin.
Utilizzeremo questo modello per effettuare test in tempo reale, ad esempio per identificare parole simili, parole dissimili e parole più comuni.
Passaggio 5) Caricamento del modello ed esecuzione dei test in tempo reale
Il modello viene caricato utilizzando il codice seguente:
model = Word2Vec.load('model.bin')
Se si desidera stampare il vocabolario, si utilizza il comando seguente:
vocab = list(model.wv.vocab)
Si prega di vedere il risultato:
['see', 'thank', 'back', 'thanks', 'soon', 'open', 'mastercard', 'card', 'time', 'pay', 'talk', 'cash', 'one', 'please', 'goodbye', 'thats', 'helpful', 'hour', 'credit', 'hi', 'later', 'guidance', 'opening', 'timing', 'hello', 'helping', 'bye', 'tell', 'come', 'using', 'kind', 'available']
Passaggio 6) Controllo delle parole più simili
Implementiamo le cose praticamente:
similar_words = model.most_similar('thanks')
print(similar_words)
Si prega di vedere il risultato:
[('kind', 0.16104359924793243), ('using', 0.1352398842573166), ('come', 0.11500970274209976), ('later', 0.09989878535270691), ('helping', 0.04855936020612717), ('credit', 0.04659383371472359), ('pay', 0.0329081267118454), ('thank', 0.02484947443008423), ('hour', 0.0202352125197649), ('opening', 0.018177658319473267)]
Passaggio 7) Non corrisponde alla parola tra le parole fornite
dissimlar_words = model.doesnt_match('See you later, thanks for visiting'.split())
print(dissimlar_words)
Abbiamo fornito le parole 'Arrivederci, grazie per la visita'Questo codice stampa la parola più dissimile tra queste. Eseguiamo il codice e vediamo il risultato.
Il risultato dopo l'esecuzione del codice sopra:
Thanks
Passaggio 8) Trovare la somiglianza tra due parole
Questo indica il risultato in termini di probabilità di somiglianza tra due parole. Si prega di consultare il codice seguente per informazioni su come eseguire questa sezione.
similarity_two_words = model.similarity('please', 'see')
print("Please provide the similarity between these two words:")
print(similarity_two_words)
Il risultato del codice sopra riportato è il seguente:
0.13706
È possibile trovare ulteriori parole simili eseguendo il codice seguente:
similar = model.similar_by_word('kind')
print(similar)
Output del codice sopra riportato:
[('credit', 0.11764447391033173), ('cash', 0.11440904438495636), ('one', 0.11151769757270813), ('hour', 0.0944807156920433), ('using', 0.0705675333738327), ('thats', 0.05206916481256485), ('later', 0.04502468928694725), ('bye', 0.03960943967103958), ('back', 0.03837274760007858), ('thank', 0.0380823090672493)]
