
Apprendimento automatico non supervisionato: AlgorithmsTipi ed esempi
 Evelyn Clarke
⚡ Riepilogo intelligente
L'apprendimento non supervisionato è una tecnica di apprendimento automatico che opera su dati non etichettati, consentendo al modello di scoprire autonomamente la struttura attraverso il clustering, le regole di associazione e la riduzione della dimensionalità, anziché a partire da risposte fornite in anticipo.
Cos'è l'apprendimento non supervisionato?
L'apprendimento non supervisionato è una tecnica di apprendimento automatico in cui l'utente non ha bisogno di supervisionare il modello. Al contrario, permette al modello di lavorare autonomamente per scoprire schemi e informazioni precedentemente non rilevati. Si occupa principalmente di dati non etichettati.
Apprendimento senza supervisione Algorithms
Apprendimento senza supervisione Algorithms consentire agli utenti di eseguire attività di elaborazione più complesse rispetto a apprendimento supervisionatoL'apprendimento non supervisionato può tuttavia risultare più imprevedibile rispetto ai metodi addestrati su risposte note. Gli algoritmi di apprendimento non supervisionato includono il clustering, il rilevamento delle anomalie, la riduzione della dimensionalità e le reti neurali auto-organizzanti.
Esempio di machine learning non supervisionato
Prendiamo come esempio l'apprendimento non supervisionato di una bambina e del suo cane di famiglia. La prima immagine mostra l'animale domestico che la bambina già riconosce.
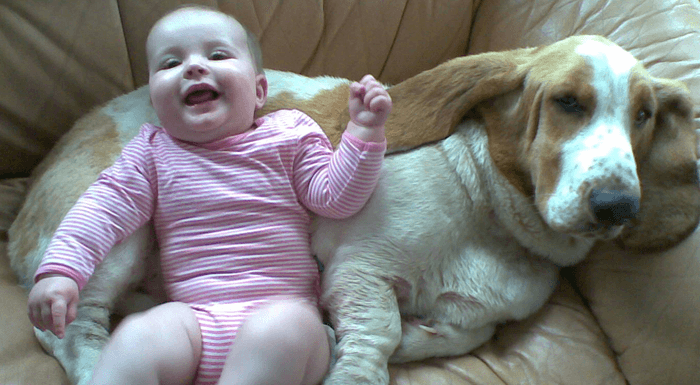
Lei conosce e identifica questo cane. Qualche settimana dopo, un amico di famiglia porta con sé un cane e cerca di giocare con la bambina. Quel secondo cane, sconosciuto, è raffigurato qui sotto.
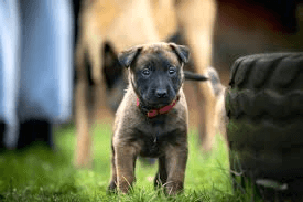
La bambina non aveva mai visto prima questo cane. Tuttavia, riconosce che molte caratteristiche (due orecchie, occhi, camminare su quattro zampe) sono simili a quelle del suo cane domestico. Identifica quindi il nuovo animale come un cane. Questo è un esempio di apprendimento non supervisionato, in cui non si viene istruiti, ma si apprende dai dati (in questo caso dati relativi a un cane). Se si fosse trattato di apprendimento supervisionato, l'amico di famiglia avrebbe detto alla bambina che si trattava di un cane, come mostrato nell'esempio di apprendimento non supervisionato precedente.
Perché l’apprendimento non supervisionato?
Ecco i motivi principali per utilizzare l'apprendimento non supervisionato in machine Learning:
- L'apprendimento automatico non supervisionato individua ogni sorta di schema sconosciuto nei dati.
- I metodi non supervisionati ti aiutano a trovare funzionalità che possono essere utili per la categorizzazione.
- Può elaborare i dati man mano che arrivano, quindi i record in entrata vengono analizzati e raggruppati senza dover attendere che un essere umano li etichetti prima.
- È più semplice ottenere dati senza etichetta da un computer rispetto a dati etichettati, che richiedono un intervento manuale.
ClusterTipi di apprendimento non supervisionato Algorithms
I problemi di apprendimento non supervisionato vengono ulteriormente suddivisi in problemi di clustering, associazione e riduzione della dimensionalità. ClusterL'analisi raggruppa record simili, l'analisi delle associazioni individua elementi che appaiono insieme e la riduzione della dimensionalità comprime molte caratteristiche in poche.
ClusterING
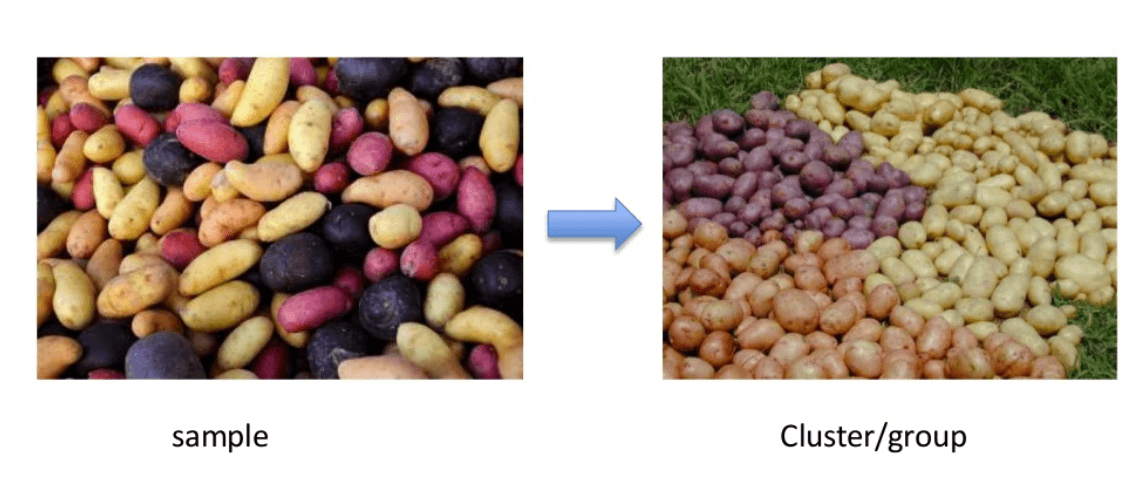
ClusterL'apprendimento è un concetto importante quando si parla di apprendimento non supervisionato. Si occupa principalmente di trovare una struttura o un modello in una raccolta di dati non categorizzati. Apprendimento non supervisionato ClusterGli algoritmi elaboreranno i tuoi dati e individueranno i cluster (gruppi) naturali, se presenti. Puoi anche modificare il numero di cluster che gli algoritmi devono identificare. Ciò ti consente di regolare la granularità di questi gruppi. Il diagramma seguente mostra i record sparsi suddivisi in gruppi distinti.
Esistono diversi tipi di clustering che puoi utilizzare:
Esclusivo (partizionamento)
In questo metodo di clustering, i dati vengono raggruppati in modo tale che ogni record possa appartenere a un solo cluster.
Esempio: K-significa
agglomerante
In questa tecnica di clustering, ogni record inizia come un cluster a sé stante. Le unioni iterative tra i due cluster più vicini riducono il numero di cluster.
Esempio: Clustering gerarchico
sovrapposizioneping
In questa tecnica, set sfocati vengono utilizzati per raggruppare i dati. Ogni punto può appartenere a due o più cluster con gradi di appartenenza differenti.
Qui, i dati verranno associati a un valore di iscrizione appropriato. Esempio: medie C fuzzy
probabilistico
Questa tecnica utilizza una distribuzione di probabilità per creare i cluster.
Esempio: Le seguenti parole chiave
- “scarpa da uomo”.
- “scarpa da donna”.
- "guanto da donna."
- "guanto da uomo."
possono essere raggruppati in due categorie, "scarpa" e "guanto", oppure "uomo" e "donna".
Clustertipi
Di seguito sono elencati gli algoritmi più frequentemente utilizzati nell'apprendimento automatico non supervisionato. I primi due raggruppano i record, gli ultimi tre riducono le dimensioni anziché formare cluster, e K-NN è incluso perché viene spesso confuso con K-means.
- Clustering gerarchico — clustering
- Clustering K-means — clustering
- K-NN (k vicini più prossimi) — un classificatore supervisionato, non un metodo di clustering
- Analisi delle componenti principali - riduzione della dimensionalità
- Decomposizione ai valori singolari - riduzione della dimensionalità
- Analisi delle componenti indipendenti - riduzione della dimensionalità
Hierarchical ClusterING
Il clustering gerarchico è un algoritmo che costruisce una gerarchia di cluster. Inizia assegnando tutti i dati a un cluster specifico. In questo caso, due cluster vicini vengono uniti in un unico cluster. L'algoritmo termina quando rimane un solo cluster. Definisce due concetti che meritano di essere approfonditi separatamente.
Raggruppamento agglomerativo
Questa forma di clustering gerarchico dal basso verso l'alto non richiede il numero di cluster K come input. Il processo di agglomerazione inizia formando ogni record come un singolo cluster.
Questo metodo utilizza una misura di distanza e riduce il numero di cluster (uno per ogni iterazione) tramite un processo di fusione. Infine, si ottiene un unico grande cluster contenente tutti gli oggetti, e l'analista taglia l'albero all'altezza che fornisce un numero ragionevole di gruppi.
Dendrogramma
Nel metodo di clustering a dendrogramma, ogni livello rappresenta un possibile cluster. L'altezza del dendrogramma indica il grado di somiglianza tra due cluster uniti. Più i cluster sono vicini alla base del processo, più sono simili; la scelta del punto di taglio che definisce i gruppi finali non è automatica ed è per lo più soggettiva.
K-significa ClusterING
K-means è un algoritmo di clustering iterativo che affina il gruppoping ad ogni iterazione. Inizialmente, viene selezionato il numero desiderato di cluster. In questo metodo di clustering, è necessario raggruppare i punti dati in k gruppi. Un valore di k maggiore significa gruppi più piccoli con maggiore granularità; un valore di k minore significa gruppi più grandi con minore granularità.
L'output dell'algoritmo è un gruppo di "etichette". Assegna ogni punto dati a uno dei k gruppi. Nel clustering k-means, ogni gruppo è definito creando un centroide per quel gruppo. I centroidi sono come il cuore del cluster, che cattura i punti più vicini a loro e li aggiunge al cluster.
K- Vicini più prossimi
L'algoritmo dei k-vicini più prossimi (K-NN) è il più semplice tra tutti i classificatori di apprendimento automatico. Si differenzia dalle altre tecniche di apprendimento automatico perché non produce un modello. Si tratta di un semplice algoritmo che memorizza tutti i casi disponibili e classifica le nuove istanze in base a una misura di similarità. Poiché necessita di casi etichettati da classificare, il K-NN è un metodo supervisionato; compare qui solo perché la sua logica basata sulla distanza ricorda il clustering.
Funziona molto bene quando esiste una distanza significativa tra gli esempi. La velocità di apprendimento è lenta quando il set di addestramento è grande e il calcolo della distanza non è banale.
Analisi delle componenti principali
L'analisi delle componenti principali prende uno spazio ad alta dimensionalità e seleziona una nuova base, mantenendoping solo i punteggi più importanti. Ogni direzione in questa base è nota come componente principale. Il sottoinsieme che si conserva costituisce un nuovo spazio di dimensioni ridotte rispetto allo spazio originale. In questo modo si mantiene quanta più complessità possibile dei dati.
Associazione
Le regole di associazione consentono di stabilire associazioni tra oggetti dati all'interno di grandi database. Questa tecnica non supervisionata riguarda la scoperta di relazioni interessanti tra variabili in grandi database ed è un elemento fondamentale di data miningAd esempio, chi acquista una casa nuova tende ad acquistare anche mobili nuovi.
Altri esempi:
- Un sottogruppo di pazienti oncologici raggruppati in base alle misurazioni dell'espressione genica.
- Gruppi di acquirenti in base alla cronologia di navigazione e di acquisto
- Film raggruppati in base alle valutazioni assegnate dagli spettatori
Apprendimento automatico supervisionato e non supervisionato
Ecco la differenza principale tra Apprendimento supervisionato e non supervisionato:
| Scheda Sintetica | Tecnica di machine learning supervisionata | Tecnica di machine learning non supervisionata |
| Dati in ingresso | Algorithms vengono addestrati utilizzando dati etichettati. | Algorithms vengono utilizzati rispetto a dati non etichettati |
| Complessità computazionale | L’apprendimento supervisionato è un metodo più semplice. | L'apprendimento non supervisionato è computazionalmente complesso |
| Precisione | L'accuratezza può essere misurata direttamente confrontandola con etichette note. | L'accuratezza non può essere misurata direttamente; i risultati necessitano di interpretazione. |
| Uscita tipica | Una previsione per ogni nuovo record | Gruppi, regole o funzionalità compresse |
Applicazioni dell'apprendimento automatico non supervisionato
Alcune applicazioni delle tecniche di apprendimento non supervisionato sono:
- Clustering suddivide automaticamente il set di dati in gruppi in base alle loro somiglianze
- Il rilevamento delle anomalie può scoprire punti dati insoliti nel set di dati. È utile per trovare transazioni fraudolente
- L'estrazione associativa identifica insiemi di elementi che spesso si presentano insieme nel set di dati
- I modelli a variabili latenti sono ampiamente utilizzati per la preelaborazione dei dati, ad esempio per ridurre il numero di caratteristiche in un dataset o per scomporre il dataset in più componenti.
Svantaggi dell'apprendimento non supervisionato
- Non è possibile ottenere informazioni precise sull'ordinamento dei dati, perché i dati utilizzati nell'apprendimento non supervisionato non sono etichettati e il loro vero gruppoping non è conosciuto
- Less L'accuratezza dei risultati è compromessa perché i dati di input non sono noti né etichettati in anticipo da persone. Ciò significa che è la macchina a dover fare tutto questo autonomamente.
- Le classi spettrali non sempre corrispondono alle classi informative.
- L'utente deve dedicare del tempo all'interpretazione e all'etichettatura delle classi che derivano dalla classificazione.
- Le proprietà spettrali delle classi possono cambiare nel tempo, quindi non è possibile mantenere le stesse informazioni sulla classe passando da un'immagine all'altra.
