
Identificazione intelligente in QTP/UFT con l'esempio
 Tommaso Hamilton
⚡ Riepilogo intelligente
L'identificazione intelligente è un meccanismo di ripiego in UFT Un metodo per individuare un oggetto quando la sua descrizione appresa non corrisponde più all'applicazione in fase di test, utilizzando proprietà di filtro di base e opzionali per restringere l'elenco dei candidati a una sola corrispondenza.
Che cos'è l'identificazione intelligente in QTP/UFT?
Smart Identification è un meccanismo di fallback per il riconoscimento degli oggetti in OpenText UFT Uno, lo strumento precedentemente noto come HP QuickTest Professional (QTP). Se il normale processo di identificazione non riesce a trovare una corrispondenza univoca per la descrizione appresa di un oggetto, UFT Attiva l'identificazione intelligente, a condizione che il meccanismo sia abilitato nelle impostazioni di identificazione degli oggetti per la classe di quell'oggetto.
A differenza della descrizione appresa, l'identificazione intelligente non richiede una corrispondenza esatta per ogni proprietà memorizzata. Valuta due categorie di proprietà per restringere il gruppo di oggetti candidati a uno solo:
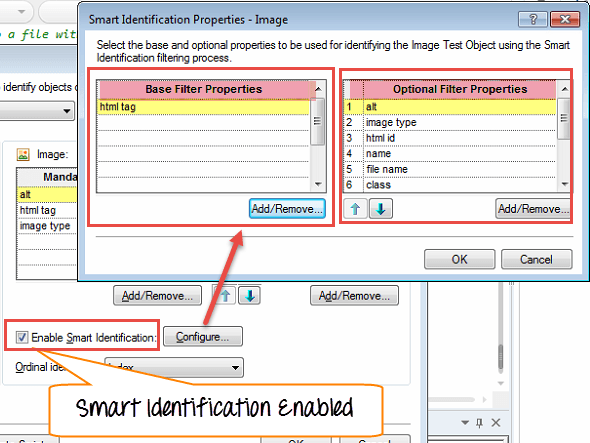
- Proprietà del filtro di base. Le proprietà fondamentali di una classe di oggetti di test; quelle i cui valori non possono cambiare senza alterare l'essenza dell'oggetto originale.
- Proprietà del filtro opzionali. Proprietà di supporto che aiutano a identificare un oggetto ma che hanno maggiori probabilità di cambiare nel tempo.
Quando Smart Identification è in esecuzione, UFT "Dimentica" la descrizione appresa e ricostruisce un nuovo elenco di candidati contenente ogni oggetto che corrisponde a tutte le proprietà del filtro di base. Quindi restringe ulteriormente tale elenco, controllando una alla volta le proprietà del filtro opzionale, finché non rimane un solo oggetto.
Se l'identificazione intelligente viene attivata durante una sessione di esecuzione, l'albero dei risultati del test registra un messaggio di avviso che conferma l'utilizzo del meccanismo e viene inserito un passaggio di identificazione intelligente nei risultati in modo che la deviazione dalla descrizione appresa rimanga visibile.
L'identificazione intelligente si posiziona al terzo posto UFTLa gerarchia di identificazione degli oggetti si trova dopo la descrizione appresa e qualsiasi identificatore di relazione visiva, e prima dell'identificatore ordinale utilizzato come ultima risorsa. Capire dove si colloca spiega perché disabilitarlo completamente, piuttosto che correggere le proprietà sottostanti, raramente rappresenta la scelta migliore a lungo termine per uno script che viene eseguito frequentemente.
Proprietà del filtro di base rispetto alle proprietà del filtro opzionale
Entrambi i filtri lavorano insieme, ma svolgono ruoli diversi nel processo di eliminazione descritto in precedenza. Il confronto seguente chiarisce quando viene utilizzato ciascuno e quanta capacità di eliminazione offre.
| Aspetto | Proprietà del filtro di base | Proprietà filtro facoltative |
|---|---|---|
| Ruolo | Creare l'elenco iniziale dei candidati | Restringere l'elenco dei candidati a un solo oggetto |
| Stabilità | Quasi mai si cambia senza cambiare l'identità dell'oggetto | Può cambiare periodicamente senza modificare l'identità dell'oggetto |
| Regola di corrispondenza | Ogni candidato deve corrispondere a tutte le proprietà di base | Si controlla una proprietà alla volta; una proprietà viene saltata se ciò escluderebbe tutti i candidati |
| Esempio tipico | Tag HTML, classe oggetto, indice | Nome, ID HTML, testo alternativo, fonte dell'immagine |
| Dove configurato | Identificazione oggetto > Configura > Proprietà filtro base | Identificazione oggetto > Configura > Proprietà filtro opzionali |
Poiché la stessa proprietà non può essere presente in entrambi gli elenchi, è necessario pianificare attentamente la suddivisione. Le proprietà che definiscono l'essenza di un oggetto appartengono all'elenco di base; le proprietà che servono semplicemente a distinguerlo da oggetti simili appartengono all'elenco facoltativo.
Come funziona l'identificazione intelligente: il processo passo dopo passo
L'identificazione intelligente si attiva solo dopo che la descrizione appresa e qualsiasi identificatore di relazione visiva non riescono a individuare un singolo oggetto. Una volta attivata, UFT funziona attraverso un processo di eliminazione prevedibile in quattro fasi:
- Ricostruire l'elenco dei candidati. UFT Ignora la descrizione appresa e analizza il genitore dell'oggetto alla ricerca di ogni oggetto che corrisponda a tutte le proprietà del filtro di base.
- Applica la prima proprietà facoltativa. UFT Rimuove tutti i candidati che non corrispondono alla prima proprietà nell'elenco Proprietà filtro opzionali.
- Valutare il risultato. Se rimane più di un candidato, UFT ripete il passaggio precedente con la proprietà opzionale successiva. Se un filtro eliminasse ogni candidato rimanente, UFT salta quella proprietà e passa alla successiva.
- Fermati a una partita. UFT Ripete il ciclo di filtraggio e valutazione finché non rimane esattamente un oggetto, oppure finché non esaurisce le proprietà opzionali da controllare.
Se il processo di eliminazione non riesce ancora a isolare un singolo oggetto, UFT Il sistema ricorre alla descrizione appresa più un identificatore ordinale, come indice, posizione o data di creazione. Se anche questa combinazione non riesce a identificare l'oggetto, la sessione di esecuzione si interrompe e visualizza un errore di runtime.
Come attivare o disattivare l'identificazione intelligente
L'identificazione intelligente è configurata per classe di oggetti di test da Strumenti > Identificazione degli oggetti. Seleziona l'ambiente e la classe oggetto, attiva Abilita l'identificazione intelligente, quindi fare clic Configurazione per scegliere le proprietà di filtro di base e opzionali per quella classe. La stessa finestra di dialogo consente di disattivare l'opzione per una classe che dovrebbe sempre utilizzare la sua descrizione appresa.
Come funziona l'identificazione intelligente (video esplicativo)
Il video qui sotto illustra il processo di eliminazione del filtro di base e del filtro opzionale con un esempio pratico.
Clicchi Qui. se il video non è accessibile
Vantaggi e svantaggi dell'utilizzo dell'identificazione intelligente
L'identificazione intelligente aumenta la resilienza, ma tale resilienza comporta un costo in termini di tempo di esecuzione. Valutate attentamente entrambi gli aspetti prima di lasciarla abilitata di default in un intero repository di oggetti.
- ✅ Resiste a piccole modifiche dell'interfaccia utente: Un attributo rinominato o una posizione spostata nella pagina non causano più l'interruzione di ogni script che interagisce con l'oggetto.
- ✅ Riduce la manutenzione del repository degli oggetti: Dopo le piccole release del front-end, i tester dedicano meno tempo alla registrazione degli oggetti.
- ✅ Rimane visibile nei risultati: Ogni invocazione registra un avviso, in modo che i team possano verificare con quale frequenza il fallback è effettivamente necessario.
- ⚠️ Esecuzione dei test più lenta: La creazione e la selezione di un elenco di candidati richiedono tempi sensibilmente più lunghi rispetto alla ricerca diretta di un immobile, e i costi si moltiplicano per un ampio numero di proprietà.
- ⚠️ Può mascherare difetti reali: Se Smart Identification rileva silenziosamente un oggetto simile, una vera e propria regressione dell'interfaccia utente potrebbe passare inosservata.
- ⚠️ Necessita di revisione periodica: Le proprietà di filtro di base e opzionali necessitano comunque di revisioni periodiche man mano che l'applicazione si evolve.
La maggior parte dei team lascia attiva l'Identificazione intelligente per gli script esplorativi e a bassa frequenza, per poi disattivarla selettivamente sugli oggetti critici per le prestazioni una volta che le proprietà di identificazione dell'oggetto si sono stabilizzate.
Modifica la proprietà dell'oggetto per evitare l'identificazione intelligente
La flessibilità di Smart Identification ha un costo in termini di tempo di esecuzione, come descritto in precedenza, quindi molti team preferiscono correggere direttamente le proprietà di identificazione degli oggetti piuttosto che affidarsi ripetutamente al meccanismo di fallback. Due segnali indicano che una correzione delle proprietà è preferibile a un fallback in fase di esecuzione: un avviso di Smart Identification che compare quasi a ogni esecuzione e uno script che risulta sensibilmente più lento da quando il fallback ha iniziato a essere attivato. Entrambi i casi indicano un oggetto le cui proprietà di identificazione predefinite non sono più adatte all'applicazione, piuttosto che un problema temporaneo dell'interfaccia utente. Il video seguente mostra la soluzione su un modulo di accesso reale.
Clicchi Qui. se il video non è accessibile
Trascrizione del video: punti chiave
- L'identificazione intelligente rallenta l'esecuzione degli script, il che non è auspicabile per suite di grandi dimensioni o eseguite frequentemente.
- Per evitarlo completamente, modifica le proprietà di identificazione dell'oggetto predefinite anziché affidarti al meccanismo di fallback.
- In Identificazione degli oggetti, rimuovere “name” dalle proprietà obbligatorie e sostituirlo con “HTML id” per rendere il test indipendente dalle modifiche del nome.
- Registra nuovamente gli stessi passaggi una volta aggiornato l'elenco delle proprietà obbligatorie.
- Se in seguito il nome cambia da "Invia" a "Accedi", lo script viene eseguito senza attivare l'identificazione intelligente.
- Analogamente, se una qualsiasi proprietà obbligatoria o di supporto di un oggetto in fase di test cambia frequentemente, sostituiscila con una proprietà più stabile per mantenere veloce l'esecuzione dello script.
- La messa a punto delle proprietà è un'abilità che si acquisisce con l'esperienza; migliora man mano che si utilizza lo strumento.
Disabilitare l'identificazione intelligente tramite VBScript
L'identificazione intelligente può anche essere disattivata per un'intera sessione di esecuzione senza toccare il repository degli oggetti, utilizzando il Disabilitare la riproduzione tramite algoritmo Impostazione di runtime. Questa opzione è utile quando uno script deve fallire immediatamente in caso di mancata corrispondenza delle proprietà, anziché ricorrere silenziosamente al processo di eliminazione.
' Disable Smart Identification for this run session
Setting("DisableReplayUsingAlgorithm") = 1

Browser("Mercury Tours").Page("Find Flights").WebEdit("userName").Set "mercury"

' Re-enable Smart Identification once the strict steps are done
Setting("DisableReplayUsingAlgorithm") = 0
Il periodo di disabilitazione deve essere il più breve possibile. I passaggi eseguiti al suo interno devono corrispondere esattamente alla descrizione appresa, in modo che qualsiasi deviazione legittima nell'applicazione in fase di test provochi un errore immediato anziché un ripristino graduale.
Risorse
Scarica le pagine web utilizzate nel tutorial precedente per esercitarti.
