
Tokenize NLTK: tokenizzatore di parole e frasi con esempio
 Evelyn Clarke
⚡ Riepilogo intelligente
NLTK Tokenize suddivide testi di grandi dimensioni in unità più piccole chiamate token, un passaggio fondamentale nell'elaborazione del linguaggio naturale. Il toolkit fornisce word_tokenize per scomporre le frasi in parole e sent_tokenize per suddividere il testo in singole frasi.
Cos'è la tokenizzazione?
tokenizzazione è il processo mediante il quale una grande quantità di testo viene divisa in parti più piccole chiamate token. Questi token sono molto utili per trovare modelli e sono considerati un passaggio base per la derivazione e la lemmatizzazione. La tokenizzazione aiuta anche a sostituire elementi di dati sensibili con elementi di dati non sensibili.
L'elaborazione del linguaggio naturale viene utilizzata per creare applicazioni come la classificazione del testo, chatbot intelligente, analisi sentimentale, traduzione linguistica, ecc. Diventa vitale comprendere lo schema del testo per raggiungere lo scopo sopra indicato.
Per il momento, non preoccuparti di stemming e lemmatizzazione, ma trattali come passaggi per la pulizia dei dati testuali tramite NLP (Natural language processing). Discuteremo di stemming e lemmatizzazione più avanti nel tutorial. Attività come Classificazione del testo o filtraggio dello spam fa uso della PNL insieme a librerie di deep learning come Keras e tensorflow.
Il toolkit del linguaggio naturale ha un modulo NLTK molto importante tokenize frasi che comprendono inoltre sottomoduli
- parola tokenizzare
- tokenizzare la frase
Tokenizzazione delle parole
Usiamo il metodo word_tokenize() per dividere una frase in parole. L'output della tokenizzazione delle parole può essere convertito in Data Frame per una migliore comprensione del testo nelle applicazioni di machine learning. Può anche essere fornito come input per ulteriori passaggi di pulizia del testo come la rimozione della punteggiatura, la rimozione dei caratteri numerici o la radice. I modelli di machine learning necessitano di dati numerici per essere addestrati e fare una previsione. La tokenizzazione delle parole diventa una parte cruciale della conversione del testo (stringa) in dati numerici. Si prega di leggere Borsa di parole o CountVectorizer. Si prega di fare riferimento all'esempio di tokenizzazione NLTK di seguito per comprendere meglio la teoria.
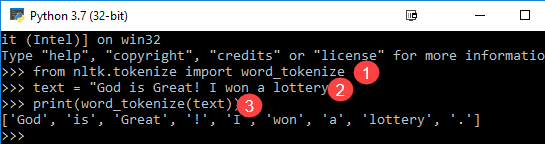
from nltk.tokenize import word_tokenize
text = "God is Great! I won a lottery."
print(word_tokenize(text))

Output: ['God', 'is', 'Great', '!', 'I', 'won', 'a', 'lottery', '.']
Code Spiegazione
- Il modulo word_tokenize viene importato dalla libreria NLTK.
- Una variabile “testo” viene inizializzata con due frasi.
- La variabile di testo viene passata nel modulo word_tokenize e viene stampato il risultato. Questo modulo spezza ogni parola con la punteggiatura che puoi vedere nell'output.
Tokenizzazione delle frasi
Il sottomodulo disponibile per quanto sopra è sent_tokenize. Una domanda ovvia nella tua mente sarebbe perché è necessaria la tokenizzazione delle frasi quando abbiamo la possibilità della tokenizzazione delle parole. Immagina di dover contare la media delle parole per frase, come calcolerai? Per eseguire tale attività, sono necessari sia il tokenizzatore di frasi NLTK sia il tokenizzatore di parole NLTK per calcolare il rapporto. Tale risultato costituisce una caratteristica importante per l'addestramento della macchina poiché la risposta sarebbe numerica.
Controlla l'esempio di tokenizzatore NLTK riportato di seguito per scoprire in che modo la tokenizzazione delle frasi è diversa dalla tokenizzazione delle parole.
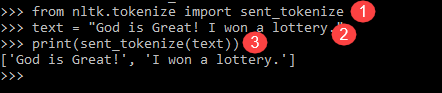
from nltk.tokenize import sent_tokenize
text = "God is Great! I won a lottery."
print(sent_tokenize(text))

Output: ['God is Great!', 'I won a lottery ']
Abbiamo 12 parole e due frasi per lo stesso ingresso.
Spiegazione del programma
- In una riga come il programma precedente, importa il modulo sent_tokenize.
- Abbiamo preso la stessa frase. Un ulteriore tokenizzatore di frasi nel modulo NLTK ha analizzato le frasi e mostrato l'output. È chiaro che questa funzione interrompe ogni frase.
Tokenizzatore sopra la parola Python esempi sono buone pietre da incastonatura per comprendere i meccanismi della tokenizzazione di parole e frasi.
