
Apprendimento automatico supervisionato: Algorithms, Tipi ed esempi
 Team editoriale
⚡ Riepilogo intelligente
L'apprendimento automatico supervisionato addestra un algoritmo su esempi etichettati in modo che possa prevedere i risultati per dati mai visti prima, utilizzando la regressione per obiettivi numerici e la classificazione per obiettivi categoriali come spam o frode.
Che cos'è l'apprendimento automatico supervisionato?
L'apprendimento automatico supervisionato è un algoritmo che apprende da dati di addestramento etichettati per aiutare a prevedere i risultati di dati imprevisti. Nell'apprendimento supervisionato, si addestra la macchina utilizzando dati ben "etichettati", ovvero dati già associati a risposte corrette. Può essere paragonato all'apprendimento in presenza di un supervisore o di un insegnante.
La creazione, la scalabilità e l'implementazione di modelli di apprendimento automatico supervisionato accurati richiedono tempo e competenze tecniche da parte di un team di data scientist altamente qualificati. I data scientist devono inoltre ricostruire periodicamente i modelli affinché le informazioni che producono rimangano valide anche al variare dei dati sottostanti.
Come funziona l'apprendimento supervisionato
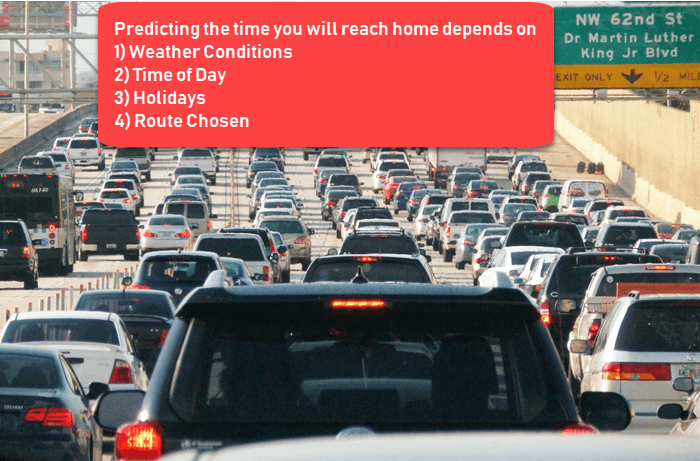
L'apprendimento automatico supervisionato utilizza set di dati di addestramento per ottenere i risultati desiderati. Questi set di dati contengono input e l'output corretto che aiuta il modello ad apprendere più velocemente. Ad esempio, vuoi addestrare una macchina per aiutarti a prevedere quanto tempo impiegherai per tornare a casa dal posto di lavoro.
Qui inizierai creando un set di dati etichettati. Questi dati includono:
- Condizioni meteo
- Ora del giorno
- Festività
- Percorso scelto
Tutti questi dettagli rappresentano i tuoi input in questo esempio di apprendimento supervisionato. L'output è il tempo impiegato per tornare a casa in quel giorno specifico, come mostrato nell'immagine sottostante.
Istintivamente sai che se fuori piove, ci metterai più tempo ad arrivare a casa in macchina. Ma la macchina ha bisogno di dati e statistiche.
La prima cosa da creare è un set di dati di addestramento. Questo set conterrà il tempo totale di percorrenza e i fattori correlati, come le condizioni meteorologiche, l'orario, ecc. Sulla base di questo set di dati di addestramento, il sistema potrebbe rilevare una relazione diretta tra la quantità di pioggia e il tempo impiegato per tornare a casa.
Quindi, si deduce che più piove, più tempo impiegherai a guidare per tornare a casa. Si potrebbe anche considerare la correlazione tra l'orario di uscita dal lavoro e il tempo che trascorrerai in strada. Più ci si avvicina alle 18:00, più tempo ci vorrà per arrivare a casa.
La tua macchina potrebbe individuare alcune delle relazioni con i tuoi dati etichettati. Questa fase di apprendimento è illustrata di seguito.
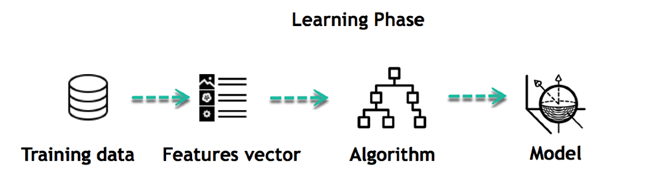
Questo è l'inizio del tuo modello di dati. Inizia a registrare come la pioggia influisce sul modo in cui le persone guidano e che un maggior numero di persone si sposta durante una determinata fascia oraria della giornata.
Tipi di machine learning supervisionato Algorithms
Di seguito sono riportati i tipi di algoritmi di apprendimento automatico supervisionato:
Regressione
La tecnica di regressione prevede un singolo valore di output continuo utilizzando i dati di addestramento.
Esempio: puoi utilizzare la regressione per prevedere il prezzo della casa dai dati di addestramento. Le variabili di input saranno la località, la dimensione di una casa, ecc.
Punti di forza: i risultati sono facili da interpretare e l'algoritmo può essere regolarizzato per evitare l'overfitting.
Punti deboli: un modello lineare non è flessibile, quindi non riesce a cogliere relazioni complesse senza l'aggiunta di nuove funzionalità.
Ecco alcuni tipi di regressione Algorithms:
- Regressione lineare
- Regressione polinomiale
- Regressione Ridge e Lasso
- Regressione logistica (per la classificazione)
- Regressione tramite albero decisionale e foresta casuale
- Supporta la regressione vettoriale
Regressione logistica:
La regressione logistica viene utilizzata per stimare valori discreti in base a un dato insieme di variabili indipendenti. Aiuta a prevedere la probabilità di occorrenza di un evento adattando i dati a una funzione logit. Per questo motivo, è anche nota come regressione logistica. Poiché prevede una probabilità, il suo valore di output è compreso tra 0 e 1 e potrebbe risultare meno efficace in presenza di confini decisionali multipli o non lineari.
Classificazione
Classificare significa raggruppare l'output all'interno di una classe. Se l'algoritmo tenta di etichettare l'input in due classi distinte, si parla di classificazione binaria. La selezione tra più di due classi è definita classificazione multiclasse.
Esempio: Determinare se una persona sarà o meno inadempiente nel pagamento del prestito.
Punti di forza: Gli alberi di classificazione funzionano molto bene nella pratica.
Punti deboli: non essendo vincolati, i singoli alberi sono soggetti a overfitting.
Ecco alcuni tipi di classificazione Algorithms:
- Classificatori Bayesiani ingenui
- Alberi decisionali
- Supporta la macchina vettoriale
- K-vicini più vicini
- Foresta casuale e boosting del gradiente
Classificatori Naive Bayes
Migliori Ingenuo Bayes Questo modello è facile da costruire e molto utile per grandi insiemi di dati. Il metodo si basa su grafi aciclici diretti con un nodo padre e diversi nodi figli. Presuppone l'indipendenza tra i nodi figli separati dal loro nodo padre.
Alberi decisionali
Gli alberi decisionali classificano un'istanza ordinandola in base al valore di una caratteristica. In questo metodo, ogni nodo rappresenta la caratteristica di un'istanza da classificare e ogni ramo rappresenta un valore che il nodo può assumere. È una tecnica di classificazione ampiamente utilizzata.
La stessa struttura funziona anche per la regressione: un albero di regressione aiuta a stimare valori reali (costo di acquisto di un'auto, numero di chiamate, vendite mensili totali, ecc.).
Supporta la macchina vettoriale
La Support Vector Machine (SVM) è un tipo di algoritmo di apprendimento introdotto negli anni '1990. Questo metodo si basa sui risultati della teoria dell'apprendimento statistico sviluppata da Vladimir Vapnik e dai suoi colleghi.
Le SVM sono anche strettamente connesse alle funzioni kernel, che sono un concetto centrale per la maggior parte delle attività di apprendimento. Il framework kernel e le SVM sono utilizzati in una varietà di campi. Tra questi figurano il recupero di informazioni multimediali, la bioinformatica e il riconoscimento di pattern. Ogni stimatore sopra menzionato è documentato con i suoi parametri di regolazione nel scikit-impara riferimento.
Tecniche di apprendimento automatico supervisionato e non supervisionato
Mettere il metodo accanto apprendimento senza supervisione definisce chiaramente i suoi confini.
| Basato su | Tecnica di machine learning supervisionata | Tecnica di machine learning non supervisionata |
|---|---|---|
| Dati in ingresso | Algorithms vengono addestrati utilizzando dati etichettati. | Algorithms vengono utilizzati rispetto a dati non etichettati |
| Complessità computazionale | L’apprendimento supervisionato è un metodo più semplice. | L'apprendimento non supervisionato è computazionalmente complesso |
| Precisione | Metodo estremamente accurato e affidabile. | Less metodo accurato e affidabile. |
| Algoritmi tipici | Regressione logistica, alberi decisionali, SVM, Naive Bayes | K-means, clustering gerarchico, PCA |
| Come vengono valutati i risultati | Punteggio calcolato rispetto alle risposte note (accuratezza, RMSE) | Valutato in base a criteri interni e a una revisione umana. |
Sfide nell'apprendimento automatico supervisionato
Ecco le sfide affrontate nell'apprendimento automatico supervisionato:
- Le caratteristiche di input irrilevanti nei dati di addestramento possono produrre risultati inaccurati
- La preparazione e la pre-elaborazione dei dati rappresentano sempre una sfida.
- L'accuratezza diminuisce quando vengono inseriti come dati di addestramento valori impossibili, improbabili e incompleti.
- Se l'esperto in questione non è disponibile, l'alternativa è la "forza bruta". Ciò significa che bisogna indovinare quali caratteristiche (variabili di input) utilizzare per addestrare la macchina, e questa intuizione potrebbe rivelarsi errata.
Vantaggi dell'apprendimento supervisionato
A fronte di queste sfide, ecco i vantaggi dell'apprendimento automatico supervisionato:
- Apprendimento supervisionato in machine Learning consente di raccogliere dati o produrre un output di dati da esperienze precedenti
- Ti aiuta a ottimizzare i criteri di prestazione utilizzando l'esperienza
- L'apprendimento automatico supervisionato ti aiuta a risolvere vari tipi di problemi di calcolo del mondo reale.
Svantaggi dell'apprendimento supervisionato
Di seguito sono elencati gli svantaggi dell'apprendimento automatico supervisionato:
- Il confine decisionale potrebbe essere sovra-addestrato se il set di addestramento non contiene esempi che si desidera avere in una classe
- Devi selezionare molti buoni esempi da ogni classe mentre stai addestrando il classificatore.
- Classificare i big data può essere una vera sfida.
- La formazione per l’apprendimento supervisionato richiede molto tempo di calcolo.
Migliori pratiche per l'apprendimento supervisionato
La seguente sequenza mantiene un progetto attivo track:
- Prima di fare qualsiasi altra cosa, decidi quale tipo di dati utilizzare come set di addestramento.
- Definisci la struttura della funzione da apprendere e l'algoritmo di apprendimento.
- Raccogli i risultati corrispondenti da esperti umani o da misurazioni
- Riserva un set di test che il modello non vedrà mai e riporta il punteggio ottenuto.
