
Schema del fiocco di neve nel modello di data warehouse
 David Carter
⚡ Riepilogo intelligente
Lo schema a fiocco di neve nella modellazione del data warehouse organizza tabelle di dimensioni normalizzate che si diramano da una tabella dei fatti centrale, assumendo la forma di un fiocco di neve. Estende lo schema a stella, riduce la ridondanza dei dati e organizza le gerarchie tra più tabelle di riferimento correlate.
Cos'è uno schema Snowflake?
A Schema del fiocco di neve in un data warehouse è una disposizione logica di tabelle in un database multidimensionale il cui diagramma entità-relazione (ER) assomiglia alla forma di un fiocco di neve. È un modello dimensionale in cui una tabella centrale dei fatti si collega alle tabelle delle dimensioni, e queste ultime sono ulteriormente suddivise in tabelle di sottodimensioni correlate.
Lo schema a fiocco di neve è un'estensione dello schema a stella. Mentre uno schema a stella mantiene ogni dimensione in un'unica tabella piatta, lo schema a fiocco di neve normalizza tali dimensioni, suddividendo i gruppi di dati ripetuti in tabelle di riferimento aggiuntive. Questa normalizzazione elimina la ridondanza e crea la struttura gerarchica e ramificata che dà il nome allo schema.
Esempio di schema del fiocco di neve
Nell'esempio di schema a fiocco di neve riportato di seguito, una tabella dei fatti relativa alle vendite si trova al centro, circondata da dimensioni quali Prodotto, Data e Negozio. Invece di memorizzare ogni attributo all'interno di un'unica tabella delle dimensioni, le informazioni geografiche vengono normalizzate in modo che il Paese venga spostato in una tabella separata.

In questo caso, la dimensione Negozio fa riferimento a una tabella Città, la tabella Città fa riferimento a una tabella Stato e la tabella Stato fa riferimento a una tabella Paese. Ogni valore viene memorizzato una sola volta e collegato tramite una chiave esterna, in modo che il nome di un Paese non venga mai ripetuto in milioni di righe. Questa normalizzazione a livelli è ciò che distingue uno schema a fiocco di neve da uno schema a stella piatto.
Caratteristiche dello schema Snowflake
Lo schema a fiocco di neve presenta diverse caratteristiche distintive:
- Utilizza meno spazio su disco, perché le tabelle dimensionali normalizzate evitano di memorizzare valori ripetuti.
- È possibile aggiungere nuove dimensioni allo schema con uno sforzo relativamente ridotto.
- Le prestazioni delle query possono diminuire, poiché il recupero dei dati richiede l'unione di numerose tabelle.
- Richiede un maggiore impegno in termini di manutenzione, poiché è necessario gestire un numero più elevato di tabelle di ricerca.
Come progettare uno schema a fiocco di neve
La progettazione di uno schema a fiocco di neve inizia come qualsiasi modello dimensionale, per poi aggiungere una fase di normalizzazione. L'obiettivo è identificare il processo aziendale da analizzare, modellarlo prima come uno schema a stella e quindi normalizzare le dimensioni che contengono gerarchie profonde. Segui i passaggi seguenti:
- Identificare il processo aziendale e la granularità. Decidi cosa rappresenta una singola riga della tabella dei fatti, ad esempio una transazione di vendita, e definisci le misure numeriche, o i fatti, che devi riportare.
- Costruisci la tabella centrale dei fatti. Sommate le misure numeriche insieme alle chiavi esterne che puntano a ciascuna dimensione; insieme, queste chiavi esterne formano solitamente la chiave primaria composta.
- Definire le tabelle dimensionali. Crea una tabella per ogni dimensione descrittiva, come Prodotto, Cliente, Data e Negozio, e assegna a ciascuna una chiave primaria surrogata.
- Normalizzare le gerarchie. Suddividi ogni dimensione che contiene attributi ripetuti in tabelle di sottodimensioni, ad esempio spostando la Categoria fuori dal Prodotto, oppure Città, Stato e Paese fuori dalla dimensione Negozio.
- Collega le tabelle tramite chiavi esterne. Collega ciascuna sottodimensione alla sua tabella principale in modo che i rami formino chiare gerarchie uno-a-molti che assomiglino a un fiocco di neve.
- Convalidare e testare con le query. Eseguire query di reporting rappresentative per confermare che le join restituiscano risultati corretti e che le prestazioni complessive rimangano accettabili.
Poiché il progetto normalizza i dati verso la terza forma normale, è fondamentale documentare chiaramente i percorsi di collegamento in modo che gli analisti comprendano come navigare in ciascun ramo. Una volta definita la struttura, è opportuno valutare i vantaggi e gli svantaggi dello schema.
Vantaggi dello schema a fiocco di neve
Lo schema a fiocco di neve offre numerosi vantaggi:
- Il suo vantaggio principale è la riduzione dello spazio di archiviazione su disco, poiché l'unione di tabelle di ricerca normalizzate più piccole evita la duplicazione dei dati dimensionali.
- Offre una maggiore scalabilità nelle relazioni tra componenti e livelli dimensionali.
- Elimina la ridondanza, migliorando l'integrità dei dati e semplificando la manutenzione del modello.
- Un attributo descrittivo viene aggiornato in un solo punto, riducendo così il rischio di dati incoerenti.
Svantaggi dello schema Snowflake
Il progetto comporta anche dei compromessi da valutare:
- La struttura normalizzata aumenta la manutenzione necessaria per gestire le numerose tabelle correlate.
- Le query complesse che coinvolgono più join possono essere difficili da scrivere e da comprendere.
- Un numero maggiore di tabelle implica un maggior numero di join, il che allunga i tempi di esecuzione delle query.
- Gli utenti aziendali spesso trovano il modello ramificato più difficile da navigare rispetto a un semplice schema a stella.
Schema a fiocco di neve vs. Schema a stella
Lo schema del fiocco di neve e il schema a stella Gli schemi a stella e a fiocco di neve sono i due modelli multidimensionali più comuni nei data warehousing, e la differenza principale tra loro risiede nella normalizzazione. Uno schema a stella mantiene ogni dimensione in un'unica tabella piatta e denormalizzata per massimizzare la velocità delle query, mentre uno schema a fiocco di neve normalizza tali dimensioni in diverse tabelle correlate per risparmiare spazio di archiviazione e proteggere l'integrità dei dati. Per questo motivo, i due schemi si adattano a priorità diverse.
| Aspetto | Schema a stella | Schema del fiocco di neve |
|---|---|---|
| Tabelle dimensionali | Denormalizzato, una tabella per dimensione | Normalizzato in tabelle di sottodimensioni |
| Archiviazione | Occupa più spazio a causa della ridondanza | Occupa meno spazio, nessuna ridondanza |
| Prestazioni di query | Più veloce, meno giunzioni | Più lento, più si unisce |
| Complessità della query | Semplice da scrivere | Più complesso |
| adatto per | Reportistica e business intelligence rapide | Dimensioni ampie e gerarchiche |
In sintesi, scegliete uno schema a stella quando la velocità delle query e la semplicità dei report sono le priorità, e uno schema a fiocco di neve quando l'efficienza dello storage, le gerarchie chiare e la bassa ridondanza dei dati sono prioritarie. Molti data warehouse reali combinano entrambi i modelli a seconda delle dimensioni e della profondità di ciascuna dimensione.
Quando utilizzare uno schema a fiocco di neve
Uno schema a fiocco di neve non è sempre la scelta giusta, quindi è utile adattare la progettazione al carico di lavoro e alle esigenze di reporting. Tende a funzionare meglio nelle seguenti situazioni:
- Le dimensioni sono molto grandi e contengono molti attributi ripetuti che sprecano spazio di archiviazione quando vengono denormalizzate.
- Le dimensioni presentano gerarchie profonde e ben definite, come Regione-Paese-Stato-Città, che si mappano naturalmente su tabelle separate.
- L'integrità e la coerenza dei dati sono più importanti per il progetto rispetto alla pura velocità di esecuzione delle query.
- I costi di archiviazione rappresentano una reale preoccupazione e il risparmio di spazio su disco ottenuto con tabelle dimensionali di grandi dimensioni è significativo.
- Il modello alimenta OLAP strumenti in grado di navigare in modo efficiente all'interno di gerarchie normalizzate.
Al contrario, quando la priorità è la creazione di report rapidi e semplici per gli analisti aziendali, uno schema a stella o un design ibrido a cluster di stelle è solitamente la soluzione migliore. Molti architetture di data warehouse combinare deliberatamente entrambi gli approcci per bilanciare velocità e capacità di archiviazione.
Cos'è uno schema Galaxy?
A Schema della galassia Contiene due o più tabelle dei fatti che condividono tabelle delle dimensioni. È anche chiamato schema di costellazione dei fatti e, poiché può essere visto come una collezione di stelle, prende il nome di schema galattico.
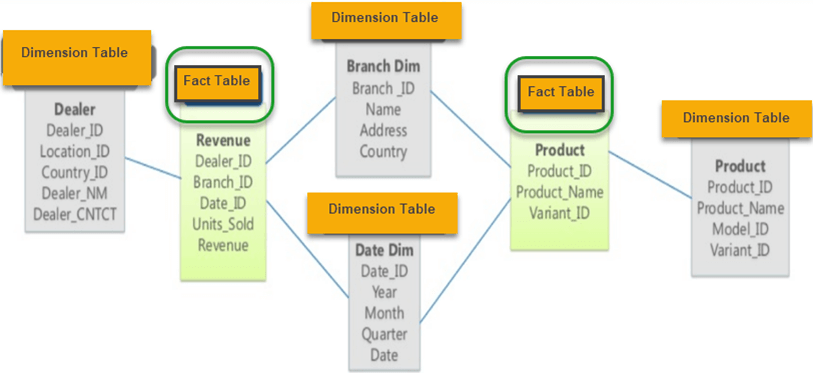
Come potete vedere nell'esempio qui sopra, ci sono due tabelle dei fatti:
- Revseguito
- Prodotto
In uno schema galassia, le dimensioni condivise tra le tabelle dei fatti sono chiamate dimensioni conformi.
Caratteristiche dello schema Galaxy
Lo schema della galassia presenta le seguenti caratteristiche:
- Le dimensioni sono suddivise in dimensioni distinte in base ai vari livelli della gerarchia.
- Ad esempio, se la geografia ha quattro livelli gerarchici (regione, paese, stato e città), allora lo schema della galassia dovrebbe avere quattro dimensioni.
- È possibile costruire questo tipo di schema suddividendo un singolo schema a stella in più schemi a stella.
- Le dimensioni in questo schema sono ampie e devono essere costruite in base ai livelli della gerarchia.
- Lo schema è utile per aggregare le tabelle dei fatti al fine di supportare una migliore analisi e comprensione.
Cos'è Stella Cluster Schema?
Uno schema a fiocco di neve contiene gerarchie completamente espanse, che possono aggiungere complessità e richiedere join extra. Uno schema a stella, d'altra parte, contiene gerarchie completamente compresse, che possono portare a ridondanza. La soluzione migliore è spesso un equilibrio tra questi due modelli, noto come schema a stella. Cluster Schema.
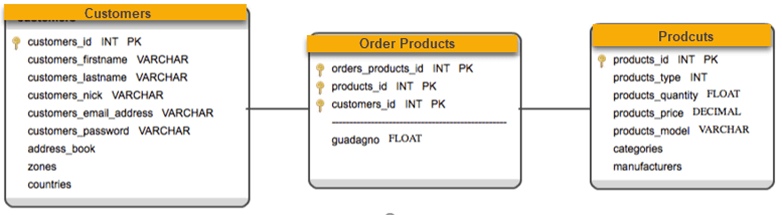
sovrapposizioneping Le dimensioni appaiono come biforcazioni nelle gerarchie. Una biforcazione si verifica quando un'entità funge da genitore in due diverse gerarchie dimensionali. Queste entità biforcate vengono quindi identificate come classificazioni con relazioni uno-a-molti, il che limita il numero di tabelle aggiuntive create dal progetto.
