
Modello Seq2seq (Sequence to Sequence) con PyTorch
 Evelyn Clarke
⚡ Riepilogo intelligente
Seq2Seq è un'architettura encoder-decoder che mappa una sequenza di input in una sequenza di output utilizzando due reti neurali ricorrenti, ed è alla base della traduzione automatica e di altre attività di elaborazione del linguaggio naturale in cui la lunghezza dell'input e dell'output differisce.
Che cos'è la PNL?
L'elaborazione del linguaggio naturale (NLP) è uno dei rami più popolari dell'intelligenza artificiale che aiuta i computer a comprendere, manipolare o rispondere a un essere umano nel suo linguaggio naturale. L'NLP è il motore alla base Google Translate che ci aiuta a capire altre lingue.
Cos'è Seq2Seq?
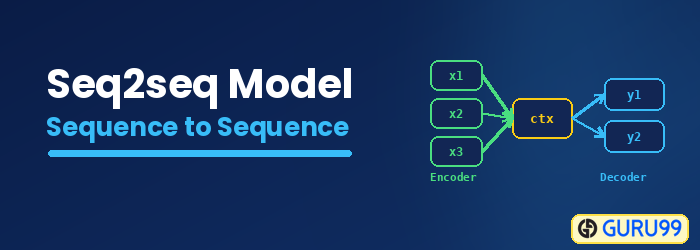
Seq2Seq è un metodo di traduzione automatica ed elaborazione del linguaggio basato su codificatore-decodificatore che mappa un input di sequenza su un output di sequenza con un tag e un valore di attenzione. L'idea è quella di utilizzare 2 RNN che lavoreranno insieme con un token speciale e proveranno a prevedere la sequenza di stati successiva dalla sequenza precedente.
Come prevedere la sequenza dalla sequenza precedente
Di seguito sono riportati i passaggi per prevedere una sequenza dalla sequenza precedente con PyTorch.
Passaggio 1) Caricamento dei nostri dati
Per il nostro set di dati, utilizzerai un set di dati da Coppie di frasi bilingue delimitate da tabulazioni. Qui utilizzerò il set di dati dall'inglese all'indonesiano. Puoi scegliere quello che preferisci, ma ricorda di cambiare il nome del file e la directory nel codice.
from __future__ import unicode_literals, print_function, division
import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as F

import numpy as np
import pandas as pd

import os
import re
import random

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
Passaggio 2) Preparazione dei dati
Non è possibile utilizzare direttamente il dataset. È necessario suddividere le frasi in parole e convertirle in un One-Hot Vector. Ogni parola verrà indicizzata in modo univoco nella classe Lang per creare un dizionario. La classe Lang memorizzerà ogni frase e la suddividerà parola per parola con addSentence. Quindi, crea un dizionario indicizzando ogni parola sconosciuta per i modelli Sequence to sequence.
SOS_token = 0
EOS_token = 1
MAX_LENGTH = 20

#initialize Lang Class
class Lang:
   def __init__(self):
       #initialize containers to hold the words and corresponding index
       self.word2index = {}
       self.word2count = {}
       self.index2word = {0: "SOS", 1: "EOS"}
       self.n_words = 2  # Count SOS and EOS

#split a sentence into words and add it to the container
   def addSentence(self, sentence):
       for word in sentence.split(' '):
           self.addWord(word)

#If the word is not in the container, the word will be added to it, else, update the word counter
   def addWord(self, word):
       if word not in self.word2index:
           self.word2index[word] = self.n_words
           self.word2count[word] = 1
           self.index2word[self.n_words] = word
           self.n_words += 1
       else:
           self.word2count[word] += 1
La classe Lang ci aiuterà a creare un dizionario. Per ogni lingua, ogni frase verrà suddivisa in parole e poi aggiunta a un contenitore. Ogni contenitore memorizzerà le parole nell'indice appropriato, conterà le parole e aggiungerà l'indice della parola in modo da poterlo utilizzare per trovare l'indice di una parola o per trovare una parola dal suo indice.
Poiché i nostri dati sono separati da TAB, è necessario utilizzare panda come nostro caricatore di dati. Pandas leggerà i nostri dati come un dataFrame e li dividerà nella frase di origine e in quella di destinazione. Per ogni frase, la normalizzerai in minuscolo, rimuoverai tutti i caratteri non validi, la convertirai da Unicode ad ASCII e dividerai le frasi in modo da ottenere ogni parola.
#Normalize every sentence
def normalize_sentence(df, lang):
   sentence = df[lang].str.lower()
   sentence = sentence.str.replace('[^A-Za-z\s]+', '')
   sentence = sentence.str.normalize('NFD')
   sentence = sentence.str.encode('ascii', errors='ignore').str.decode('utf-8')
   return sentence

def read_sentence(df, lang1, lang2):
   sentence1 = normalize_sentence(df, lang1)
   sentence2 = normalize_sentence(df, lang2)
   return sentence1, sentence2

def read_file(loc, lang1, lang2):
   df = pd.read_csv(loc, delimiter='\t', header=None, names=[lang1, lang2])
   return df

def process_data(lang1,lang2):
   df = read_file('text/%s-%s.txt' % (lang1, lang2), lang1, lang2)
   print("Read %s sentence pairs" % len(df))
   sentence1, sentence2 = read_sentence(df, lang1, lang2)

   source = Lang()
   target = Lang()
   pairs = []
   for i in range(len(df)):
       if len(sentence1[i].split(' ')) < MAX_LENGTH and len(sentence2[i].split(' ')) < MAX_LENGTH:
           full = [sentence1[i], sentence2[i]]
           source.addSentence(sentence1[i])
           target.addSentence(sentence2[i])
           pairs.append(full)

   return source, target, pairs
Un'altra funzione utile che utilizzerete è la conversione delle coppie in tensori. Questo è molto importante perché la nostra rete legge solo dati di tipo tensore. È importante anche perché in questa fase, alla fine di ogni frase, verrà inserito un token che indicherà alla rete che l'input è terminato. Per ogni parola della frase, verrà recuperato l'indice corrispondente dalla parola nel dizionario e verrà aggiunto un token alla fine della frase.
def indexesFromSentence(lang, sentence):
   return [lang.word2index[word] for word in sentence.split(' ')]

def tensorFromSentence(lang, sentence):
   indexes = indexesFromSentence(lang, sentence)
   indexes.append(EOS_token)
   return torch.tensor(indexes, dtype=torch.long, device=device).view(-1, 1)

def tensorsFromPair(input_lang, output_lang, pair):
   input_tensor = tensorFromSentence(input_lang, pair[0])
   target_tensor = tensorFromSentence(output_lang, pair[1])
   return (input_tensor, target_tensor)
Modello Seq2Seq

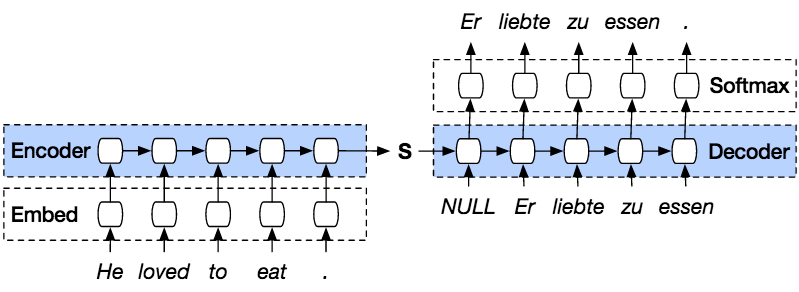
PyTorIl modello ch Seq2seq è un tipo di modello che utilizza un PyTorIl modello prevede un codificatore e un decodificatore. Il codificatore codifica la frase parola per parola in un indice di vocabolario o di parole note con un indice, e il decodificatore prevede l'output dell'input codificato decodificando l'input in sequenza e cercando di utilizzare l'ultimo input come input successivo, se possibile. Con questo metodo, è anche possibile prevedere l'input successivo per creare una frase. A ogni frase viene assegnato un token per contrassegnare la fine della sequenza. Al termine della previsione, ci sarà anche un token per contrassegnare la fine dell'output. Quindi, dal codificatore, viene passato uno stato al decodificatore per prevedere l'output.

L'encoder codificherà la nostra frase di input parola per parola in sequenza e alla fine ci sarà un token per contrassegnare la fine di una frase. L'encoder è costituito da un livello di embedding e da un livello GRU. Il livello di embedding è una tabella di ricerca che memorizza l'embedding del nostro input in un dizionario di parole di dimensioni fisse. Verrà passato a un livello GRU. Il livello GRU è un'unità ricorrente con gate che consiste in un tipo multistrato di RNN che calcolerà l'input sequenziato. Questo livello calcolerà lo stato nascosto da quello precedente e aggiornerà il ripristino, l'aggiornamento e le nuove porte.

Il decodificatore decodificherà l'input dall'output del codificatore. Cercherà di prevedere l'output successivo e, se possibile, di utilizzarlo come input successivo. Il decodificatore è composto da un livello di embedding, un livello GRU e un livello lineare. Il livello di embedding creerà una tabella di lookup per l'output e la passerà a un livello GRU per calcolare lo stato di output previsto. Successivamente, un livello lineare contribuirà a calcolare la funzione di attivazione per determinare il valore reale dell'output previsto.
class Encoder(nn.Module):
   def __init__(self, input_dim, hidden_dim, embbed_dim, num_layers):
       super(Encoder, self).__init__()

       #set the encoder input dimesion , embbed dimesion, hidden dimesion, and number of layers
       self.input_dim = input_dim
       self.embbed_dim = embbed_dim
       self.hidden_dim = hidden_dim
       self.num_layers = num_layers

       #initialize the embedding layer with input and embbed dimention
       self.embedding = nn.Embedding(input_dim, self.embbed_dim)
       #intialize the GRU to take the input dimetion of embbed, and output dimention of hidden and
       #set the number of gru layers
       self.gru = nn.GRU(self.embbed_dim, self.hidden_dim, num_layers=self.num_layers)

   def forward(self, src):
       embedded = self.embedding(src).view(1,1,-1)
       outputs, hidden = self.gru(embedded)
       return outputs, hidden

class Decoder(nn.Module):
   def __init__(self, output_dim, hidden_dim, embbed_dim, num_layers):
       super(Decoder, self).__init__()

#set the encoder output dimension, embed dimension, hidden dimension, and number of layers
       self.embbed_dim = embbed_dim
       self.hidden_dim = hidden_dim
       self.output_dim = output_dim
       self.num_layers = num_layers

# initialize every layer with the appropriate dimension. For the decoder layer, it will consist of an embedding, GRU, a Linear layer and a Log softmax activation function.
       self.embedding = nn.Embedding(output_dim, self.embbed_dim)
       self.gru = nn.GRU(self.embbed_dim, self.hidden_dim, num_layers=self.num_layers)
       self.out = nn.Linear(self.hidden_dim, output_dim)
       self.softmax = nn.LogSoftmax(dim=1)

   def forward(self, input, hidden):
# reshape the input to (1, batch_size)
       input = input.view(1, -1)
       embedded = F.relu(self.embedding(input))
       output, hidden = self.gru(embedded, hidden)
       prediction = self.softmax(self.out(output[0]))
       return prediction, hidden

class Seq2Seq(nn.Module):
   def __init__(self, encoder, decoder, device, MAX_LENGTH=MAX_LENGTH):
       super().__init__()

#initialize the encoder and decoder
       self.encoder = encoder
       self.decoder = decoder
       self.device = device

   def forward(self, source, target, teacher_forcing_ratio=0.5):
       input_length = source.size(0) #get the input length (number of words in sentence)
       batch_size = target.shape[1]
       target_length = target.shape[0]
       vocab_size = self.decoder.output_dim

#initialize a variable to hold the predicted outputs
       outputs = torch.zeros(target_length, batch_size, vocab_size).to(self.device)

#encode every word in a sentence
       for i in range(input_length):
           encoder_output, encoder_hidden = self.encoder(source[i])

#use the encoder's hidden layer as the decoder hidden
       decoder_hidden = encoder_hidden.to(device)

#add a token before the first predicted word
       decoder_input = torch.tensor([SOS_token], device=device)  # SOS

#topk is used to get the top K value over a list
#predict the output word from the current target word. If we enable the teaching force, then the next decoder input is the next word, else, use the decoder output highest value.
       for t in range(target_length):
           decoder_output, decoder_hidden = self.decoder(decoder_input, decoder_hidden)
           outputs[t] = decoder_output
           teacher_force = random.random() < teacher_forcing_ratio
           topv, topi = decoder_output.topk(1)
           input = (target[t] if teacher_force else topi)
           if(teacher_force == False and input.item() == EOS_token):
               break

       return outputs
Passaggio 3) Addestramento del modello
Il processo di addestramento nei modelli Seq2seq inizia con la conversione di ogni coppia di frasi in tensori a partire dal loro indice di lingua. Il nostro modello sequence-to-sequence utilizzerà SGD come ottimizzatore e la funzione NLLLoss per calcolare le perdite. Il processo di addestramento inizia alimentando il modello con la coppia di frasi per prevedere l'output corretto. Ad ogni passaggio, l'output del modello verrà calcolato con le parole corrette per trovare le perdite e aggiornare i parametri. Poiché verranno utilizzate 75000 iterazioni, il nostro modello sequence-to-sequence genererà 75000 coppie casuali dal nostro dataset.
teacher_forcing_ratio = 0.5

def clacModel(model, input_tensor, target_tensor, model_optimizer, criterion):
   model_optimizer.zero_grad()

   input_length = input_tensor.size(0)
   loss = 0
   epoch_loss = 0
   # print(input_tensor.shape)

   output = model(input_tensor, target_tensor)

   num_iter = output.size(0)
   print(num_iter)

#calculate the loss from a predicted sentence with the expected result
   for ot in range(num_iter):
       loss += criterion(output[ot], target_tensor[ot])

   loss.backward()
   model_optimizer.step()
   epoch_loss = loss.item() / num_iter

   return epoch_loss

def trainModel(model, source, target, pairs, num_iteration=20000):
   model.train()

   optimizer = optim.SGD(model.parameters(), lr=0.01)
   criterion = nn.NLLLoss()
   total_loss_iterations = 0

   training_pairs = [tensorsFromPair(source, target, random.choice(pairs))
                     for i in range(num_iteration)]

   for iter in range(1, num_iteration+1):
       training_pair = training_pairs[iter - 1]
       input_tensor = training_pair[0]
       target_tensor = training_pair[1]

       loss = clacModel(model, input_tensor, target_tensor, optimizer, criterion)

       total_loss_iterations += loss

       if iter % 5000 == 0:
           avarage_loss= total_loss_iterations / 5000
           total_loss_iterations = 0
           print('%d %.4f' % (iter, avarage_loss))

   torch.save(model.state_dict(), 'mytraining.pt')
   return model
Passaggio 4) Testare il modello
Il processo di valutazione di Seq2seq PyTorIl passaggio successivo consiste nel verificare l'output del modello. Ogni coppia di modelli Sequence to Sequence verrà inserita nel modello e genererà le parole previste. Dopodiché, si analizzerà il valore più alto in ogni output per trovare l'indice corretto. Infine, lo si confronterà per vedere se la previsione del modello corrisponde alla frase reale.
def evaluate(model, input_lang, output_lang, sentences, max_length=MAX_LENGTH): with torch.no_grad(): input_tensor = tensorFromSentence(input_lang, sentences[0]) output_tensor = tensorFromSentence(output_lang, sentences[1]) decoded_words = [] output = model(input_tensor, output_tensor) # print(output_tensor) for ot in range(output.size(0)): topv, topi = output[ot].topk(1) # print(topi) if topi[0].item() == EOS_token: decoded_words.append('' ) break else: decoded_words.append(output_lang.index2word[topi[0].item()]) return decoded_words def evaluateRandomly(model, source, target, pairs, n=10): for i in range(n): pair = random.choice(pairs) print('source {}'.format(pair[0])) print('target {}'.format(pair[1])) output_words = evaluate(model, source, target, pair) output_sentence = ' '.join(output_words) print('predicted {}'.format(output_sentence))
Ora, iniziamo il nostro addestramento con Seq to Seq, con un numero di iterazioni pari a 75000 e un numero di strati RNN pari a 1 con una dimensione nascosta di 512.
lang1 = 'eng'
lang2 = 'ind'
source, target, pairs = process_data(lang1, lang2)

randomize = random.choice(pairs)
print('random sentence {}'.format(randomize))

#print number of words
input_size = source.n_words
output_size = target.n_words
print('Input : {} Output : {}'.format(input_size, output_size))

embed_size = 256
hidden_size = 512
num_layers = 1
num_iteration = 100000

#create encoder-decoder model
encoder = Encoder(input_size, hidden_size, embed_size, num_layers)
decoder = Decoder(output_size, hidden_size, embed_size, num_layers)

model = Seq2Seq(encoder, decoder, device).to(device)

#print model
print(encoder)
print(decoder)

model = trainModel(model, source, target, pairs, num_iteration)
evaluateRandomly(model, source, target, pairs)
Come puoi vedere, la nostra frase prevista non corrisponde molto bene, quindi per ottenere una maggiore precisione, devi allenarti con molti più dati e provare ad aggiungere più iterazioni e numero di livelli utilizzando Sequence per sequenziare l'apprendimento.
random sentence ['tom is finishing his work', 'tom sedang menyelesaikan pekerjaannya']
Input : 3551 Output : 4253
Encoder(
  (embedding): Embedding(3551, 256)
  (gru): GRU(256, 512)
)
Decoder(
  (embedding): Embedding(4253, 256)
  (gru): GRU(256, 512)
  (out): Linear(in_features=512, out_features=4253, bias=True)
  (softmax): LogSoftmax()
)
5000 4.0906
10000 3.9129
15000 3.8171
20000 3.8369
25000 3.8199
30000 3.7957
75000 3.7044
