
SAP HANA Archistruttura: Panoramica del database
 Muratore Garcia
⚡ Riepilogo intelligente
SAP HANA ArchiTecnizzazione, Paesaggio e Dimensionamento costituiscono le fondamenta di una piattaforma dati in memoria basata su SUSE Linux e C++Questo articolo illustra il server di indicizzazione, i motori di archiviazione, gli archivi a righe e a colonne, la fusione delta e i metodi di dimensionamento hardware.
Cosa è SAP Database HANA?
SAP HANA è una piattaforma di gestione dati incentrata sulla memoria principale. Il database viene eseguito su SUSE Linux Enterprise Server (SLES) e Red Hat Enterprise Linux (RHEL) ed è scritto in C++È in grado di scalare orizzontalmente su più macchine per gestire carichi di lavoro molto elevati.
Principali vantaggi di SAP HANA:
- Prestazioni di interrogazione estremamente rapide grazie al caricamento di tutti i dati in memoria, che elimina le lente operazioni di I/O su disco dal percorso critico.
- Integrazione di OLAP (Online Analytical Processing) e OLTP (Online Transaction Processing) sullo stesso database, semplificando la gestione dei dati.
SAP HANA Database è costituito da un insieme di motori di elaborazione in memoria. Il motore di calcolo è il principale e interagisce con altri motori come il motore relazionale (archivio righe e colonne), il motore OLAP, il motore di testo e il motore grafico. Una tabella relazionale risiede nell'archivio righe o nell'archivio colonne, e i motori aggiuntivi gestiscono i dati testuali e grafici finché la memoria è disponibile.
SAP HANA Architectura
I dati nell'archivio a colonne vengono compressi utilizzando tecniche quali la codifica a dizionario, la codifica run-length, la codifica sparsa, la codifica a cluster e la codifica indiretta. Quando viene raggiunto il limite della memoria principale, gli oggetti del database non in uso (tabelle, viste, ecc.) vengono scaricati automaticamente su disco e ricaricati quando richiesti nuovamente.
Gli amministratori possono anche caricare o scaricare manualmente una singola tabella facendo clic con il pulsante destro del mouse sulla tabella in SAP Studio HANA e scegliendo scaricare or Caricare.
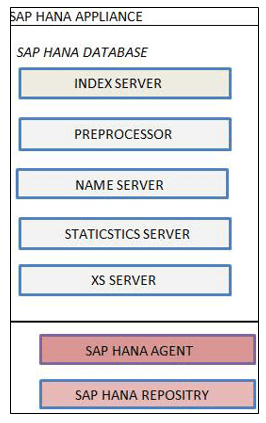
SAP Il server HANA è composto da:
- Server dell'indice
- Server preprocessore
- Nome server
- Server statistiche
- Motore XS
1. SAP Server dell'indice HANA
L'Index Server è il principale SAP Componente del database HANA:
- È il cuore del SAP Motore di database HANA.
- Contiene gli archivi dati veri e propri e i motori che elaborano i dati.
- Esegue le istruzioni SQL e MDX in ingresso.
L'architettura dell'Index Server è illustrata di seguito.

SAP Panoramica di HANA Index Server
- Responsabile Sessioni e Transazioni: Il componente Session gestisce le connessioni e le sessioni per il database. Il Transaction Manager coordina e controlla tutte le transazioni.
- Processore SQL e MDX: Il processore SQL invia le query al motore appropriato (SQL / SQL Script / R / Calc Engine). Il processore MDX gestisce le query multidimensionali (ad esempio, rispetto a una vista analitica).
- Motore SQL/Script SQL/R/Calc: Esegue query SQL, script SQL, codice R e modelli di calcolo sui dati.
- repository: Mantiene la gestione delle versioni per SAP Oggetti di metadati HANA come viste attributo, viste analitiche e stored procedure.
- Livello di persistenza: Offre funzionalità integrate di ripristino di emergenza scrivendo punti di salvataggio e registri sul volume dati su disco.
2. Server di preelaborazione
Il server di preelaborazione viene utilizzato dall'analisi del testo. EssotracEsegue il testualizzazione e prepara i dati dal contenuto testuale quando viene richiamata la funzione di ricerca.
3. Server dei nomi
Il Name Server contiene informazioni sull'intero panorama del sistema. In una distribuzione distribuita tracks ogni componente in esecuzione e la posizione dei dati sui nodi, in modo che le query possano essere instradate al server corretto.
4. Server delle statistiche
Il server delle statistiche raccoglie dati sullo stato, sull'allocazione delle risorse, sul consumo e sulle prestazioni per il SAP Sistema HANA. Nota: in HANA SPS 7 e versioni successive, il servizio di statistiche integrato viene eseguito all'interno del server di indicizzazione anziché come processo autonomo.
5. Server XS
Il server XS ospita il motore XS, che consente ad applicazioni e sviluppatori esterni di utilizzare il SAP Database HANA tramite HTTP. XS Engine funge da server HTTP leggero, consentendo ai client basati su browser e REST di comunicare direttamente con HANA.
SAP Paesaggio HANA
“HANA” sta per Apparecchio analitico ad alte prestazioni e viene fornita come piattaforma combinata hardware e software.
- L'hardware moderno offre molti più core CPU, RAM e larghezza di banda di archiviazione rispetto a quanto fosse previsto dai server di database di vecchia generazione.
- SAP HANA sfrutta questo mantenendoping Tutti i dati di lavoro risiedono nella memoria principale, eliminando il collo di bottiglia dell'I/O del disco che limita i database tradizionali.
Il diagramma sottostante riassume il SAP Innovazioni hardware e software di HANA.

SAP HANA supporta due archivi dati relazionali: Negozio di fila and Negozio di colonne.
Negozio di fila
Row Store si comporta come un database tradizionale (Oracle, SQL Server). La differenza fondamentale è che tutte le righe risiedono nella memoria principale in SAP HANA, mentre un database tradizionale li conserva principalmente su disco.
Negozio di colonne
Column Store memorizza i dati in formato colonnare in memoria. Le tabelle a colonne vengono memorizzate qui e il motore bilancia buone prestazioni di scrittura con prestazioni di lettura ottimizzate. Il diagramma seguente mostra le due strutture che raggiungono questo equilibrio.

Memoria principale
La memoria principale contiene la maggior parte dei dati. Metodi di compressione come la codifica a dizionario, la codifica a cluster, la codifica sparsa e la codifica a lunghezza variabile vengono applicati per risparmiare memoria e velocizzare le ricerche.
- La modifica diretta dei dati compressi nella memoria principale è un'operazione costosa, pertanto le operazioni di scrittura non vengono indirizzate alla memoria principale.
- Invece, ogni modifica viene scritta in un'area separata chiamata Delta ArchiviazioneLe operazioni di lettura possono accedere alla memoria principale o alla memoria delta.
I dati possono essere caricati o scaricati manualmente utilizzando il Carica nella memoria and Scaricato dalla memoria opzioni mostrate di seguito.

Delta Archiviazione
Delta L'archiviazione è ottimizzata per le scritture e utilizza una compressione più leggera. Tutte le modifiche non confermate a una tabella di colonne vengono mantenute qui. Quando le modifiche devono essere unite nuovamente nell'archiviazione principale, eseguire il Delta Unire operazione da SAP Studio HANA.

- L'operazione di unione delta sposta le modifiche raccolte nell'archivio delta nell'archivio principale.
- Dopo l'unione, il nuovo contenuto di archiviazione principale viene salvato su disco e la compressione viene ricalcolata.
Come i dati si spostano da Delta al magazzino principale

Un buffer organizzato per righe chiamato L1-Delta si trova davanti a ogni tabella a colonne, ed è per questo che una tabella a colonne può gestire scritture ad alto throughput.
- L'utente esegue un'operazione di UPDATE o INSERT sulla tabella.
- I dati arrivano prima in L1-Delta (dati non ancora confermati).
- Una volta confermati, i dati vengono spostati nella L2- orientata alle colonneDelta tampone.
- Quando L2-Delta quando è pieno o quando viene eseguita l'unione, i dati vengono scritti nella memoria principale.
L'archiviazione a colonne è quindi ottimizzata sia per la scrittura (tramite delta L1 e L2) sia per la lettura (tramite la memoria principale). Dopo l'elaborazione, i dati vengono salvati su disco dal livello di persistenza.
Esempio di tabella basata su righe:

La stessa tabella logica viene memorizzata su disco in modo diverso a seconda del tipo di archivio. In Row Store, le righe vengono scritte in modo contiguo:

In Column Store, i valori della stessa colonna vengono memorizzati insieme:

Poiché i valori delle colonne condividono lo stesso tipo di dati e spesso si ripetono, il layout delle colonne si comprime in modo estremamente efficiente, il che rappresenta il principale vantaggio in termini di memoria dell'archivio a colonne.

SAP Dimensionamento HANA
Il dimensionamento è il processo di determinazione delle risorse hardware — RAM, disco e CPU — necessarie per un SAP Sistema HANA. La memoria è il fattore più importante, la CPU è al secondo posto e il disco deriva dai primi due.
In un SAP Nell'implementazione di HANA, la scelta della dimensione del server più adatta al carico di lavoro aziendale è una delle attività più critiche. Rispetto a un DBMS tradizionale, il dimensionamento di HANA differisce in tre aree:
- Memoria principale: guidato dai metadati e dal volume di dati transazionali e analitici memorizzati.
- CPU: stimato anziché misurato, in base alle query di previsione e ai modelli di carico.
- disco: Dimensionato per la persistenza dei dati e i volumi di log, non per i dati delle query online.
Rispetto al database precedente, la CPU e la memoria del server applicativo rimangono invariate, poiché HANA sostituisce solo il livello del database.
SAP offre diversi metodi per calcolare la taglia corretta:
- Dimensionamento tramite un report ABAP (codice transazione) ST03 dati e report /SDF/HDB_SIZING).
- Dimensionamento tramite script di database per sistemi non ABAP.
- Dimensionamento utilizzando il SAP Tagliatore rapido strumento sul SAP Mercato dei servizi.
Quando si utilizza lo strumento Quick Sizer, il requisito viene visualizzato nel formato seguente.

