
Modello relazionale dei dati nei DBMS: Concepts & Esempio
 Team editoriale
⚡ Riepilogo intelligente
Il modello relazionale rappresenta un database come una collezione di relazioni, dove ogni relazione è una tabella di righe e colonne. Definisce i concetti fondamentali, i vincoli di integrità e le operazioni di aggiornamento che mantengono i dati relazionali coerenti e facili da interrogare.
Cos'è il modello relazionale?
Modello Relazionale (RM) rappresenta il database come una raccolta di relazioni. Una relazione non è altro che una tabella di valori. Ogni riga nella tabella rappresenta una raccolta di valori di dati correlati. Queste righe nella tabella indicano un'entità o una relazione del mondo reale.
Il nome della tabella e i nomi delle colonne aiutano a interpretare il significato dei valori in ogni riga. I dati sono rappresentati come un insieme di relazioni. Nel modello relazionale, i dati vengono memorizzati come tabelle. Tuttavia, la memorizzazione fisica dei dati è indipendente dal modo in cui i dati sono organizzati logicamente.
Il modello fu proposto da E.F. Codd nel 1970 e rimane il fondamento di quasi tutti i principali database attualmente in uso. Alcuni sistemi di gestione di database relazionali diffusi sono:
- Server dinamico DB2 e Informix – IBM
- Oracle e RDB – Oracle
- SQL Server e accesso – Microsoft
Modello relazionale Concepts nel DBMS
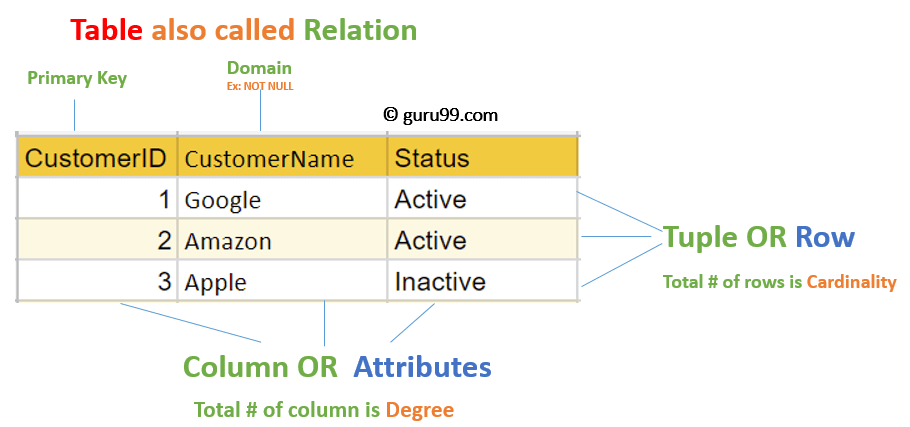
- Attributo: Ogni colonna di una tabella. Gli attributi sono le proprietà che definiscono una relazione, ad esempio, Student_Rollno, NAME, ecc.
- tabelle: Nel modello relazionale, le relazioni vengono salvate in formato tabellare. Vengono memorizzate insieme alle relative entità. Una tabella ha due proprietà: righe e colonne. Le righe rappresentano i record e le colonne rappresentano gli attributi.
- tupla: Non è altro che una singola riga di una tabella, che contiene un singolo record.
- Schema di relazione: Uno schema di relazione rappresenta il nome della relazione con i suoi attributi.
- Grado: Il numero totale di attributi in una relazione è chiamato grado della relazione.
- Cardinalità: Il numero totale di righe presenti nella tabella.
- Colonna: La colonna rappresenta l'insieme di valori per un attributo specifico.
- Istanza di relazione: Un'istanza di relazione è un insieme finito di tuple nel sistema RDBMS. Le istanze di relazione non contengono mai tuple duplicate.
- Chiave di relazione: Ogni riga possiede uno, due o più attributi, chiamati chiave di relazione.
- Dominio degli attributi: Ogni attributo ha un valore e un ambito predefiniti, noti come dominio dell'attributo.
Con il vocabolario a posto, la prossima preoccupazione è mantenerloping i dati in tali relazioni sono validi, compito che spetta ai vincoli di integrità.
Relazionale Integrity vincoli
I vincoli di integrità relazionale nei DBMS si riferiscono alle condizioni che devono essere presenti affinché una relazione sia valida. Questi vincoli relazionali derivano dalle regole del mini-mondo che il database rappresenta.
Esistono molti tipi di vincoli di integrità. I vincoli sui sistemi di gestione di database relazionali si dividono principalmente in tre categorie principali:
- Vincoli di dominio
- Vincoli chiave
- Referenziale Integrity vincoli
Vincoli di dominio
I vincoli di dominio possono essere violati se il valore di un attributo non compare nel dominio corrispondente o se non è del tipo di dati appropriato.
I vincoli di dominio specificano che all'interno di ogni tupla il valore di ciascun attributo deve essere atomico e tratto dal dominio corretto. I domini sono specificati come tipi di dati, che includono tipi standard come numeri interi, numeri reali, caratteri, valori booleani e stringhe a lunghezza variabile.
Esempio:
CREATE DOMAIN CustomerName
CHECK (value NOT NULL)
L'esempio mostrato illustra come creare un vincolo di dominio in modo che CustomerName non sia NULL.
Vincoli chiave
Un attributo che può identificare in modo univoco una tupla in una relazione è chiamato chiave della tabella. Il valore dell'attributo per diverse tuple nella relazione deve essere unico.
Esempio:
Nella tabella fornita, CustomerID è un attributo chiave della tabella Customer. È molto probabile che abbia una sola chiave per un cliente; CustomerID = 1 è solo per CustomerName “Google"Un trattamento completo dei diversi tipi di chiave è trattato nella guida a Chiavi DBMS.
| Identificativo del cliente | Nome del cliente | Stato |
|---|---|---|
| 1 | Active | |
| 2 | Amazon | Active |
| 3 | Mela | Inattivo |
Referenziale Integrity vincoli
I vincoli di integrità referenziale nei DBMS si basano sul concetto di chiave esterna. Una chiave esterna è un attributo importante di una relazione a cui si deve fare riferimento in altre relazioni. Un vincolo di integrità referenziale si verifica quando una relazione fa riferimento a un attributo chiave di una relazione diversa o della stessa relazione. Tale elemento chiave deve esistere nella tabella a cui si fa riferimento.
Esempio:

Nell'esempio precedente abbiamo due relazioni, Cliente e BillING.
La tupla per CustomerID = 1 viene referenziata due volte nella relazione Billing. Quindi sappiamo CustomerName “Google" ha un importo di fatturazione di 300 dollari.
Operazioni nel modello relazionale
Sul modello di database relazionale vengono eseguite quattro operazioni di aggiornamento fondamentali: inserimento, aggiornamento, eliminazione e selezione.
- La funzione Insert viene utilizzata per inserire dati nella relazione.
- Elimina viene utilizzato per eliminare le tuple dalla tabella.
- Modifica consente di modificare i valori di alcuni attributi nelle tuple esistenti.
- Seleziona consente di scegliere un intervallo specifico di dati.
Ogni qualvolta venga eseguita una di queste operazioni, i vincoli di integrità specificati nello schema del database relazionale non devono mai essere violati.
inserire Operaproduzione
L'operazione di inserimento restituisce i valori degli attributi per una nuova tupla che deve essere inserita in una relazione.

Aggiornanento Operaproduzione
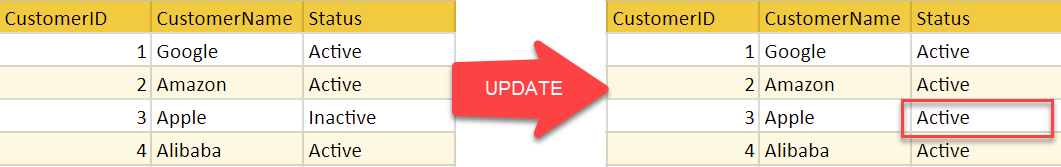
Come si può notare nella tabella delle relazioni sottostante, il cliente 'Apple' è stato aggiornato da Inattivo ad Attivo.
Elimina Operaproduzione
Per specificare la cancellazione, una condizione sugli attributi della relazione seleziona la tupla da cancellare.

Nell'esempio precedente, il cliente "Apple" viene eliminato dalla tabella.
L'operazione di eliminazione potrebbe violare l'integrità referenziale se la tupla che viene eliminata è referenziata da chiavi esterne di altre tuple nella stessa banca dati.
Seleziona Operaproduzione

Nell'esempio precedente, CustomerName “Amazon" è selezionato.
Modello relazionale vs. modelli gerarchici e di rete
Il modello relazionale ha sostituito due approcci precedenti, e il contrasto tra di essi spiega perché sia diventato dominante. La tabella seguente mette a confronto i tre modelli.
| Aspetto | Modello relazionale | Modello gerarchico | Modello di rete |
|---|---|---|---|
| Structure | Tabelle (relazioni) | Albero, dal genitore al figlio | Grafico da molti a molti |
| Accesso ai dati | Dichiarativo, per valore | Navigazione, tramite percorso | Navigazione tramite puntatore |
| Relazioni | Chiavi esterne | legami genitore-figlio | Insiemi e puntatori |
| Linguaggio di interrogazione | SQL | Codice procedurale | Codice procedurale |
| Flessibilità | Alto | Basso | Medio |
Poiché il modello relazionale gestisce i dati per valore piuttosto che tramite la navigazione di collegamenti fisici, un linguaggio di alto livello come SQL è possibile esprimere una query senza sapere come sono memorizzati i dati.
Migliori pratiche per la creazione di un modello relazionale
- I dati devono essere rappresentati come una raccolta di relazioni.
- Ciascuna relazione deve essere rappresentata chiaramente nella tabella.
- Le righe devono contenere dati relativi alle istanze di un'entità.
- Le colonne devono contenere dati relativi agli attributi dell'entità.
- Le celle della tabella devono contenere un singolo valore.
- A ciascuna colonna deve essere assegnato un nome univoco.
- Non possono esserci due righe identiche.
- I valori di un attributo devono provenire dallo stesso dominio.
Vantaggi del modello di database relazionale
- Semplicità: Un modello di dati relazionale in un DBMS è più semplice dei modelli gerarchico e di rete.
- Indipendenza strutturale: Il database relazionale si occupa esclusivamente dei dati e non della struttura, il che può migliorare le prestazioni del modello.
- Facile da usare: Il modello relazionale è facile da usare, poiché le tabelle composte da righe e colonne sono naturali e semplici da comprendere.
- Funzionalità di interrogazione: Ciò consente a un linguaggio di interrogazione di alto livello come SQL di evitare una navigazione complessa all'interno del database.
- Indipendenza dei dati: La struttura di un database relazionale può essere modificata senza dover cambiare alcuna applicazione.
- Scalabile: Per quanto riguarda il numero di record o righe e il numero di campi, un database può essere ampliato per migliorarne l'usabilità.
Svantaggi del modello relazionale
- Pochi database relazionali hanno limiti alla lunghezza dei campi, che non possono essere superati.
- I database relazionali possono talvolta diventare complessi man mano che la quantità di dati aumenta e le relazioni tra i dati si fanno più intricate.
- I sistemi di database relazionali complessi possono portare alla creazione di database isolati, in cui le informazioni non possono essere condivise tra un sistema e l'altro.
