
Tutorial su NoSQL: Tipi di database NoSQL ed esempio
 Stefano Twain
⚡ Riepilogo intelligente
NoSQL è un sistema di gestione di database non relazionale che non richiede uno schema fisso, evita le join e si adatta facilmente alle diverse esigenze. Questa risorsa spiega cos'è NoSQL, perché esiste, la sua storia, le sue caratteristiche, i quattro tipi di database, il teorema CAP, la consistenza finale, i suoi vantaggi e svantaggi.
Cos'è NoSQL?
Database NoSQL è un sistema di gestione dati non relazionale che non richiede uno schema fisso. Evita le join ed è facile da scalare. Lo scopo principale dell'utilizzo di un database NoSQL è per archivi dati distribuiti con enormi esigenze di archiviazione dati. NoSQL viene utilizzato per big data e applicazioni web in tempo reale. Ad esempio, aziende come Twitter, Facebook e Google raccolgono terabyte di dati degli utenti ogni singolo giorno.
Database NoSQL NoSQL sta per "Not Only SQL" o "Not SQL". Sebbene un termine migliore sarebbe "NoREL", NoSQL ha preso piede. Carl Strozzi ha introdotto il concetto di NoSQL nel 1998.
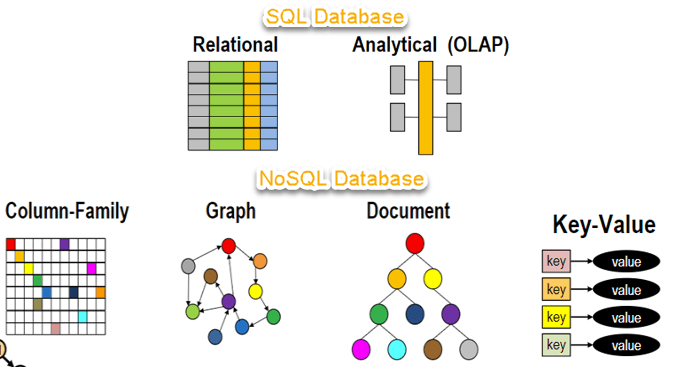
I tradizionali RDBMS utilizzano la sintassi SQL per archiviare e recuperare i dati al fine di ricavarne informazioni utili. Al contrario, un sistema di database NoSQL comprende un'ampia gamma di tecnologie di database in grado di archiviare dati strutturati, semi-strutturati, non strutturati e polimorfici. In questo tutorial sui database NoSQL, esamineremo un diagramma per comprendere meglio il concetto di NoSQL:
Perché NoSQL?
Il concetto di database NoSQL è diventato popolare tra i giganti di Internet come Google, Facebook, Amazon, ecc. che trattano enormi volumi di dati. Il tempo di risposta del sistema diventa lento quando si utilizza RDBMS per enormi volumi di dati.
Per risolvere questo problema, potremmo “scalare” i nostri sistemi aggiornando l’hardware esistente. Questo processo è costoso.
L'alternativa a questo problema è distribuire il carico del database su più host ogni volta che il carico aumenta. Questo metodo è noto come "scaling out".

I database NoSQL non sono relazionali, quindi si adattano meglio alle esigenze di scalabilità rispetto ai database relazionali, poiché sono progettati pensando alle applicazioni web.
Breve storia dei database NoSQL
- 1998 – Carlo Strozzi utilizza il termine NoSQL per il suo database relazionale leggero e open-source.
- 2000 – Database a grafo NeoÈ stato lanciato 4j.
- 2004 - Google BigTable è stato lanciato.
- 2005 - CouchDB è lanciato.
- 2007 – Il documento di ricerca su Amazon Dynamo è stato rilasciato.
- 2008 – Facebook rende open source il Cassandra progetto.
- 2009 – Il termine NoSQL è stato reintrodotto.
Funzionalità di NoSQL
Non relazionale
- I database NoSQL non seguono mai il modello relazionale.
- Non fornire mai tabelle con record a colonne fisse e piatte.
- Lavorare con aggregati autosufficienti o BLOB.
- Non è necessaria la mappa oggetto-relazionaleping e normalizzazione dei dati.
- Nessuna funzionalità complessa come linguaggi di interrogazione, pianificatori di query, join di integrità referenziale o ACID.
Senza schemi
- I database NoSQL sono privi di schema oppure hanno schemi flessibili.
- Non è richiesta alcuna definizione dello schema dei dati.
- Offrire strutture di dati eterogenee nello stesso dominio.

API semplice
- Offre interfacce intuitive per l'archiviazione e l'interrogazione dei dati.
- Le API consentono metodi di manipolazione e selezione dei dati di basso livello.
- Protocolli basati su testo utilizzati principalmente con HTTP REST e JSON.
- Nella maggior parte dei casi non veniva utilizzato alcun linguaggio di query NoSQL basato su standard.
- Database abilitati al web che funzionano come servizi accessibili da Internet.
distribuito
- È possibile eseguire più database NoSQL in modo distribuito.
- Offre funzionalità di scalabilità automatica e di failover.
- Spesso il concetto ACID viene sacrificato in favore della scalabilità e della produttività.
- Nella maggior parte dei casi non si verifica replica sincrona tra nodi distribuiti; si utilizzano replica multi-master asincrona, peer-to-peer e replica HDFS.
- Garantisce solo la coerenza finale.
- Architettura shared-nothing. Ciò consente una minore coordinazione e una maggiore distribuzione.

Tipi di database NoSQL
Database NoSQL I database si suddividono principalmente in quattro tipologie: coppie chiave-valore, orientati alle colonne, basati su grafi e orientati ai documenti. Ogni categoria presenta caratteristiche e limitazioni specifiche. Nessuno dei database sopra menzionati è in grado di risolvere tutti i problemi in modo ottimale. Gli utenti dovrebbero scegliere il database più adatto alle proprie esigenze.
Tipi di database NoSQL:
- Basato su coppie di valori-chiave
- Grafico orientato alle colonne
- Basato su grafici
- Orientato ai documenti

Basato su coppia chiave-valore
I dati vengono memorizzati in coppie chiave/valore. Sono progettati per gestire grandi quantità di dati e carichi di lavoro elevati. I database di archiviazione a coppie chiave-valore memorizzano i dati come una tabella hash in cui ogni chiave è univoca e il valore può essere un JSON, un BLOB (Binary Large Object), una stringa, ecc.
Ad esempio, una coppia chiave-valore può contenere una chiave come "Sito Web" associata a un valore come "Guru99 ".

È uno degli esempi più basilari di database NoSQL. Questo tipo di database NoSQL viene utilizzato come raccolta, dizionari, array associativi, ecc. I database chiave-valore aiutano lo sviluppatore a memorizzare dati senza schema. Funzionano al meglio per i negozi.ping Contenuto del carrello.
Redis, Dynamo e Riak sono alcuni esempi NoSQL di database di archiviazione chiave-valore. Sono tutti basati su Amazonil documento Dynamo.
Basato su colonne
I database orientati alle colonne lavorano sulle colonne e sono basati sul documento BigTable di GoogleOgni colonna viene trattata separatamente. I valori dei database a colonna singola vengono memorizzati in modo contiguo.

Offrono prestazioni elevate nelle query di aggregazione come SOMMA, CONTA, AVG, MIN, ecc., poiché i dati sono facilmente disponibili in una colonna. I database NoSQL basati su colonne sono ampiamente utilizzati per gestire i data warehouse, business intelligence, CRM e cataloghi delle schede bibliotecarie.
HBase, CassandraHypertable e sono esempi di query NoSQL per database basati su colonne.
Orientato ai documenti
I database NoSQL orientati ai documenti memorizzano e recuperano i dati come coppie chiave-valore, ma la parte relativa al valore viene memorizzata come un documento. Il documento è memorizzato in formato JSON o XML. Il valore viene interpretato dal database e può essere interrogato.

In questo diagramma a sinistra, potete vedere righe e colonne, mentre a destra abbiamo un database a documenti con una struttura simile a JSON. Ora, per un database relazionale, è necessario conoscere il numero di colonne e così via. Tuttavia, per un database a documenti, si ha un archivio dati come un oggetto JSON. Non è necessario definirlo, il che lo rende flessibile.
Questo tipo di documento è utilizzato principalmente per sistemi CMS, piattaforme di blogging, analisi in tempo reale e applicazioni di e-commerce. Non è indicato per transazioni complesse che richiedono molteplici operazioni o query su strutture aggregate variabili.
Amazon DB semplice, CouchDB, MongoDB, Riak e Lotus Notes sono popolari programmi orientati ai documenti Sistemi DBMS.
Basato su grafici
Un database a grafo memorizza sia le entità che le relazioni tra di esse. Ogni entità è rappresentata da un nodo, mentre le relazioni sono rappresentate da un arco. Un arco indica una relazione tra due nodi. Ogni nodo e ogni arco possiede un identificatore univoco.

Rispetto a un database relazionale, in cui le tabelle sono collegate in modo lasco, un database a grafo è di natura multi-relazionale. L'attraversamento delle relazioni è rapido, poiché queste sono già memorizzate nel database e non è necessario calcolarle. I database a grafo sono utilizzati principalmente per i social network, la logistica e i dati spaziali.
Neo4J, Grafico infinito, OrientDBe FlockDB sono alcuni popolari database basati su grafi.
Strumenti del meccanismo di query per NoSQL
Il meccanismo di recupero dati più comune è il recupero di un valore basato su REST, tramite la sua chiave/ID e una risorsa GET.
I database di archiviazione di documenti offrono query più complesse, poiché comprendono il valore in una coppia chiave-valore. Ad esempio, CouchDB Consente di definire viste con MapReduce.
Cos'è il teorema della PAC?
Il teorema CAP, noto anche come teorema di Brewer, afferma che è impossibile per un archivio dati distribuito offrire più di due garanzie su tre:
- Consistenza
- Disponibilità
- Tolleranza partizione
Consistenza: I dati dovrebbero rimanere coerenti anche dopo l'esecuzione di un'operazione. Ciò significa che una volta scritti i dati, qualsiasi futura richiesta di lettura dovrebbe contenere tali dati. Ad esempio, dopo aver aggiornato lo stato dell'ordine, tutti i clienti dovrebbero essere in grado di vedere gli stessi dati.
Disponibilità: Il database dovrebbe essere sempre disponibile e reattivo. Non dovrebbe avere tempi di inattività.
Tolleranza della partizione: Tolleranza alla partizione significa che il sistema deve continuare a funzionare anche se la comunicazione tra i server non è stabile. Ad esempio, i server possono essere suddivisi in più gruppi che potrebbero non comunicare tra loro. In questo caso, se una parte del database non è disponibile, le altre parti rimangono sempre inalterate.
Eventuale coerenza
Il termine "coerenza finale" indica la necessità di avere copie dei dati su più macchine per ottenere elevata disponibilità e scalabilità. Pertanto, le modifiche apportate a qualsiasi elemento di dati su una macchina devono essere propagate alle altre repliche.
La replica dei dati potrebbe non essere istantanea, poiché alcune copie verranno aggiornate immediatamente, mentre altre in un secondo momento. Queste copie potrebbero inizialmente non essere coerenti tra loro, ma col tempo diventeranno coerenti. Da qui il nome di coerenza finale.
BASE: Basiatiche Adisponibile, Sspesso stato, Eeventuale consistenza
- Fondamentalmente disponibile significa che il database è disponibile in ogni momento, secondo il teorema CAP.
- Lo stato soft significa che, anche in assenza di input, lo stato del sistema può cambiare.
- La coerenza finale significa che il sistema diventerà coerente nel tempo.

Vantaggi di NoSQL
- Può essere utilizzato come fonte di dati primaria o analitica.
- Capacità di gestione dei big data.
- Nessun singolo punto di guasto.
- Facile da riprodurre.
- Non è necessario un livello di caching separato.
- Fornisce prestazioni veloci e scalabilità orizzontale.
- È in grado di gestire dati strutturati, semi-strutturati e non strutturati con la stessa efficacia.
- Programmazione orientata agli oggetti, facile da usare e flessibile.
- I database NoSQL non necessitano di un server dedicato ad alte prestazioni.
- Supporto per i principali linguaggi di programmazione e piattaforme.
- Più semplice da implementare rispetto all'utilizzo di un RDBMS.
- Può fungere da fonte di dati primaria per le applicazioni online.
- Gestisce i big data, ovvero la velocità, la varietà, il volume e la complessità dei dati.
- Eccelle nella gestione di database distribuiti e in operazioni multi-data center.
- Elimina la necessità di un livello di caching specifico per l'archiviazione dei dati.
- Offre una progettazione dello schema flessibile che può essere facilmente modificata senza tempi di inattività o interruzioni del servizio.
Svantaggi di NoSQL
- Nessuna regola di standardizzazione.
- Capacità di interrogazione limitate.
- RDBMS I database e gli strumenti sono relativamente maturi.
- Non offre alcuna funzionalità di database tradizionale, come la coerenza quando vengono eseguite più transazioni contemporaneamente.
- Quando il volume dei dati aumenta, diventa difficile mantenere valori univoci poiché le chiavi diventano complesse.
- Non funziona altrettanto bene con i dati relazionali.
- La curva di apprendimento è ripida per i nuovi sviluppatori.
- Le opzioni open source non sono molto popolari tra le aziende.
