
Python File XML: come leggere, scrivere e analizzare
 Anna Blake
⚡ Riepilogo intelligente
Python L'elaborazione XML consente di leggere, scrivere e analizzare documenti XML utilizzando i moduli integrati minidom ed ElementTree. La classe minidom carica un file in memoria come un DOM, mentre ElementTree offre un'elaborazione più veloce e più PythonAPI dell'albero ic.
Le sezioni seguenti trattano l'analisi, la scrittura e la lettura di file XML in Python.
Cos'è l'XML?
XML sta per eXtensible Markup Language. È stato progettato per archiviare e trasportare quantità di dati piccole e medie ed è ampiamente utilizzato per condividere informazioni strutturate.
Python consente di analizzare e modificare documenti XML. Per analizzare un documento XML, è necessario avere l'intero documento XML in memoria. In questo tutorial vedremo come possiamo utilizzare la classe minidom XML in Python per caricare e analizzare file XML.
Come analizzare XML utilizzando minidom
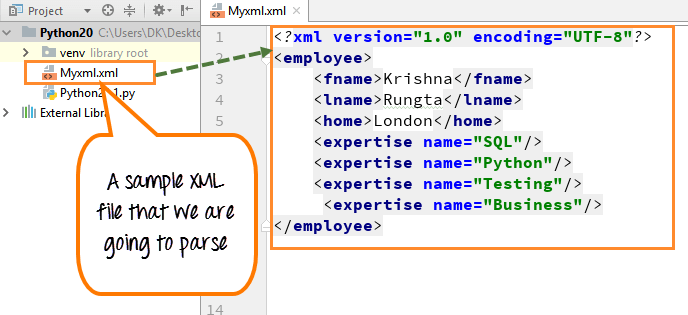
Abbiamo creato un file XML di esempio che analizzeremo.
Passaggio 1) Creare un file XML di esempio
All'interno del file possiamo vedere il nome, il cognome, l'abitazione e l'area di competenza (SQL, Python(Test e Business).
Passaggio 2) Utilizzare la funzione di analisi per caricare e analizzare il file XML
Una volta analizzato il documento, stamperemo il "nome del nodo" della radice del documento e il "nome del tag del primo figlio". Il nome del tag e il nome del nodo sono proprietà standard del file XML.
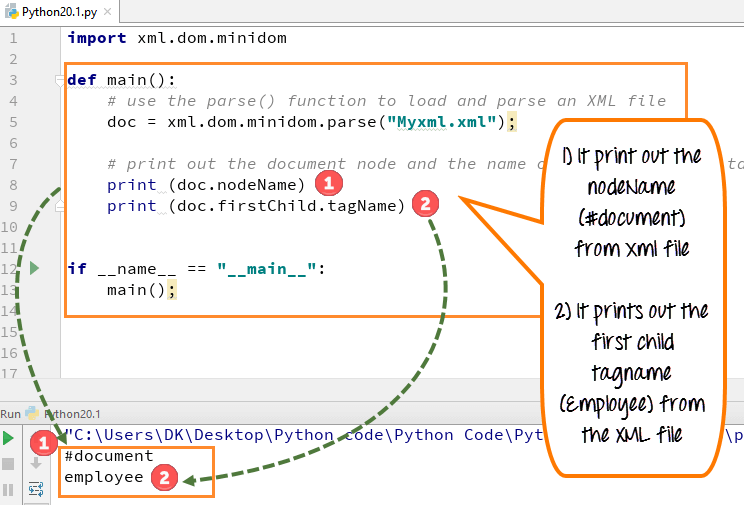
- Importa il modulo xml.dom.minidom e dichiara il file da analizzare (myxml.xml).
- Questo file contiene alcune informazioni di base su un dipendente come nome, cognome, casa, competenza, ecc.
- Usiamo la funzione di analisi sul minidom XML per caricare e analizzare il file XML
- Abbiamo una variabile doc, e doc ottiene il risultato della funzione parse
- Vogliamo stampare il nome del nodo e il nome del tag figlio dal file, quindi lo dichiariamo nella funzione print
- Esegui il codice: stampa il nome del nodo (#document) dal file XML e il primo nome tag figlio (dipendente) dal file XML
Note:: Nodename e child tagname sono i nomi o le proprietà standard di un DOM XML.
Passaggio 3) Richiamare l'elenco dei tag XML dal documento XML e stamparlo
Successivamente, possiamo anche richiamare l'elenco dei tag XML dal documento XML e stamparlo. Qui abbiamo stampato l'insieme di competenze come SQL, Python, Collaudo e Affari.

- Dichiarare la variabile competenza, dalla quale andremo a estrarlatracnon tutti i nomi di competenza che il dipendente ha
- Utilizza la funzione standard dom chiamata “getElementsByTagName”
- Questo otterrà tutti gli elementi chiamati abilità
- Dichiara un ciclo su ciascuno dei tag skill
- Esegui il codice: ti fornirà un elenco di quattro competenze
Come scrivere un nodo XML
Possiamo creare un nuovo attributo utilizzando la funzione "createElement" e quindi aggiungere questo nuovo attributo o tag ai tag XML esistenti. Abbiamo aggiunto un nuovo tag "BigData" nel nostro file XML.
- È necessario scrivere del codice per aggiungere il nuovo attributo (BigData) al tag XML esistente.
- Quindi, è necessario stampare il tag XML con il nuovo attributo aggiunto al tag XML esistente.
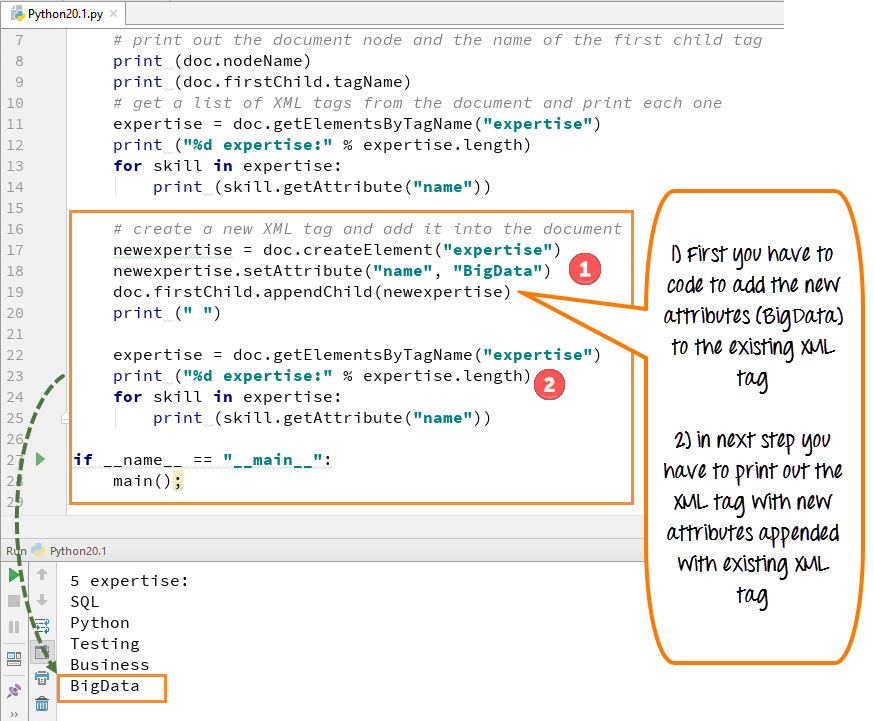
- Per aggiungere un nuovo tag XML e inserirlo nel documento, utilizziamo il codice "doc.createElement".
- Questo codice creerà un nuovo tag di competenza per il nostro nuovo attributo "BigData".
- Aggiungi questo tag skill al primo elemento figlio del documento (dipendente).
- Esegui il codice: il nuovo tag "BigData" apparirà insieme agli altri termini dell'elenco.
Esempio di parser XML
Python 2 Esempio
import xml.dom.minidom

def main():
# use the parse() function to load and parse an XML file
   doc = xml.dom.minidom.parse("Myxml.xml");

# print out the document node and the name of the first child tag
   print doc.nodeName
   print doc.firstChild.tagName

# get a list of XML tags from the document and print each one
   expertise = doc.getElementsByTagName("expertise")
   print "%d expertise:" % expertise.length
   for skill in expertise:
     print skill.getAttribute("name")

#Write a new XML tag and add it into the document
   newexpertise = doc.createElement("expertise")
   newexpertise.setAttribute("name", "BigData")
   doc.firstChild.appendChild(newexpertise)
   print " "

   expertise = doc.getElementsByTagName("expertise")
   print "%d expertise:" % expertise.length
   for skill in expertise:
     print skill.getAttribute("name")

if name == "__main__":
  main();
Python 3 Esempio
import xml.dom.minidom

def main():
    # use the parse() function to load and parse an XML file
    doc = xml.dom.minidom.parse("Myxml.xml");

    # print out the document node and the name of the first child tag
    print (doc.nodeName)
    print (doc.firstChild.tagName)
    # get a list of XML tags from the document and print each one
    expertise = doc.getElementsByTagName("expertise")
    print ("%d expertise:" % expertise.length)
    for skill in expertise:
        print (skill.getAttribute("name"))

    # Write a new XML tag and add it into the document
    newexpertise = doc.createElement("expertise")
    newexpertise.setAttribute("name", "BigData")
    doc.firstChild.appendChild(newexpertise)
    print (" ")

    expertise = doc.getElementsByTagName("expertise")
    print ("%d expertise:" % expertise.length)
    for skill in expertise:
        print (skill.getAttribute("name"))

if __name__ == "__main__":
    main();
Come analizzare XML utilizzando ElementTree
ElementTree è un'API per la manipolazione di file XML. ElementTree è un modo semplice per elaborare file XML.
Stiamo utilizzando il seguente documento XML come dati di esempio:
<data>
   <items>
      <item name="expertise1">SQL</item>
      <item name="expertise2">Python</item>
   </items>
</data>
Lettura XML utilizzando ElementTree:
Per prima cosa dobbiamo importare il modulo xml.etree.ElementTree.
import xml.etree.ElementTree as ET
Ora recuperiamo l'elemento radice:
root = tree.getroot()
Di seguito è riportato il codice completo per la lettura dei dati XML sopra riportati:
import xml.etree.ElementTree as ET
tree = ET.parse('items.xml')
root = tree.getroot()

# all items data
print('Expertise Data:')

for elem in root:
   for subelem in elem:
      print(subelem.text)
Produzione:
Expertise Data:
SQL
Python
