
Come installare HBase su Ubuntu: Guida passo passo
 Team editoriale
⚡ Riepilogo intelligente
Installazione di HBase su Ubuntu Il programma funziona in tre modalità: standalone, pseudo-distribuita e completamente distribuita, e illustra come scaricare il file tarball della release, modificare hbase-env.sh e hbase-site.xml, avviare i daemon e risolvere i comuni errori di avvio.
Apache HBase è un sistema distribuito, database orientato alle colonne che funziona sopra l'Hadoop Distributed File System (HDFS). Prima di iniziare, assicurati di avere un sistema supportato Java Il runtime è installato e JAVA_HOME è impostato; anche le modalità pseudo-distribuita e completamente distribuita richiedono un runtime funzionante. Hadoop installazione.
Modalità di installazione di Apache HBase
Apache HBase può essere installato in tre modalità. Le caratteristiche di queste modalità sono menzionate di seguito.
1) Installazione in modalità standalone (nessuna dipendenza dal sistema Hadoop)
- Questa è la modalità predefinita di HBase.
- Viene eseguito sul file system locale.
- Non usa Hadoop HDFS.
- Solo il demone HMaster può essere eseguito.
- Sconsigliato per un ambiente di produzione.
- Funziona in una singola JVM.
2) Installazione in modalità pseudo-distribuita (sistema Hadoop a nodo singolo + installazione HBase)
- Funziona Hadoop HDFS.
- Tutti i daemon vengono eseguiti su un singolo nodo.
- Consigliato per un ambiente di produzione.
3) Installazione in modalità completamente distribuita (ambiente Hadoop multinodo + installazione di HBase)
- Funziona Hadoop HDFS.
- Tutti i daemon vengono eseguiti su tutti i nodi presenti nel cluster.
- Altamente raccomandato per un ambiente di produzione.
Per l'installazione di Hadoop, fare riferimento a questo Guida all'installazione di Hadoop.
Gli screenshot seguenti utilizzano HBase 1.1.2. Le versioni stabili attuali sono le serie HBase 2.5.x e 2.6.x (Java 8 o 11), ma i passaggi di installazione e i file di configurazione rimangono sostanzialmente gli stessi.
Come scaricare la versione stabile del file tar HBase
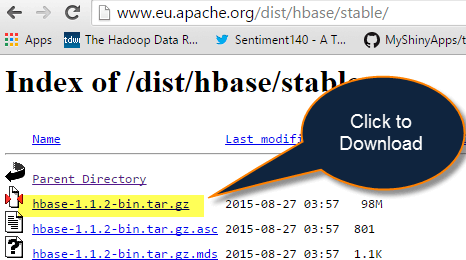
Passaggio 1) Vai al Pagina ufficiale per il download di Apache HBase per scaricare HBase. Si aprirà la pagina di download come mostrato di seguito.

Passaggio 2) Selezionare la versione stabile come mostrato di seguito, ovvero la versione HBase 1.1.2.

Passaggio 3) Fare clic su hbase-1.1.2-bin.tar.gz. Verrà scaricato il file tar. Copiare il file tar in una posizione di installazione.
Come installare HBase in Ubuntu con modalità autonoma
Ecco la procedura passo passo per l'installazione della modalità standalone di HBase in Ubuntu:
Passaggio 1) Eseguire il comando seguente. Posizionare hbase-1.1.2-bin.tar.gz in /home/hduser.
Passaggio 2) Decomprimi il file eseguendo il comando $tar -xvf hbase-1.1.2-bin.tar.gz. Questo decomprimerà il contenuto e creerà la cartella hbase-1.1.2 nella posizione /home/hduser.
Passaggio 3) Aprire hbase-env.sh come mostrato di seguito e specificare il percorso JAVA_HOME nel campo location, come illustrato di seguito.

Passaggio 4) Aprire il file ~/.bashrc e specificare il percorso HBASE_HOME come mostrato di seguito.
export HBASE_HOME=/home/hduser/hbase-1.1.1
export PATH= $PATH:$HBASE_HOME/bin
Il file ~/.bashrc aggiornato con la voce HBASE_HOME è mostrato di seguito.

Passaggio 5) Aggiungere le proprietà al file. Aprire hbase-site.xml e inserire le seguenti proprietà al suo interno.
hduser@ubuntu$ gedit hbase-site.xml (codice come di seguito)
<property>

<name>hbase.rootdir</name>

<value>file:///home/hduser/HBASE/hbase</value>

</property>

<property>

<name>hbase.zookeeper.property.dataDir</name>

<value>/home/hduser/HBASE/zookeeper</value>

</property>
Il file hbase-site.xml aperto in gedit è mostrato sotto.
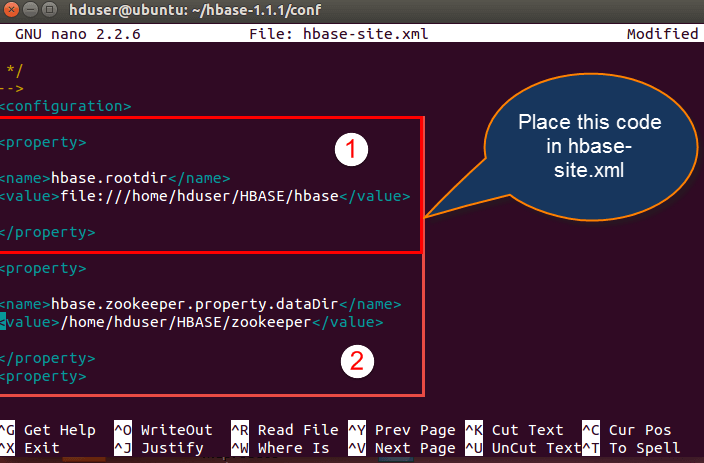
Qui inseriamo due proprietà:
- Uno per la directory radice di HBase e
- Il secondo per la directory dei dati che corrisponde a Custode dello zoo.
Tutte le attività di HMaster e ZooKeeper puntano a questo file hbase-site.xml.
Passaggio 6) Inserire gli indirizzi IP. Aprire il file hosts presente nella directory /etc e inserire gli indirizzi IP come mostrato di seguito.

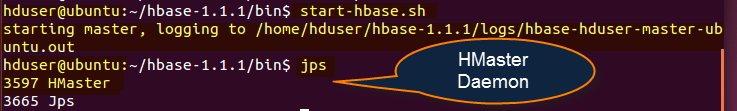
Passaggio 7) Ora esegui start-hbase.sh nella posizione hbase-1.1.1/bin come mostrato di seguito. Puoi quindi verificare con il comando jps se HMaster è in esecuzione o meno.
Passaggio 8) Avviare la shell HBase. La shell HBase può essere avviata utilizzando shell hbase eseguendo il comando, entrerà in modalità shell interattiva, come mostrato nello screenshot qui sotto. Una volta entrata in modalità shell, possiamo eseguire tutti i tipi di comandi.

La modalità autonoma non richiede l'avvio dei demoni Hadoop. HBase può essere eseguito in modo indipendente.
Modalità di installazione pseudo-distribuita HBase
Questo è un altro metodo per l'installazione di Apache HBase, noto come modalità di installazione pseudo-distribuita. Di seguito sono riportati i passaggi per installare HBase tramite la modalità pseudo-distribuita.
Passaggio 1) Posizionare hbase-1.1.2-bin.tar.gz nella directory /home/hduser.
Passaggio 2) Decomprimi il file eseguendo il comando $tar -xvf hbase-1.1.2-bin.tar.gz. Questo decomprimerà il contenuto e creerà la cartella hbase-1.1.2 nella posizione /home/hduser.
Passaggio 3) Aprire hbase-env.sh come mostrato di seguito, specificare il percorso JAVA_HOME e il percorso dei Region Server nel campo location ed esportare il comando come mostrato di seguito.

Passaggio 4) In questo passaggio, apriremo il file ~/.bashrc e specificheremo il percorso HBASE_HOME come mostrato nello screenshot seguente.

Passaggio 5) Aprire hbase-site.xml e specificare le proprietà seguenti nel file (codice come di seguito).
<property>

<name>hbase.rootdir</name>

<value>hdfs://localhost:9000/hbase</value>

</property>

<property>

<name>hbase.cluster.distributed</name>

<value>true</value>

</property>

<property>

<name>hbase.zookeeper.quorum</name>

<value>localhost</value>

</property>

<property>

<name>dfs.replication</name>

<value>1</value>

</property>

<property>

<name>hbase.zookeeper.property.clientPort</name>

<value>2181</value>

</property>

<property>

<name>hbase.zookeeper.property.dataDir</name>

<value>/home/hduser/hbase/zookeeper</value>

</property>
Il file hbase-site.xml con le proprietà pseudo-distribuite è mostrato di seguito.
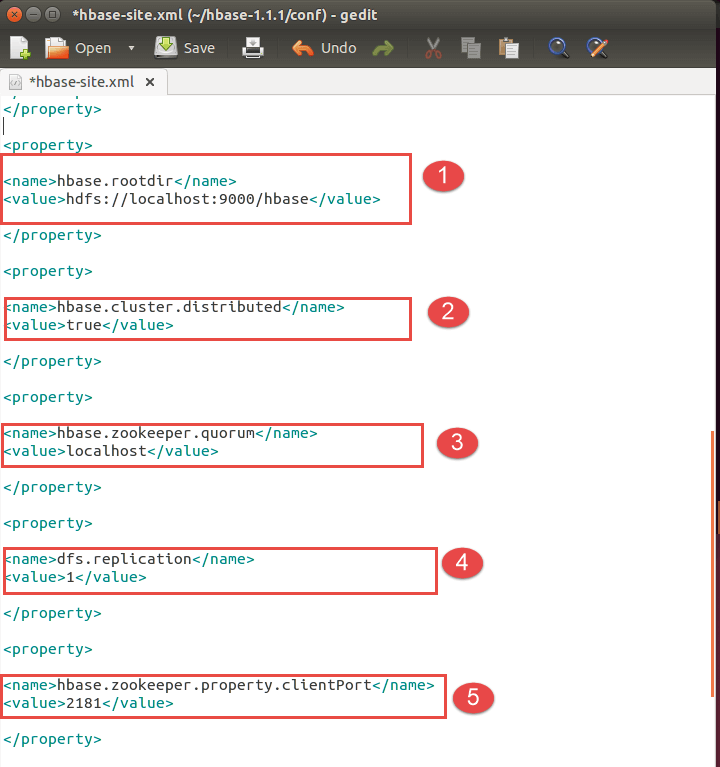
La restante configurazione di ZooKeeper è mostrata di seguito.

Ogni proprietà presente nel file svolge un ruolo specifico:
- Impostazione della directory radice di HBase nella proprietà hbase.rootdir.
- Per una configurazione distribuita, hbase.cluster.distributed deve essere impostato su true.
- La proprietà del quorum ZooKeeper dovrebbe essere configurata qui.
- La replicazione viene configurata nella proprietà dfs.replication. Per impostazione predefinita, il valore di replicazione è 1. In modalità completamente distribuita, sono presenti più nodi dati, quindi è possibile aumentare la replicazione impostando un valore maggiore di 1 nella proprietà dfs.replication.
- La porta client deve essere specificata nella proprietà hbase.zookeeper.property.clientPort.
- La directory dei dati di ZooKeeper può essere specificata nella proprietà hbase.zookeeper.property.dataDir.
Passaggio 6) Avviare prima i daemon di Hadoop e successivamente i daemon di HBase come mostrato di seguito. Per prima cosa è necessario avviare i daemon di Hadoop utilizzando il comando ./start-all.sh come mostrato di seguito.

Dopodiché, avviare i daemon di HBase con hbase-start.sh, come mostrato di seguito.

Ora controlla i processi in esecuzione con il comando jps, come mostrato di seguito.

Installazione in modalità completamente distribuita HBase
La modalità completamente distribuita estende la configurazione pseudo-distribuita a un cluster reale.
- Questa configurazione funziona in modalità cluster Hadoop, dove più nodi vengono generati e sono in esecuzione all'interno del cluster.
- L'installazione è identica alla modalità pseudo-distribuita; l'unica differenza è che verrà distribuita su più nodi.
- I file di configurazione menzionati in hbase-site.xml e hbase-env.sh sono gli stessi menzionati nella modalità pseudo.
In modalità completamente distribuita, assicurarsi che la versione di Hadoop sul cluster corrisponda alle librerie Hadoop incluse in HBase, in modo che i daemon comunichino correttamente.
Risoluzione dei problemi di installazione di HBase
1) Descrizione del problema: Il server master si inizializza, ma i server di regione non si inizializzano.
La comunicazione tra il Master e i server di regione avviene tramite i rispettivi indirizzi IP. Il Master è in ascolto dei server di regione in esecuzione o che hanno l'indirizzo IP 127.0.0.1. L'indirizzo IP 127.0.0.1 corrisponde all'host locale e viene risolto nell'host locale del server Master.
causa:
Nella comunicazione bidirezionale tra i server di regione e il server Master, il server di regione informa continuamente il server Master che il suo indirizzo IP è 127.0.0.1.
Soluzione:
- Rimuovere il nodo del nome del server master dalla voce host locale presente nel file hosts.
- Percorso del file host: /etc/hosts.
Cosa cambiare:
Apri il file /etc/hosts e vai a questa posizione.
127.0.0.1 fully.qualified.regionservernameregionservername localhost.localdomain localhost
: : 1              localhost3.localdomain3 localdomain3
Modifica la configurazione di cui sopra come segue (rimuovi il nome del server di regione come evidenziato sopra).
127.0.0.1    localhost.localdomainlocalhost
: : 1 localhost3.localdomain3 localdomain3
2) Descrizione del problema: Impossibile trovare il mio indirizzo: XYZ nell'elenco dei server di quorum di ZooKeeper
causa:
- Il server ZooKeeper non è riuscito ad avviarsi e ha generato un errore del tipo .xyz nel nome del server.
- HBase tenta di avviare un server ZooKeeper su una macchina, ma allo stesso tempo la macchina non riesce a trovarsi nella configurazione di quorum presente nel file hbase.zookeeper.quorum.
Soluzione:
- Sostituire il nome host con il nome host presente nel messaggio di errore.
- Se disponi di un server DNS, puoi impostare le seguenti configurazioni nel file hbase-site.xml: hbase.zookeeper.dns.interface e hbase.zookeeper.dns.nameserver.
3) Descrizione del problema: Creazione di una directory radice per HBase tramite Hadoop DFS
- Il Master afferma che è necessario eseguire lo script di migrazione di HBase.
- Eseguendo tale comando, lo script di migrazione di HBase risponde che non ci sono file nella directory principale.
causa:
- È stata creata una nuova directory per HBase utilizzando il file system distribuito Hadoop.
- In questo caso HBase prevede due possibilità:
1) La directory principale non esiste.
2) Prima era stata inizializzata un'istanza di HBase già in esecuzione.
Soluzione:
- Verificare che la directory radice di HBase non esista attualmente o che sia stata inizializzata da una precedente esecuzione dell'istanza di HBase.
- Come parte della soluzione, segui questi passaggi.
Passaggio 1) Utilizzare Hadoop dfs per eliminare la directory radice di HBase.
Passaggio 2) HBase crea e inizializza la directory autonomamente.
4) Descrizione del problema: Eventi di scadenza della sessione di ZooKeeper
causa:
- I server HMaster o HRegion si arrestano generando delle eccezioni.
- Esaminando i log, è possibile individuare le eccezioni effettivamente generate.
Di seguito viene mostrata l'eccezione generata a causa di un evento di scadenza di ZooKeeper. Gli eventi evidenziati sono alcune delle eccezioni che si sono verificate nel file di log.
Il codice dei file di log è visualizzato di seguito:
WARN org.apache.zookeeper.ClientCnxn: Exception
closing session 0x278bd16a96000f to sun.nio.ch.SelectionKeyImpl@355811ec

java.io.IOException: TIMED OUT
at org.apache.zookeeper.ClientCnxn$SendThread.run(ClientCnxn.java:906)
WARN org.apache.hadoop.hbase.util.Sleeper: We slept 79410ms, ten times longer than scheduled: 5000
INFO org.apache.zookeeper.ClientCnxn: Attempting connection to server hostname/IP:PORT
INFO org.apache.zookeeper.ClientCnxn: Priming connection to java.nio.channels.SocketChannel[connected local=/IP:PORT remote=hostname/IP:PORT]
INFO org.apache.zookeeper.ClientCnxn: Server connection successful
WARN org.apache.zookeeper.ClientCnxn: Exception closing session 0x278bd16a96000d to sun.nio.ch.SelectionKeyImpl@3544d65e

java.io.IOException: Session Expired
at org.apache.zookeeper.ClientCnxn$SendThread.readConnectResult(ClientCnxn.java:589)
at org.apache.zookeeper.ClientCnxn$SendThread.doIO(ClientCnxn.java:709)
at org.apache.zookeeper.ClientCnxn$SendThread.run(ClientCnxn.java:945)
ERROR org.apache.hadoop.hbase.regionserver.HRegionServer: ZooKeeper session expired
Soluzione:
- La dimensione predefinita della RAM è di 1 GB. Per importazioni di lunga durata, si consiglia di mantenere una capacità di RAM superiore a 1 GB.
- Aumenta il timeout della sessione per ZooKeeper.
- Per aumentare il timeout della sessione di ZooKeeper, modificare la seguente proprietà nel file hbase-site.xml, presente nella cartella hbase/conf.
- Il timeout predefinito della sessione è di 60 secondi. È possibile modificarlo a 120 secondi come indicato di seguito.
<property>
    <name> zookeeper.session.timeout </name>
    <value>1200000</value>
</property>
<property>
    <name> hbase.zookeeper.property.tickTime </name>
    <value>6000</value>
</property>
