
Cos'è la modellazione dimensionale nel data warehouse? Impara i tipi
 Team editoriale
⚡ Riepilogo intelligente
Il modello dimensionale nella progettazione del data warehouse organizza le informazioni in tabelle dei fatti e delle dimensioni, consentendo agli analisti di recuperare e riepilogare rapidamente le misure numeriche, seguendo il metodo Kimball in cinque fasi che identifica il processo aziendale, la granularità, le dimensioni, i fatti e lo schema finale.
Cos'è la modellazione dimensionale?
Modellazione dimensionale (DM) È una tecnica di strutturazione dei dati ottimizzata per l'archiviazione dei dati in un data warehouse. Il suo scopo è quello di ottimizzare il database per un recupero più rapido dei dati. Il concetto è stato sviluppato da Ralph Kimball e si basa su due tipi di tabelle: le tabelle "dei fatti" e le tabelle "delle dimensioni".
Un modello dimensionale in un data warehouse è progettato per leggere, riassumere e analizzare informazioni numeriche come valori, saldi, conteggi e pesi. I modelli relazionali, al contrario, sono ottimizzati per l'aggiunta, l'aggiornamento e la cancellazione di dati in un sistema di elaborazione delle transazioni online in tempo reale.
Ciascuno di questi approcci memorizza i dati in modo diverso e offre vantaggi specifici.
In un modello relazionale, la normalizzazione e i modelli ER riducono la ridondanza dei dati. Un modello dimensionale, invece, organizza i dati in modo che le informazioni siano più facili da recuperare e i report più facili da generare.
Per questo motivo, i modelli dimensionali sono adatti deposito dati sistemi piuttosto che sistemi relazionali ad alta intensità di transazioni. Poiché il modello è alla base del più ampio architettura del data warehouseLe sezioni seguenti ne analizzano gli elementi, le tipologie e le fasi di progettazione.
Elementi di modello dimensionale dei dati
Fatto
I fatti sono le misurazioni o le metriche ricavate da un processo aziendale. In un processo di vendita, ad esempio, il dato relativo alle vendite trimestrali è un fatto: il valore numerico che l'azienda desidera analizzare.
Dimensioni
Una dimensione fornisce il contesto che circonda un evento di un processo aziendale. In termini semplici, le dimensioni forniscono chi, cosa e dove si trova un fatto. Per il fatto "dato di vendita trimestrale", le dimensioni sarebbero:
- Chi – Nomi dei clienti
- Dove – Posizione
- Cosa – Nome del prodotto
In altre parole, una dimensione è una finestra attraverso cui si osservano le informazioni contenute nei fatti.
Attributi
Gli attributi sono le diverse caratteristiche di una dimensione all'interno di un modello di dati dimensionale.
Nella dimensione Posizione, gli attributi possono essere:
- Regione / Stato
- Paese
- Cap
Gli attributi vengono utilizzati per cercare, filtrare e classificare i fatti, e le tabelle delle dimensioni sono il luogo in cui risiedono tali attributi.
Tabella dei fatti
Una tabella dei fatti è la tabella primaria in un modello dimensionale.
Una tabella dei fatti contiene:
- Misurazioni o fatti
- Chiavi esterne alle tabelle dimensionali
Tabella delle dimensioni
Una tabella delle dimensioni contiene le dimensioni di un fatto e si collega alla tabella dei fatti tramite una chiave esterna. Le sue caratteristiche principali sono elencate di seguito:
- Le tabelle delle dimensioni sono tabelle denormalizzate.
- Gli attributi dimensionali costituiscono le colonne della tabella.
- Le dimensioni offrono caratteristiche descrittive dei fatti attraverso i loro attributi.
- Non esiste un limite fisso al numero di dimensioni.
- Una dimensione può contenere una o più relazioni gerarchiche.
Tipi di dimensioni nel data warehouse
La modellazione dimensionale utilizza diversi tipi di dimensioni, ognuna adatta a una particolare esigenza di progettazione. La principale tipi di dimensioni in un data warehouse siamo:
- Dimensione conforme
- Dimensione del bilanciere
- Dimensione rimpicciolita
- Dimensione del gioco di ruolo
- Da dimensione a tabella delle dimensioni
- Dimensione spazzatura
- Dimensione degenerata
- Dimensione scambiabile
- Dimensione del passo
Fasi della modellazione dimensionale
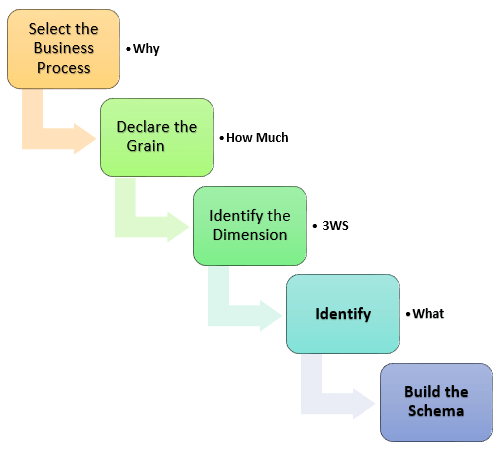
L'accuratezza della modellazione dimensionale è fondamentale per il successo dell'implementazione del data warehouse. La creazione di un modello dimensionale si articola in cinque fasi:
- Identificare il processo aziendale
- Identificare la grana (livello di dettaglio)
- Identificare le dimensioni
- Identificare i fatti
- Costruisci lo schema
Nel complesso, il modello finale dovrebbe descrivere il perché, il quanto, il quando, il dove, il chi e il cosa del processo aziendale.
Passaggio 1) Identificare il processo aziendale
Il primo compito è identificare il processo aziendale che il magazzino dovrebbe coprire — marketing, vendite, risorse umane e così via — in base all'organizzazione analisi dei dati esigenze e qualità dei dati disponibili. Questo è il passaggio più importante, perché un errore in questa fase produce difetti a cascata, difficili da correggere.
Per descrivere il processo aziendale, è possibile utilizzare testo semplice, Business Process Modelling Notation (BPMN) o Unified Modelling Language (UML).
Passaggio 2) Identificare il grano
Il livello di dettaglio definisce il livello di dettaglio del problema aziendale, ovvero il livello più basso di informazioni memorizzate in qualsiasi tabella.
Se una tabella contiene i dati di vendita giornalieri, ha una granularità giornaliera; se contiene i totali mensili, ha una granularità mensile.
Durante questa fase, dovrai rispondere a domande come:
- Il magazzino dovrebbe contenere tutti i prodotti disponibili o solo alcune tipologie di prodotto? Dipende dai processi aziendali selezionati.
- I dati di vendita dei prodotti devono essere registrati su base mensile, settimanale, giornaliera o oraria? Dipende dai report richiesti dai dirigenti.
- In che modo queste due scelte influiscono sulle dimensioni del database?
Esempio di grano: Immaginate che l'amministratore delegato di una multinazionale voglia monitorare le vendite di specifici prodotti in diverse località, misurate su base giornaliera.
In tale scenario, il grano diventa "informazioni sulle vendite del prodotto per località e per giorno".
Passaggio 3) Identificare le dimensioni
Le dimensioni sono sostantivi come data, negozio e inventario, e contengono i dati descrittivi.
Ad esempio, una dimensione data può contenere l'anno, il mese e il giorno della settimana.
Esempio di dimensioni: Lo stesso requisito di vendite giornaliere determina la scelta delle dimensioni.
In questo scenario, le dimensioni sono Prodotto, Posizione e Tempo.
La dimensione Prodotto contiene attributi quali la chiave del prodotto (una chiave esterna), il nome, il tipo e le specifiche.
La dimensione Posizione è organizzata in una gerarchia: paese, stato, città, indirizzo e nome.
Fase 4) Identificare i fatti
Questo passaggio è strettamente legato agli utenti aziendali del sistema, poiché definisce i dati che questi prelevano dal data warehouse.
La maggior parte delle righe delle tabelle dei fatti contiene valori numerici, come il prezzo o il costo per unità.
Esempio di fatti: Il requisito delle vendite giornaliere definisce nuovamente il contesto.
In questo caso, il dato di riferimento è la somma delle vendite per prodotto, per luogo e per periodo di tempo.
Passaggio 5) Costruisci lo schema
In quest'ultimo passaggio, si implementa il modello dimensionale. Uno schema è semplicemente la struttura del database, ovvero la disposizione delle tabelle, e due schemi sono particolarmente comuni.
Il primo è il schema a stella, che è facile da progettare e prende il nome dalla sua forma: una tabella centrale dei fatti con tabelle delle dimensioni che si irradiano verso l'esterno come le punte di una stella.
In uno schema a stella, la tabella dei fatti è in terza forma normale mentre le tabelle delle dimensioni sono denormalizzate; questo schema a stella nella modellazione del data warehouse La guida illustra il funzionamento attraverso un esempio completo.
La seconda è la schema del fiocco di neve, un'estensione dello schema a stella in cui ogni dimensione è normalizzata e collegata ad ulteriori tabelle dimensionali, come spiegato in questo schema a fiocco di neve nel modello del data warehouse guida.
Regole per la modellazione dimensionale
Le seguenti regole e principi guidano una modellazione dimensionale efficace:
- Carica i dati atomici nelle strutture dimensionali.
- Costruisci modelli dimensionali attorno ai processi aziendali.
- Assicurati che ogni tabella dei fatti abbia una tabella delle dimensioni data associata.
- Mantieni tutti i dati in un'unica tabella, con lo stesso livello di dettaglio.
- Memorizza le etichette dei report e i valori del dominio di filtro nelle tabelle delle dimensioni.
- Assegna a ogni tabella delle dimensioni una chiave surrogata.
- Bilanciare costantemente i requisiti con la realtà per fornire una soluzione che supporti il processo decisionale aziendale.
Vantaggi della modellazione dimensionale
La modellazione dimensionale offre numerosi vantaggi pratici:
- Le dimensioni standardizzate consentono una reportistica semplice e coerente in tutti i settori aziendali.
- Le tabelle dimensionali memorizzano la cronologia delle informazioni dimensionali.
- È possibile introdurre nuove dimensioni senza apportare modifiche sostanziali alla tabella dei fatti.
- I dati vengono memorizzati in modo da facilitarne il recupero una volta inseriti nel database.
- Rispetto al modello normalizzato, le tabelle dimensionali sono più facili da comprendere perché le informazioni sono raggruppate in categorie aziendali chiare.
- Il modello si basa su termini aziendali, quindi l'azienda sa cosa significa ogni fatto, dimensione o attributo.
- Poiché il modello è denormalizzato, è ottimizzato per query veloci e molte piattaforme relazionali ottimizzano i propri piani di esecuzione di conseguenza.
- Lo schema offre prestazioni elevate con un numero ridotto di join e una ridondanza dei dati minimizzata.
- I modelli dimensionali si adattano facilmente ai cambiamenti, poiché è possibile aggiungere colonne alle tabelle dimensionali senza influire sulle applicazioni di business intelligence esistenti.
Cos'è il modello di dati multidimensionale nel data warehouse?
A modello di dati multidimensionale rappresenta i dati come cubi di dati, consentendo di modellare e visualizzare i dati attraverso diverse dimensioni definite da dimensioni e fatti. Un tale modello è solitamente organizzato attorno a un tema centrale e rappresentato da una tabella dei fatti, e costituisce la base di OLAP analisi.
