
Esempio di Hadoop MapReduce: Primo Java Programma con Code
 Prafulla Ranadive
⚡ Riepilogo intelligente
I programmi Hadoop MapReduce sono scritti come tre Java classi, un mapper, un reducer e un driver, che vengono compilati, impacchettati in un file jar e inviati al cluster per contare le vendite per paese.
In questo tutorial imparerai a utilizzare Hadoop con gli esempi MapReduce. I dati di input utilizzati sono VenditeJan2009.csvContiene informazioni relative alle vendite, come il nome del prodotto, il prezzo, la modalità di pagamento, la città e il paese del cliente. L'obiettivo è scoprire il numero di prodotti venduti in ciascun paese.
Primo programma Hadoop MapReduce
Ora in questo Tutorial su MapReduce, creeremo il nostro primo Java Programma MapReduce:
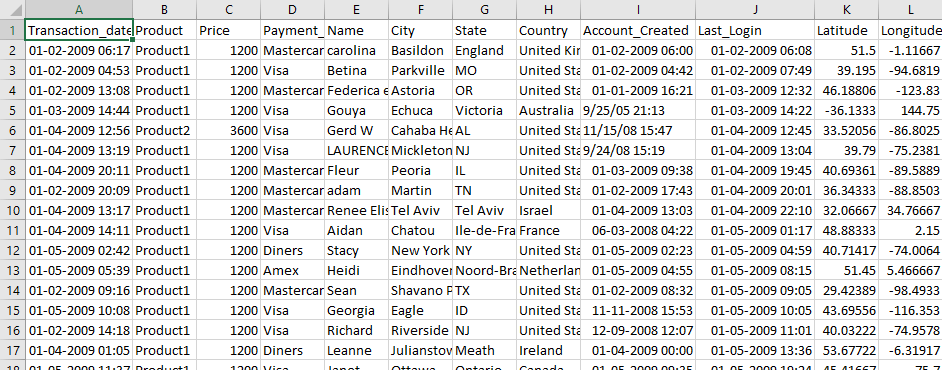
Lo screenshot qui sotto mostra i dati grezzi delle vendite di gennaio 2009, dove ogni riga rappresenta una transazione e il paese si trova nell'ottava colonna, separata da virgole.
Assicurati di aver installato Hadoop. Prima di iniziare la procedura vera e propria, cambia utente in 'hduser' (l'ID utilizzato durante la configurazione di Hadoop; puoi passare all'ID utente che usi durante la tua configurazione di Hadoop).
su - hduser_
Il prompt cambia e passa all'account hduser, come mostrato di seguito.

Passaggio 1) Creare la directory del progetto e i file sorgente
Crea una nuova directory con il nome MapReduceTutorial come mostrato nell'esempio MapReduce qui sotto.
sudo mkdir MapReduceTutorial

Concedi i permessi
sudo chmod -R 777 MapReduceTutorial

Crea i tre Java file sorgente sotto all'interno di MapReduceTutorial. Nota che tutti e tre utilizzano il vecchio org.apache.hadoop.mapred API, che è ancora inclusa in Hadoop 3.x.
SalesMapper.java
package SalesCountry;

import java.io.IOException;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapred.*;

public class SalesMapper extends MapReduceBase implements Mapper <LongWritable, Text, Text, IntWritable> {
	private final static IntWritable one = new IntWritable(1);

	public void map(LongWritable key, Text value, OutputCollector <Text, IntWritable> output, Reporter reporter) throws IOException {

		String valueString = value.toString();
		String[] SingleCountryData = valueString.split(",");
		output.collect(new Text(SingleCountryData[7]), one);
	}
}
SalesCountryReducer.java
package SalesCountry;

import java.io.IOException;
import java.util.*;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapred.*;

public class SalesCountryReducer extends MapReduceBase implements Reducer<Text, IntWritable, Text, IntWritable> {

	public void reduce(Text t_key, Iterator<IntWritable> values, OutputCollector<Text,IntWritable> output, Reporter reporter) throws IOException {
		Text key = t_key;
		int frequencyForCountry = 0;
		while (values.hasNext()) {
			// replace type of value with the actual type of our value
			IntWritable value = (IntWritable) values.next();
			frequencyForCountry += value.get();

		}
		output.collect(key, new IntWritable(frequencyForCountry));
	}
}
SalesCountryDriver.java
package SalesCountry;

import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.*;
import org.apache.hadoop.mapred.*;

public class SalesCountryDriver {
    public static void main(String[] args) {
        JobClient my_client = new JobClient();
        // Create a configuration object for the job
        JobConf job_conf = new JobConf(SalesCountryDriver.class);

        // Set a name of the Job
        job_conf.setJobName("SalePerCountry");

        // Specify data type of output key and value
        job_conf.setOutputKeyClass(Text.class);
        job_conf.setOutputValueClass(IntWritable.class);

        // Specify names of Mapper and Reducer Class
        job_conf.setMapperClass(SalesCountry.SalesMapper.class);
        job_conf.setReducerClass(SalesCountry.SalesCountryReducer.class);

        // Specify formats of the data type of Input and output
        job_conf.setInputFormat(TextInputFormat.class);
        job_conf.setOutputFormat(TextOutputFormat.class);

        // Set input and output directories using command line arguments,
        //arg[0] = name of input directory on HDFS, and arg[1] =  name of output directory to be created to store the output file.

        FileInputFormat.setInputPaths(job_conf, new Path(args[0]));
        FileOutputFormat.setOutputPath(job_conf, new Path(args[1]));

        my_client.setConf(job_conf);
        try {
            // Run the job
            JobClient.runJob(job_conf);
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
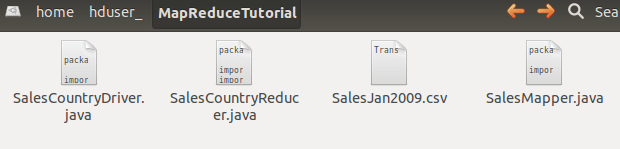
L'archivio si espande negli stessi tre file sorgente, come mostrato qui.
Controlla i permessi di tutti questi file

Se mancano i permessi di lettura, concedeteli:

Passaggio 2) Esportare il classpath di Hadoop
Esporta il classpath come mostrato nell'esempio Hadoop qui sotto.
export CLASSPATH="$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-core-2.2.0.jar:$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-common-2.2.0.jar:$HADOOP_HOME/share/hadoop/common/hadoop-common-2.2.0.jar:~/MapReduceTutorial/SalesCountry/*:$HADOOP_HOME/lib/*"
Il classpath esportato viene visualizzato nuovamente nel prompt.

Passaggio 3) Compilare il Java file
Compila il Java file (questi file sono presenti nella directory Final-MapReduceHandsOn). I relativi file di classe verranno inseriti nella directory del pacchetto.
javac -d . SalesMapper.java SalesCountryReducer.java SalesCountryDriver.java
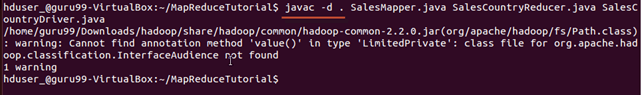
Questo avviso può essere tranquillamente ignorato: indica solo che l'API di MapRed è obsoleta.
Questa compilazione creerà una directory nella directory corrente denominata con il nome del pacchetto specificato in Java Inserire al suo interno il file sorgente (ad esempio SalesCountry nel nostro caso) e tutti i file di classe compilati.

Passaggio 4) Creare il file manifest
Crea un nuovo file denominato Manifest.txt
sudo gedit Manifest.txt
Aggiungi la seguente riga:
Main-Class: SalesCountry.SalesCountryDriver

SalesCountry.SalesCountryDriver è il nome della classe principale. Nota che devi premere il tasto Invio alla fine di questa riga.
Passaggio 5) Impacchettare le classi in un barattolo
Crea un file Jar
jar cfm ProductSalePerCountry.jar Manifest.txt SalesCountry/*.class

Verifica che il file jar sia stato creato

Passaggio 6) Avviare Hadoop
Avvia Hadoop
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Passaggio 7) Copiare il file di input in HDFS
Copia il file SalesJan2009.csv nella directory ~/inputMapReduce
Ora usa il comando seguente per copiare ~/inputMapReduce in HDFS.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/inputMapReduce /
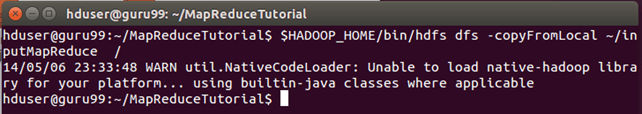
Possiamo tranquillamente ignorare questo avvertimento.
Verificare se un file è effettivamente copiato o meno.
$HADOOP_HOME/bin/hdfs dfs -ls /inputMapReduce

Passaggio 8) Eseguire il job MapReduce
Esegui il lavoro MapReduce
$HADOOP_HOME/bin/hadoop jar ProductSalePerCountry.jar /inputMapReduce /mapreduce_output_sales

Ciò creerà una directory di output denominata mapreduce_output_sales su HDFS. Il contenuto di questa directory sarà un file contenente le vendite di prodotti per paese.
Passaggio 9) Leggere i risultati
Il risultato può essere visualizzato tramite l'interfaccia di comando come segue:
$HADOOP_HOME/bin/hdfs dfs -cat /mapreduce_output_sales/part-00000
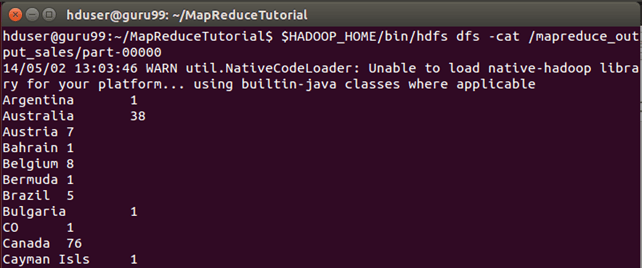
I risultati possono anche essere visualizzati tramite un'interfaccia web come-
Apri http://localhost:50070/ in un browser web. Su Hadoop 3.x l'interfaccia utente web di NameNode è stata spostata sulla porta 9870, quindi usa http://localhost:9870/ lì invece.

Ora seleziona 'Esplora il filesystem' e vai a /mapreduce_output_sales

Aprire la parte r-00000

Spiegazione della classe SalesMapper
Dopo aver descritto il lavoro dall'inizio alla fine, le prossime tre sezioni illustrano nel dettaglio le funzioni di ciascuna classe.
In questa sezione, analizzeremo l'implementazione della classe SalesMapper.
1. Iniziamo specificando il nome del pacchetto per la nostra classe. SalesCountry è il nome del nostro pacchetto. Si noti che l'output della compilazione, SalesMapper.class, verrà salvato in una directory con lo stesso nome del pacchetto: SalesCountry.
Successivamente importiamo i pacchetti di librerie.
L'immagine sottostante mostra un'implementazione della classe SalesMapper.

Campione Code Spiegazione:
1. Definizione della classe SalesMapper-
public class SalesMapper extends MapReduceBase implements Mapper<LongWritable, Text, Text, IntWritable> {
Ogni classe mapper deve estendere la classe MapReduceBase e deve implementare l'interfaccia Mapper.
2. Definizione della funzione 'mappa'-
public void map(LongWritable key,
         Text value,
OutputCollector<Text, IntWritable> output,
Reporter reporter) throws IOException
La parte principale della classe Mapper è un metodo 'map()' che accetta quattro argomenti.
Ad ogni chiamata al metodo 'map()', viene passata una coppia chiave-valore ('key' e 'value' in questo codice).
Il metodo 'map()' inizia suddividendo il testo di input ricevuto come argomento. Suddivide ogni riga in campi.
String valueString = value.toString();
String[] SingleCountryData = valueString.split(",");
Qui, la virgola (,) viene utilizzata come delimitatore.
Dopodiché, viene formata una coppia utilizzando un record all'indice 7 dell'array 'SingleCountryData' e un valore '1'.
output.collect(new Text(SingleCountryData[7]), one);
Selezioniamo il record all'indice 7 perché abbiamo bisogno dei dati relativi al Paese, che si trovano all'indice 7 nell'array 'SingleCountryData'.
Si prega di notare che i nostri dati di input sono nel formato seguente (dove Paese si trova all'indice 7, con 0 come indice iniziale)-
Transaction_date,Product,Price,Payment_Type,Name,City,State,Country,Account_Created,Last_Login,Latitude,Longitude
L'output del mapper è nuovamente una coppia chiave-valore che viene emessa utilizzando il metodo 'collect()' di 'OutputCollector'.
Spiegazione della classe SalesCountryReducer
In questa sezione, analizzeremo l'implementazione della classe SalesCountryReducer.
1. Iniziamo specificando il nome del pacchetto per la nostra classe. SalesCountry è il nome del nostro pacchetto. Si noti che l'output della compilazione, SalesCountryReducer.class, verrà salvato in una directory con lo stesso nome del pacchetto: SalesCountry.
Successivamente importiamo i pacchetti di librerie.
L'immagine seguente mostra un'implementazione della classe SalesCountryReducer.
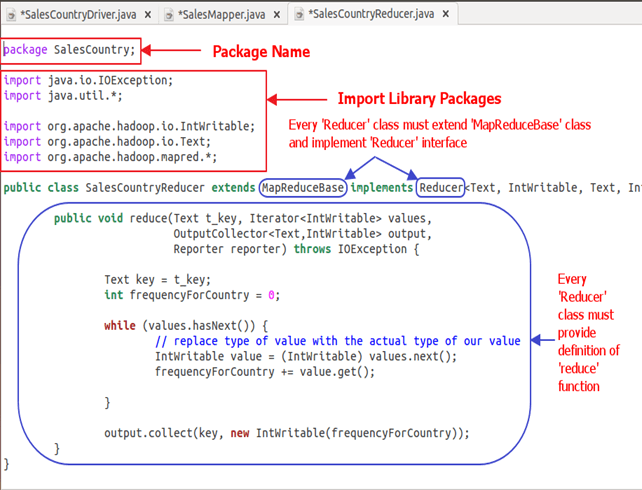
Code Spiegazione:
1. Definizione della classe SalesCountryReducer-
public class SalesCountryReducer extends MapReduceBase implements Reducer<Text, IntWritable, Text, IntWritable> {
Qui, i primi due tipi di dati, 'Text' e 'IntWritable', rappresentano il tipo di dati della coppia chiave-valore in ingresso al reducer.
L'output del mapper è nella forma di , L'output del mapper diventa l'input del reducer. Pertanto, per allinearsi al suo tipo di dati, vengono utilizzati Text e IntWritable come tipi di dati.
Gli ultimi due tipi di dati, 'Text' e 'IntWritable', rappresentano il tipo di dati di output generato dal reducer sotto forma di coppia chiave-valore.
Ogni classe reducer deve estendere la classe MapReduceBase e deve implementare l'interfaccia Reducer.
2. Definizione della funzione "riduci"
public void reduce( Text t_key,
             Iterator<IntWritable> values,
             OutputCollector<Text,IntWritable> output,
             Reporter reporter) throws IOException {
L'input del metodo reduce() è una chiave contenente un elenco di più valori.
Ad esempio, nel nostro caso, sarà-
, , , , , .
Questo viene dato al riduttore come
Pertanto, per accettare argomenti di questa forma, vengono utilizzati innanzitutto due tipi di dati, ovvero Testo e Iteratore. . Il testo è un tipo di dati di chiave e iteratore è un tipo di dati per un elenco di valori per quella chiave.
L'argomento successivo è di tipo OutputCollector che raccoglie l'uscita della fase di riduzione.
Il metodo reduce() inizia copiando il valore della chiave e inizializzando il conteggio della frequenza a 0.
Text key = t_key;int frequencyForCountry = 0;
Successivamente, utilizzando un ciclo 'while', scorriamo l'elenco dei valori associati alla chiave e calcoliamo la frequenza finale sommando tutti i valori.
 while (values.hasNext()) {
            // replace type of value with the actual type of our value
            IntWritable value = (IntWritable) values.next();
            frequencyForCountry += value.get();

        }
Ora inviamo il risultato al collettore di output sotto forma di chiave e conteggio della frequenza ottenuta.
Il codice seguente fa questo-
output.collect(key, new IntWritable(frequencyForCountry));
Spiegazione della classe SalesCountryDriver
In questa sezione, analizzeremo l'implementazione della classe SalesCountryDriver.
1. Iniziamo specificando il nome del pacchetto per la nostra classe. SalesCountry è il nome del nostro pacchetto. Si noti che l'output della compilazione, SalesCountryDriver.class, verrà salvato in una directory con lo stesso nome del pacchetto: SalesCountry.
Ecco una riga che specifica il nome del pacchetto seguito dal codice per importare i pacchetti della libreria.

2. Definire una classe driver che creerà un nuovo lavoro client, un oggetto di configurazione e pubblicizzerà le classi Mapper e Reducer.
La classe driver è responsabile dell'impostazione del nostro lavoro MapReduce per l'esecuzione HadoopIn questa classe, specifichiamo il nome del job, il tipo di dati di input/output e i nomi delle classi mapper e reducer.

3. Nello snippet di codice seguente, impostiamo le directory di input e output che vengono utilizzate rispettivamente per consumare il set di dati di input e produrre output.
arg[0] e arg[1] sono gli argomenti della riga di comando passati con un comando dato in MapReduce hands-on, vale a dire,
$HADOOP_HOME/bin/hadoop jar ProductSalePerCountry.jar /inputMapReduce /mapreduce_output_sales
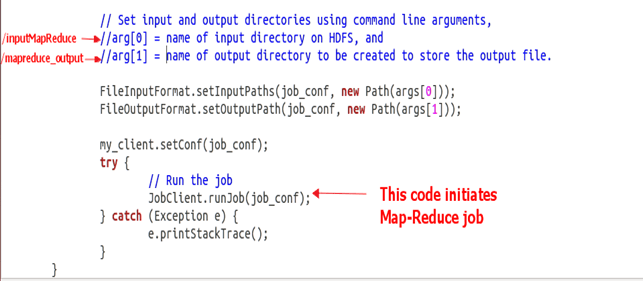
4. Attiva il nostro lavoro
Il codice seguente avvia l'esecuzione del job MapReduce.
try {
    // Run the job
    JobClient.runJob(job_conf);
} catch (Exception e) {
    e.printStackTrace();
}
