
Tutorial su Apache Flume: cos'è Archiarchitettura e esempio Hadoop
 Prafulla Ranadive
⚡ Riepilogo intelligente
Apache Flume è un servizio distribuito per la raccolta, l'aggregazione e lo spostamento di grandi volumi di dati di log in HDFS, basato su agenti che collegano tra loro una sorgente, un canale e un punto di destinazione.
Cos'è Apache Flume in Hadoop?
Apache Flume è un sistema affidabile e distribuito per la raccolta, l'aggregazione e lo spostamento di grandi quantità di dati di log. Ha un'architettura semplice ma flessibile basata su flussi di dati in streaming. Apache Flume viene utilizzato per raccogliere i dati di log presenti nei file di log dai server web e aggregarli in HDFS per analisi.
Flume in Hadoop supporta diverse sorgenti, tra cui:
- 'tail' (che trasferisce i dati da un file locale e li scrive in HDFS tramite Flume, in modo simile al comando Unix 'tail')
- Registri di sistema
- Apache log4j (che consente Java applicazioni per scrivere eventi su file in HDFS tramite Flume).
La versione attuale è Flume 1.11.0, pubblicato il 25 ottobre 2022 e disponibile presso l' Pagina di download di Apache FlumeQuesta guida è stata scritta per la versione 1.4.0, quindi alcuni passaggi seguenti contengono una nota in cui si afferma che la versione attuale si comporta diversamente.
Canale artificiale Architectura
Un agente Flume è un JVM Processo con tre componenti – sorgente del canale, canale e pozzo – attraverso i quali gli eventi si propagano dopo essere stati innescati da una sorgente esterna. Il diagramma seguente mostra come sono collegati.
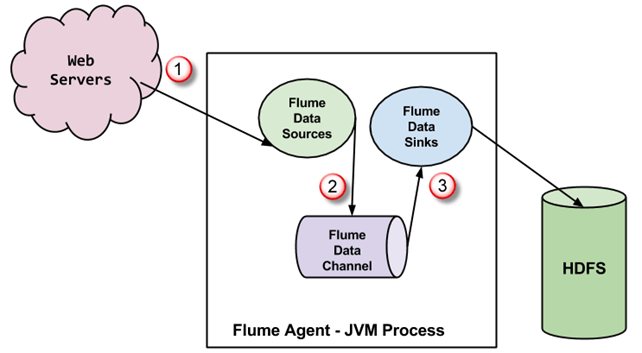
- Gli eventi generati dalla sorgente esterna (un server web) vengono elaborati dalla sorgente Flume. La sorgente esterna invia gli eventi alla sorgente Flume in un formato riconosciuto dalla sorgente di destinazione.
- La sorgente Flume riceve un evento e lo memorizza in uno o più canali. Il canale funge da archivio che conserva l'evento finché non viene consumato dal sink Flume. Questo canale può utilizzare un file system locale per memorizzare tali eventi.
- Il sink di Flume rimuove l'evento da un canale e lo memorizza in un repository esterno come HDFS. Possono esserci più agenti Flume, nel qual caso il sink di Flume inoltra l'evento alla sorgente Flume dell'agente successivo nel flusso.
Alcune caratteristiche importanti del canale
- Flume ha un design flessibile basato su flussi di dati in streaming. È tollerante ai guasti e robusto, con molteplici meccanismi di failover e ripristino. Flume offre diversi livelli di affidabilità, tra cui "consegna con il massimo sforzo" and "consegna end-to-end". consegna con il miglior sforzo non tollera alcun guasto del nodo Flume, mentre consegna end-to-end garantisce la consegna anche in caso di guasti a più nodi.
- Flume trasferisce dati tra sorgenti e destinazioni. Questa raccolta di dati può essere programmata o basata su eventi. Flume dispone di un proprio motore di elaborazione delle query, che semplifica la trasformazione di ogni nuovo batch di dati prima che venga trasferito alla destinazione prevista.
- Possibile Il canale affonda includono HDFS e Base HFlume può anche trasportare dati relativi a eventi, come dati sul traffico di rete, dati generati dai siti web dei social media e messaggi di posta elettronica.
Impostazione del canale, della libreria e del codice sorgente
Prima di iniziare con il processo vero e proprio, assicurati di aver installato Hadoop; in caso contrario, segui le istruzioni. come installare Hadoop Innanzitutto, cambia l'utente in 'hduser' (l'ID utilizzato durante la configurazione di Hadoop; puoi passare all'ID utente che usi durante la tua configurazione di Hadoop).

Passo 1) Crea una nuova directory con il nome 'FlumeTutorial'.
sudo mkdir FlumeTutorial
- Concedi i permessi di lettura, scrittura ed esecuzione.
sudo chmod -R 777 FlumeTutorial
- Copia i file MyTwitterSource.java and MyTwitterSourceForFlume.java in questa directory.
Scarica i file di input da qui
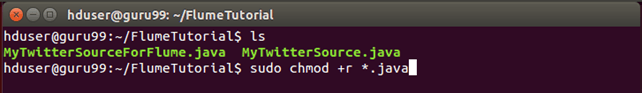
Verifica i permessi di accesso di tutti i file, come indicato di seguito, e concedi il permesso di lettura se mancante.
Passo 2) Scarica 'Apache Flume' da https://flume.apache.org/download.html.
In questo tutorial su Flume è stato utilizzato Apache Flume 1.4.0.

Successivamente, fai clic sul link per accedere a una copia speculare.

Passo 3) Copia il file tarball scaricato nella directory di tua scelta ed escitract il contenuto utilizzando il seguente comando.
sudo tar -xvf apache-flume-1.4.0-bin.tar.gz

Questo crea una nuova directory denominata apache-flume-1.4.0-bin ed extracinserisce i file al suo interno. Quella directory è chiamata nel resto dell'articolo.
Passo 4) Configurazione della libreria Flume. Copiare twitter4j-core-4.0.1.jar, flume-ng-configuration-1.4.0.jar, flume-ng-core-1.4.0.jar e flume-ng-sdk-1.4.0.jar in
/lib/
Uno o tutti i file JAR copiati potrebbero avere i permessi di esecuzione, il che può causare problemi con la compilazione del codice, quindi è necessario revocarli. Nel mio caso, il file twitter4j-core-4.0.1.jar aveva i permessi di esecuzione. Li ho revocati come mostrato di seguito.
sudo chmod -x twitter4j-core-4.0.1.jar

Dopodiché, il comando seguente concede a tutti i permessi di lettura sul file twitter4j-core-4.0.1.jar.
sudo chmod +rrr /usr/local/apache-flume-1.4.0-bin/lib/twitter4j-core-4.0.1.jar
Si prega di notare che ho scaricato twitter4j-core-4.0.1.jar da Repository Mavene tutti i JAR di Flume, cioè flume-ng-*-1.4.0.jar, da gli artefatti org.apache.flume.
Carica i dati da Twitter utilizzando Flume
Passo 1) Accedere alla directory contenente i file del codice sorgente.
Passo 2) Imposta CLASSPATH in modo che contenga /lib/* e ~/FlumeTutorial/flume/mytwittersource/*.
export CLASSPATH="/usr/local/apache-flume-1.4.0-bin/lib/*:~/FlumeTutorial/flume/mytwittersource/*"

Passo 3) Compila il codice sorgente utilizzando il comando seguente.
javac -d . MyTwitterSourceForFlume.java MyTwitterSource.java

Passo 4) Crea un file JAR. Innanzitutto, crea un file Manifest.txt utilizzando un editor di testo a tua scelta e aggiungi la riga seguente al suo interno.
Main-Class: flume.mytwittersource.MyTwitterSourceForFlume
Qui flume.mytwittersource.MyTwitterSourceForFlume è il nome della classe principale. Nota che devi premere il tasto Invio alla fine di questa riga, come mostrato di seguito.

Ora, crea il file JAR 'MyTwitterSourceForFlume.jar' come segue.
jar cfm MyTwitterSourceForFlume.jar Manifest.txt flume/mytwittersource/*.class

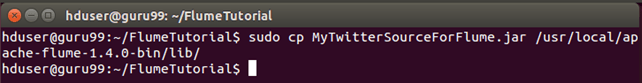
Passo 5) Copia questo JAR in /lib/.
sudo cp MyTwitterSourceForFlume.jar <Flume Installation Directory>/lib/
Passo 6) Vai alla directory di configurazione di Flume, /conf.
Se il file flume.conf non esiste, copia flume-conf.properties.template e rinominalo in flume.conf.
sudo cp flume-conf.properties.template flume.conf

Se il file flume-env.sh non esiste, copiare il file flume-env.sh.template e rinominarlo in flume-env.sh.
sudo cp flume-env.sh.template flume-env.sh

Creazione di un'applicazione Twitter
Leggi prima questo. Lo streaming v1.1 statuses/filter L'endpoint di cui ha bisogno twitter4j 4.0.1 è stato ritirato il 9 marzo 2023 e il flusso filtrato API v2 che lo ha sostituito, ora a developer.x.com, è disponibile solo a pagamento. Considera le schermate seguenti come un modello di origine personalizzata, quindi configura lo stesso agente per un'origine file, eseguibile o Kafka.
Passo 1) Crea un'applicazione Twitter accedendo al portale per sviluppatori.


Passo 2) Vai su "Le mie applicazioni" (questa opzione si apre cliccando sul pulsante a forma di uovo nell'angolo in alto a destra).

Passo 3) Crea una nuova applicazione facendo clic su "Crea nuova app".
Passo 4) Inserisci i dettagli dell'applicazione specificando il nome dell'applicazione, una descrizione e un sito web. Puoi consultare le note riportate sotto ciascun campo di input.
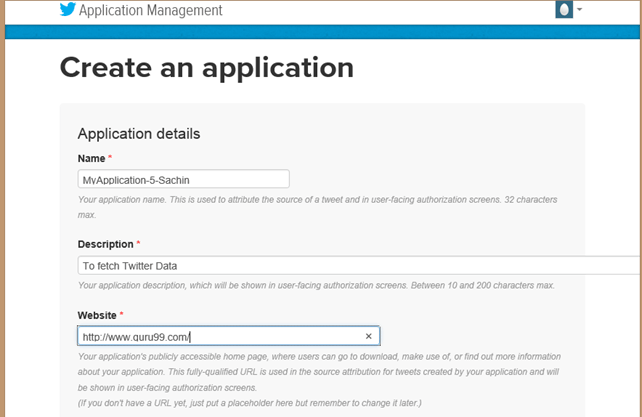
Passo 5) Scorri la pagina verso il basso, accetta i termini selezionando "Sì, accetto" e clicca sul pulsante "Crea la tua applicazione Twitter".

Passo 6) Nella finestra dell'applicazione appena creata, vai alla scheda "Chiavi API", scorri la pagina verso il basso e fai clic sul pulsante "Crea il mio token di accesso".


Passo 7) Ricarica la pagina.
Passo 8) Fai clic su 'Testa OAuth'. Verranno visualizzate le impostazioni 'OAuth' dell'applicazione.

Passo 9) Modifica il file 'flume.conf' utilizzando queste impostazioni OAuth. I passaggi per modificare 'flume.conf' sono indicati di seguito.

Per aggiornare il file 'flume.conf', dobbiamo copiare la chiave del consumatore, il segreto del consumatore, il token di accesso e il segreto del token di accesso.
Nota: questi valori appartengono all'utente e sono pertanto riservati, quindi non devono essere condivisi.
Modifica il file "flume.conf".
Passo 1) Apri il file 'flume.conf' in modalità scrittura e imposta i valori per i parametri seguenti.
sudo gedit flume.conf
Copia il contenuto qui sotto.
MyTwitAgent.sources = Twitter
MyTwitAgent.channels = MemChannel
MyTwitAgent.sinks = HDFS
MyTwitAgent.sources.Twitter.type = flume.mytwittersource.MyTwitterSourceForFlume
MyTwitAgent.sources.Twitter.channels = MemChannel
MyTwitAgent.sources.Twitter.consumerKey = <Copy consumer key value from Twitter App>
MyTwitAgent.sources.Twitter.consumerSecret = <Copy consumer secret value from Twitter App>
MyTwitAgent.sources.Twitter.accessToken = <Copy access token value from Twitter App>
MyTwitAgent.sources.Twitter.accessTokenSecret = <Copy access token secret value from Twitter App>
MyTwitAgent.sources.Twitter.keywords = guru99
MyTwitAgent.sinks.HDFS.channel = MemChannel
MyTwitAgent.sinks.HDFS.type = hdfs
MyTwitAgent.sinks.HDFS.hdfs.path = hdfs://localhost:54310/user/hduser/flume/tweets/
MyTwitAgent.sinks.HDFS.hdfs.fileType = DataStream
MyTwitAgent.sinks.HDFS.hdfs.writeFormat = Text
MyTwitAgent.sinks.HDFS.hdfs.batchSize = 1000
MyTwitAgent.sinks.HDFS.hdfs.rollSize = 0
MyTwitAgent.sinks.HDFS.hdfs.rollCount = 10000
MyTwitAgent.channels.MemChannel.type = memory
MyTwitAgent.channels.MemChannel.capacity = 10000
MyTwitAgent.channels.MemChannel.transactionCapacity = 1000

Passo 2) Inoltre, imposta TwitterAgent.sinks.HDFS.hdfs.path come segue.
TwitterAgent.sinks.HDFS.hdfs.path = hdfs:// : / /canale d'acqua/tweet/

Per trovare , E , vedere il valore del parametro 'fs.defaultFS' impostato in $HADOOP_HOME/etc/hadoop/core-site.xml, mostrato di seguito.

Passo 3) Per trasferire i dati su HDFS non appena disponibili, eliminare la voce seguente, se presente.
TwitterAgent.sinks.HDFS.hdfs.rollInterval = 600
Esempio: streaming di dati Twitter utilizzando Flume
Passo 1) Apri il file 'flume-env.sh' in modalità scrittura e imposta i valori per i parametri seguenti.
JAVA_HOME=<Installation directory of Java>
FLUME_CLASSPATH="<Flume Installation Directory>/lib/MyTwitterSourceForFlume.jar"

Passo 2) Avvia Hadoop.
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Passo 3) Due dei file JAR presenti nell'archivio tar di Flume non sono compatibili con Hadoop 2.2.0, quindi in questo esempio di Apache Flume seguiamo i passaggi descritti di seguito per rendere Flume compatibile con Hadoop 2.2.0. Questa sostituzione di file JAR è una correzione risalente alla versione 1.4.0; Flume 1.11.0 include già le versioni più recenti di protobuf e Guava, quindi un archivio tar moderno in genere non necessita di questa modifica.
a. Spostare protobuf-java-2.4.1.jar fuori da ' /lib'. Vai prima in quella directory.
CD /lib
sudo mv protobuf-java-2.4.1.jar ~/

b. Individua il file JAR 'guava' come mostrato di seguito.
find . -name "guava*"

Spostare guava-10.0.1.jar fuori da ' /lib'.
sudo mv guava-10.0.1.jar ~/

c. Scarica guava-17.0.jar da Repository Maven, mostrato di seguito.

Ora copia questo file JAR scaricato in ' /lib'.
Passo 4) Vai a ' /bin' e avviare Flume come segue.
./flume-ng agent -n MyTwitAgent -c conf -f <Flume Installation Directory>/conf/flume.conf

La finestra del prompt dei comandi da cui Flume scarica i tweet si presenta così.

Dal messaggio nella finestra dei comandi possiamo vedere che l'output viene scritto nella directory /user/hduser/flume/tweets/. Ora, apri questa directory usando un browser web.
Passo 5) Per visualizzare il risultato del caricamento dei dati, apri http://localhost:50070/ in un browser, esplora il file system, quindi vai alla directory in cui sono stati caricati i dati, ovvero
/canale d'acqua/tweet/
La porta 50070 è l'interfaccia web del NameNode su Hadoop 2; Hadoop 3 ha spostato la stessa pagina sulla porta 9870.

Flume rappresenta una metà dell'ingestione: Sqop importa tabelle in batch, Flume trasmette eventi, quindi Maiale or Alveare modellare i file e oozie pianifica la catena. Vedi anche strumenti di analisi dei big data, Join e contatori MapReduce and Talend.
