
Trasformazione dell'aggregatore in Informatica con esempio
 David Carter
⚡ Riepilogo intelligente
In Informatica, la trasformazione Aggregator è l'oggetto attivo che esegue calcoli come somma, media e conteggio su un gruppo di righe, memorizzando tali righe in una cache aggregata fino al completamento di ciascun gruppo.
Cos'è la trasformazione dell'aggregatore?
La trasformazione Aggregator è una trasformazione attiva che esegue calcoli aggregati come somma, media e conteggio.
Ad esempio, se si desidera calcolare la somma degli stipendi di tutti i dipendenti suddivisi per reparto, è possibile utilizzare la trasformazione Aggregatore.
Le operazioni di aggregazione vengono eseguite su un gruppo di righe, pertanto è necessario un segnaposto temporaneo per archiviare tutti questi record ed eseguire i calcoli.
A tale scopo, viene utilizzata la cache dell'aggregatore. Si tratta di una memoria principale temporanea allocata alla trasformazione Aggregator per eseguire tali operazioni, ed è suddivisa in due parti: la cache degli indici memorizza i valori di gruppo, mentre la cache dei dati memorizza i dati delle righe da aggregare.
La trasformazione è attiva perché modifica il numero di righe nella pipeline. Possono entrarvi diverse migliaia di record di dipendenti e ne esce solo una riga per reparto.
Come utilizzare la trasformazione Aggregator in Informatica
In questo esempio, calcoleremo la somma degli stipendi per reparto. Per questo, abbiamo bisogno di una nuova colonna per memorizzare questa somma. Quindi, prima di tutto, prepareremo una nuova colonna.
Passo 1) Crea una nuova tabella di destinazione del database, ad esempio "sum_sal_deptwise", utilizzando lo script seguente. Vedrai la nuova tabella di destinazione del database creata sotto Targetcartella s nel passaggio successivo.
Scarica il file Create_table_sal_deptwise.txt sopra
Passo 2) Crea un nuovo carta geograficaping “m_sum_sal_deptwise”.
Per creare la nuova mappaping, abbiamo bisogno della tabella sorgente (EMP) e della tabella di destinazione (sum_sal_deptwise) in Mapping Progettista, quindi abbiamo bisogno di
- Importa la tabella di destinazione “sum_sal_deptwise” nella mappaping.
- Importa la tabella di origine "emp".
Entrambe le definizioni ora appaiono sulla tela, come mostrato di seguito.
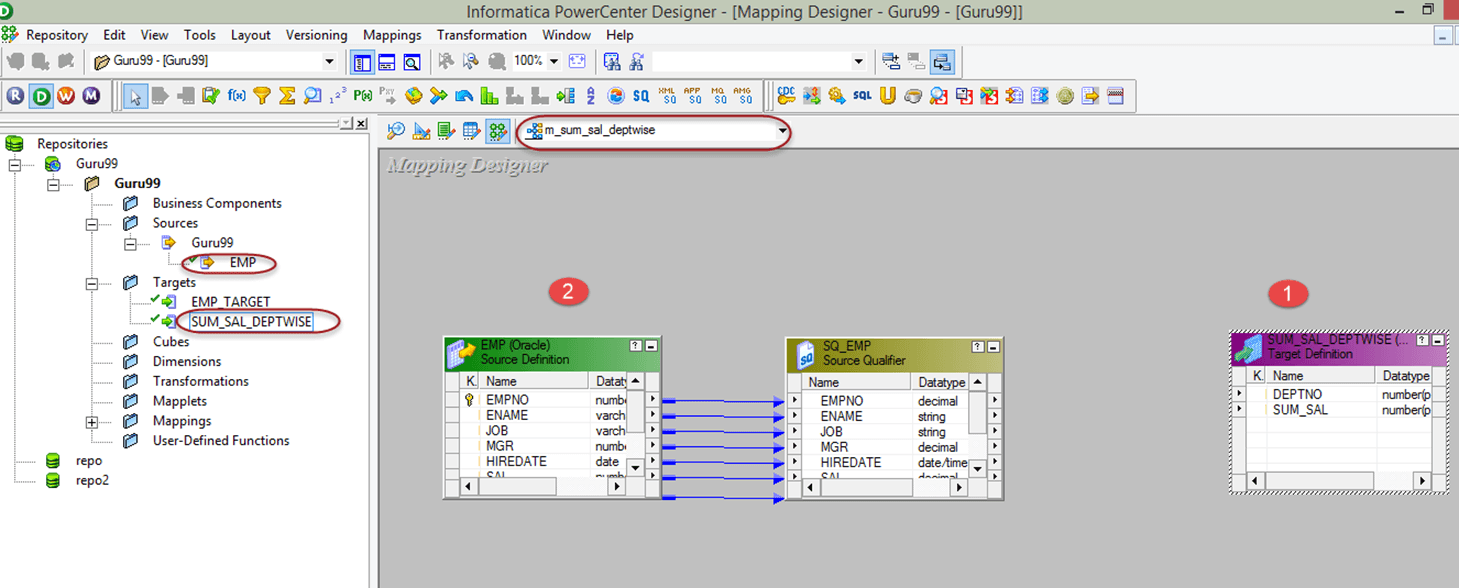
Passo 3) Nella mappaping,
- Dal Qualificatore della fonteElimina le colonne empno, ename, job, mgr, hiredate e comm, lasciando solo le colonne deptno e sal.
- Crea una nuova trasformazione Aggregatore utilizzando il menu della casella degli strumenti, come mostrato nello screenshot. Facendo clic sull'icona dell'aggregatore, verrà creata una nuova trasformazione Aggregatore.
Il nuovo oggetto AGGTRANS appare accanto al Source Qualifier troncato.

Passo 4) Trascina e rilascia le colonne SAL e DEPTNO dal Source Qualifier (SQ_EMP) alla trasformazione Aggregator. Le due porte sono ora collegate in AGGTRANS.

Passo 5) Double-fare clic sulla trasformazione Aggregator per aprirne le proprietà e quindi
- Aggiungi una nuova porta nella trasformazione
- Rinominare la porta in SUM_SAL
- Cambia il tipo di dati di questa nuova porta in double
- Rendi questa porta una porta di uscita selezionando la casella di controllo della porta di uscita
- Fai clic sull'opzione di espressione
La scheda Porte ora elenca SAL, DEPTNO e la nuova porta di output SUM_SAL.

Passo 6) Nella finestra dell'editor di espressioni
- Aggiungi l'espressione sum(SAL); devi scrivere tu stesso questa espressione.
- Seleziona il pulsante OK; in questo modo verrà visualizzata nuovamente la finestra Modifica trasformazioni.
L'editor di espressioni mostra l'espressione di aggregazione assegnata a SUM_SAL.

Passo 7) Nella finestra Modifica trasformazioni, selezionare l'opzione "Raggruppa per" spuntando la casella di controllo accanto alla colonna deptno e fare clic su OK. Selezionando "Raggruppa per" accanto a deptno, si indica a Informatica di raggruppare gli stipendi per deptno.

Passo 8) Collega le colonne deptno e sum_sal dalla trasformazione Aggregator alla tabella di destinazione. La mappaping il processo è quindi completo dalla sorgente alla destinazione.

Ora salva la mappaping e eseguirlo dopo aver creato un nuovo Sessione per questa mappapingLa tabella di destinazione conterrebbe la somma degli stipendi per dipartimento. In questo modo, possiamo utilizzare la trasformazione Aggregator per calcolare i risultati aggregati.
Raggruppamento per porte nella trasformazione dell'aggregatore
Il passaggio precedente ha contrassegnato una singola porta come "Raggruppa per", trasformando così il totale aziendale in un totale per reparto. Qualsiasi porta di ingresso, ingresso/uscita, uscita o variabile può essere contrassegnata allo stesso modo.
Tre regole disciplinano l'insieme dei risultati:
- Una riga per gruppo. Quando i valori vengono raggruppati, il servizio di integrazione genera una riga per ogni combinazione univoca di porte di raggruppamento.
- Nessun raggruppamento, una sola riga. Se non viene selezionata alcuna porta, l'intero input viene trattato come un singolo gruppo e viene restituita una riga per tutte le righe di input.
- L'ultima fila vince. Insieme al risultato aggregato, il servizio di integrazione di solito trasmette l'ultima riga ricevuta nel gruppo, a meno che una funzione come FIRST non specifichi una riga diversa.
Quando sono contrassegnati più porti, l'ordine dei porti determina il gruppoping ordine, e l'ordine può cambiare il risultato. Gruppoping da DEPTNO e poi JOB non è lo stesso di groupping per JOB e poi DEPTNO, perché i valori della seconda colonna non sono necessariamente univoci.
Proprietà di trasformazione dell'aggregatore
La scheda Proprietà della finestra Modifica trasformazioni contiene le impostazioni che determinano dove risiede la cache e quanta ne viene utilizzata. La tabella seguente le elenca.
| Configurazione | Cosa controlla |
|---|---|
| Directory della cache | Cartella locale in cui il servizio di integrazione crea i file di indice e di cache dei dati. Il valore predefinito è la variabile di processo $PMCacheDir impostata in Workflow Manager. |
| TracLivello di ing | Quantità di dettagli scritti nel registro di sessione per questa trasformazione. |
| Input ordinato | Dichiara che i dati in entrata sono già ordinati per gruppo per porte. Selezionalo solo quando la mappaping Fornisce davvero dati ordinati. |
| Dimensione della cache dei dati dell'aggregatore | Dimensione della cache dati. Il valore predefinito è 2,000,000 di byte, mentre l'opzione Automatico consente al servizio di integrazione di dimensionarla automaticamente. |
| Dimensione della cache dell'indice dell'aggregatore | Dimensione della cache dell'indice. Il valore predefinito è 1,000,000 di byte, mentre l'opzione Automatico consente al servizio di integrazione di dimensionarla automaticamente. |
| Ambito della trasformazione | Applica la logica a ciascuna transazione o a tutti i dati in ingresso. L'opzione "Tutti gli input" ignora i limiti delle transazioni in ingresso. |
Quando l'aggregazione incrementale è abilitata, il servizio di integrazione scrive una copia di backup dei file della cache a ogni esecuzione, quindi la directory della cache deve contenere due set di file anziché uno.
Regole per le espressioni aggregate e suggerimenti per migliorare le prestazioni
Un'espressione aggregata può combinare una funzione aggregata con clausole condizionali e funzioni non aggregate, rendendo possibili somme e conteggi condizionali all'interno di un'unica porta. Due regole limitano ciò che può essere scritto.
- Un livello di annidamento. È possibile annidare una sola funzione aggregata all'interno di un'altra, e l'espressione interna viene valutata per prima.
- Nessuna miscelazione. Una trasformazione può contenere funzioni a livello singolo o funzioni annidate, mai entrambe. Se contiene entrambe, il Progettista contrassegna la mappaping non valido, quindi suddividi la logica in due trasformazioni Aggregator.
Per quanto riguarda la messa a punto, tre impostazioni svolgono la maggior parte del lavoro:
- Input ordinato. Quando le righe arrivano ordinate per gruppo e per porte, ogni gruppo può essere rilasciato non appena arriva la sua ultima riga, riducendo così la quantità di dati memorizzati nella cache e velocizzando l'esecuzione della sessione. L'input ordinato non può essere combinato con l'aggregazione incrementale.
- Aggregazione incrementale. Le nuove righe sorgente vengono passate attraverso la mappaping e combinato con la cache storica invece di ricalcolare la cronologia, il che si adatta a un caricamento notturno su un totale progressivo.
- Filtrare in anticipo. Le righe che non contribuiranno mai a un totale devono essere eliminate prima dell'Aggregator, sia nella query Source Qualifier che in un Trasformazione del filtro, perché ogni riga che raggiunge l'Aggregator costa memoria cache. Questo è uno dei controlli standard durante ottimizzazione delle prestazioni.
