
NLTK Tokenize: Tokenizer Kata dan Kalimat dengan Contoh
 Evelyn Clarke
⚡ Ringkasan Cerdas
NLTK Tokenize membagi teks besar menjadi unit-unit yang lebih kecil yang disebut token, sebuah langkah mendasar dalam pemrosesan bahasa alami. Toolkit ini menyediakan word_tokenize untuk memecah kalimat menjadi kata-kata dan sent_tokenize untuk membagi teks menjadi kalimat-kalimat individual.
Apa itu Tokenisasi?
Tokenisasi adalah proses dimana sejumlah besar teks dibagi menjadi bagian-bagian kecil yang disebut token. Token ini sangat berguna untuk menemukan pola dan dianggap sebagai langkah dasar untuk stemming dan lemmatisasi. Tokenisasi juga membantu mengganti elemen data sensitif dengan elemen data non-sensitif.
Pemrosesan bahasa alami digunakan untuk membangun aplikasi seperti klasifikasi teks, chatbot cerdas, analisis sentimental, terjemahan bahasa, dll. Memahami pola dalam teks untuk mencapai tujuan yang disebutkan di atas menjadi penting.
Untuk saat ini, jangan khawatir tentang stemming dan lemmatization tetapi anggap saja sebagai langkah-langkah untuk pembersihan data tekstual menggunakan NLP (Natural language processing). Kita akan membahas stemming dan lemmatization nanti dalam tutorial. Tugas-tugas seperti Klasifikasi teks atau pemfilteran spam memanfaatkan NLP bersama dengan perpustakaan pembelajaran mendalam seperti Keras dan aliran tensor.
Toolkit Bahasa Alami memiliki modul NLTK yang sangat penting tokenisasi kalimat yang selanjutnya terdiri dari sub-modul
- tokenisasi kata
- tokenisasi kalimat
Tokenisasi kata-kata
Kami menggunakan metode ini kata_tokenize() untuk membagi kalimat menjadi kata-kata. Output dari tokenisasi kata dapat dikonversi ke Data Frame untuk pemahaman teks yang lebih baik dalam aplikasi pembelajaran mesin. Ini juga dapat diberikan sebagai masukan untuk langkah pembersihan teks lebih lanjut seperti penghapusan tanda baca, penghapusan karakter numerik, atau stemming. Model pembelajaran mesin memerlukan data numerik untuk dilatih dan membuat prediksi. Tokenisasi kata menjadi bagian penting dari konversi teks (string) menjadi data numerik. Silakan baca tentang Sekantong Kata atau CountVectorizer. Silakan lihat contoh kata tokenize NLTK di bawah ini untuk memahami teori dengan lebih baik.
from nltk.tokenize import word_tokenize
text = "God is Great! I won a lottery."
print(word_tokenize(text))

Output: ['God', 'is', 'Great', '!', 'I', 'won', 'a', 'lottery', '.']
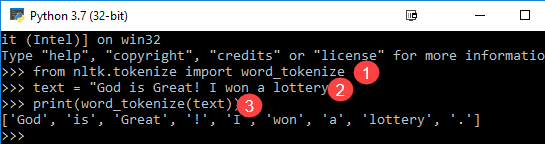
Code Penjelasan
- Modul word_tokenize diimpor dari perpustakaan NLTK.
- Variabel “teks” diinisialisasi dengan dua kalimat.
- Variabel teks diteruskan ke modul Word_tokenize dan mencetak hasilnya. Modul ini memecah setiap kata dengan tanda baca yang dapat Anda lihat di output.
Tokenisasi Kalimat
Sub-modul yang tersedia untuk di atas adalah sent_tokenize. Pertanyaan yang jelas di benak Anda adalah mengapa tokenisasi kalimat diperlukan ketika kita memiliki opsi untuk tokenisasi kata. Bayangkan Anda perlu menghitung rata-rata kata per kalimat, bagaimana cara menghitungnya? Untuk menyelesaikan tugas seperti itu, Anda memerlukan tokenizer kalimat NLTK serta tokenizer kata NLTK untuk menghitung rasionya. Output tersebut berfungsi sebagai fitur penting untuk pelatihan mesin karena jawabannya berupa numerik.
Periksa contoh tokenizer NLTK di bawah ini untuk mempelajari perbedaan tokenisasi kalimat dengan tokenisasi kata.
from nltk.tokenize import sent_tokenize
text = "God is Great! I won a lottery."
print(sent_tokenize(text))

Output: ['God is Great!', 'I won a lottery ']
Kita punya 12 kata-kata dan dua kalimat untuk masukan yang sama.
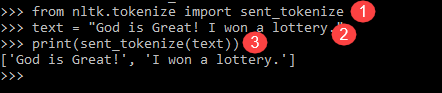
Penjelasan programnya
- Sejalan dengan program sebelumnya, impor modul sent_tokenize.
- Kami telah mengambil kalimat yang sama. Tokenizer kalimat selanjutnya dalam modul NLTK menguraikan kalimat tersebut dan menampilkan keluaran. Jelas bahwa fungsi ini memecah setiap kalimat.
Tokenizer kata di atas Python contohnya adalah batu pengaturan yang baik untuk memahami mekanisme tokenisasi kata dan kalimat.
