
Pembelajaran Mesin yang Diawasi: Algorithms, Jenis & Contoh
 Tim Editorial
⚡ Ringkasan Cerdas
Pembelajaran Mesin Terawasi melatih algoritma pada contoh berlabel sehingga dapat memprediksi hasil untuk data yang belum pernah dilihat sebelumnya, menggunakan regresi untuk target numerik dan klasifikasi untuk target kategori seperti spam atau penipuan.
Apa itu Pembelajaran Mesin yang Diawasi?
Pembelajaran Mesin Terawasi (Supervised Machine Learning) adalah algoritma yang belajar dari data pelatihan berlabel untuk membantu Anda memprediksi hasil untuk data yang tidak terduga. Dalam pembelajaran terawasi, Anda melatih mesin menggunakan data yang telah "dilabeli" dengan baik. Artinya, beberapa data sudah diberi label dengan jawaban yang benar. Hal ini dapat dibandingkan dengan pembelajaran di bawah pengawasan atau bimbingan guru.
Membangun, mengembangkan, dan menerapkan model pembelajaran mesin terawasi yang akurat membutuhkan waktu dan keahlian teknis dari tim ilmuwan data yang sangat terampil. Ilmuwan data juga harus membangun kembali model secara berkala agar wawasan yang dihasilkan tetap akurat meskipun data yang mendasarinya berubah.
Cara Kerja Pembelajaran yang Diawasi
Pembelajaran mesin yang diawasi menggunakan kumpulan data pelatihan untuk mencapai hasil yang diinginkan. Kumpulan data ini berisi masukan dan keluaran yang benar yang membantu model belajar lebih cepat. Misalnya, Anda ingin melatih mesin untuk membantu Anda memperkirakan berapa lama waktu yang Anda perlukan untuk berkendara pulang dari tempat kerja Anda.
Di sini, Anda mulai dengan membuat sekumpulan data berlabel. Data ini meliputi:
- Kondisi cuaca
- Waktu dalam hari
- Liburan
- Rute yang dipilih
Semua detail ini adalah input Anda dalam contoh pembelajaran terawasi ini. Outputnya adalah jumlah waktu yang dibutuhkan untuk berkendara pulang pada hari tertentu, seperti yang ditunjukkan pada gambar di bawah ini.
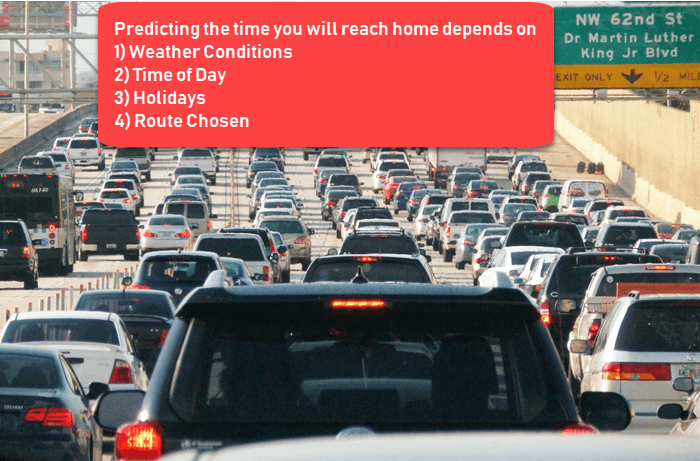
Anda secara naluriah tahu bahwa jika di luar hujan, maka akan membutuhkan waktu lebih lama untuk berkendara pulang. Tetapi mesin membutuhkan data dan statistik.
Hal pertama yang perlu Anda buat adalah kumpulan data pelatihan. Kumpulan data ini akan berisi total waktu perjalanan dan faktor-faktor terkait seperti cuaca, waktu, dll. Berdasarkan kumpulan data pelatihan ini, mesin Anda mungkin akan melihat adanya hubungan langsung antara jumlah curah hujan dan waktu yang Anda butuhkan untuk sampai ke rumah.
Jadi, hal ini memastikan bahwa semakin banyak hujan, semakin lama waktu yang Anda butuhkan untuk berkendara pulang. Hal ini juga dapat melihat hubungan antara waktu Anda meninggalkan pekerjaan dan waktu Anda berada di jalan. Semakin dekat dengan pukul 6 sore, semakin lama waktu yang dibutuhkan untuk sampai ke rumah.
Mesin Anda mungkin menemukan beberapa hubungan dengan data berlabel Anda. Fase pembelajaran tersebut ditunjukkan di bawah ini.
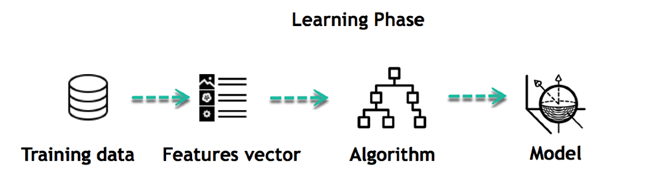
Ini adalah awal dari Model Data Anda. Model ini mulai mencatat bagaimana hujan memengaruhi cara orang mengemudi, dan bahwa lebih banyak orang bepergian selama waktu tertentu dalam sehari.
Jenis Pembelajaran Mesin yang Diawasi Algorithms
Berikut ini adalah jenis algoritma Supervised Machine Learning:
Regresi
Teknik regresi memprediksi nilai keluaran kontinu tunggal menggunakan data pelatihan.
Contoh: Anda dapat menggunakan regresi untuk memprediksi harga rumah dari data pelatihan. Variabel masukannya adalah lokalitas, ukuran rumah, dll.
Kelebihan: Hasil keluaran mudah diinterpretasikan, dan algoritma dapat diregulasi untuk menghindari overfitting.
Kelemahan: Model linier tidak fleksibel, sehingga tidak dapat menangkap hubungan kompleks tanpa fitur tambahan.
Berikut adalah beberapa jenis Regresi Algorithms:
- Regresi linier
- Regresi polinomial
- Regresi Ridge dan Lasso
- Regresi logistik (untuk klasifikasi)
- Regresi pohon keputusan dan hutan acak
- Mendukung regresi vektor
Regresi logistik:
Regresi logistik digunakan untuk memperkirakan nilai diskrit berdasarkan serangkaian variabel independen yang diberikan. Metode ini membantu memprediksi probabilitas terjadinya suatu peristiwa dengan menyesuaikan data ke fungsi logit. Oleh karena itu, metode ini juga dikenal sebagai regresi logit. Karena memprediksi probabilitas, nilai outputnya berada antara 0 dan 1, dan mungkin kurang optimal jika terdapat beberapa batas keputusan atau batas keputusan yang tidak linier.
Klasifikasi
Klasifikasi berarti mengelompokkan output ke dalam suatu kelas. Jika algoritma mencoba memberi label input ke dalam dua kelas yang berbeda, itu disebut klasifikasi biner. Memilih di antara lebih dari dua kelas disebut sebagai klasifikasi multikelas.
Contoh: Menentukan apakah seseorang akan gagal membayar pinjaman atau tidak.
Kelebihan: Pohon klasifikasi bekerja sangat baik dalam praktiknya.
Kelemahan: Pohon keputusan individual yang tidak dibatasi rentan terhadap overfitting.
Berikut adalah beberapa jenis Klasifikasi Algorithms:
- Pengklasifikasi Naif Bayes
- Pohon keputusan
- Mendukung Mesin Vektor
- K-Tetangga Terdekat
- Hutan acak dan penguatan gradien
Pengklasifikasi Naive Bayes
The Bayes Naif Model ini mudah dibangun dan sangat berguna untuk dataset besar. Metode ini terdiri dari graf asiklik terarah dengan satu induk dan beberapa anak. Metode ini mengasumsikan independensi antar node anak yang terpisah dari induknya.
Pohon Keputusan
Pohon keputusan mengklasifikasikan sebuah instance dengan mengurutkannya berdasarkan nilai fitur. Dalam metode ini, setiap node adalah fitur dari sebuah instance yang harus diklasifikasikan, dan setiap cabang mewakili nilai yang dapat diasumsikan oleh node tersebut. Ini adalah teknik yang banyak digunakan untuk klasifikasi.
Struktur yang sama berlaku untuk regresi: pohon regresi membantu Anda memperkirakan nilai riil (biaya pembelian mobil, jumlah panggilan, total penjualan bulanan, dll.).
Mendukung Mesin Vektor
Support Vector Machine (SVM) adalah jenis algoritma pembelajaran yang diperkenalkan pada tahun 1990-an. Metode ini didasarkan pada hasil dari teori pembelajaran statistik yang dikembangkan oleh Vladimir Vapnik dan rekan-rekannya.
SVM juga terkait erat dengan fungsi kernel, yang merupakan konsep sentral untuk sebagian besar tugas pembelajaran. Kerangka kerja kernel dan SVM digunakan di berbagai bidang. Ini termasuk pengambilan informasi multimedia, bioinformatika, dan pengenalan pola. Setiap estimator di atas didokumentasikan dengan parameter penyetelannya di dalam scikit-belajar referensi.
Teknik Pembelajaran Mesin Terawasi vs. Tak Terawasi
Menempatkan metode di samping belajar tanpa pengawasan memperjelas batasannya.
| Berdasarkan | Teknik pembelajaran mesin yang diawasi | Teknik pembelajaran mesin tanpa pengawasan |
|---|---|---|
| Memasukan data | Algorithms dilatih menggunakan data berlabel. | Algorithms digunakan terhadap data yang tidak diberi label |
| Kompleksitas Komputasi | Pembelajaran yang diawasi adalah metode yang lebih sederhana. | Pembelajaran tanpa pengawasan memiliki kompleksitas komputasi |
| Ketepatan | Metode yang sangat akurat dan dapat dipercaya. | Less metode yang akurat dan dapat dipercaya. |
| Algoritma umum | Regresi logistik, pohon keputusan, SVM, Naive Bayes | K-means, pengelompokan hierarkis, PCA |
| Bagaimana hasil dinilai | Dinilai berdasarkan jawaban yang diketahui (akurasi, RMSE) | Dinilai berdasarkan ukuran internal dan peninjauan manusia. |
Tantangan dalam Pembelajaran Mesin Terawasi
Berikut adalah tantangan yang dihadapi dalam pembelajaran mesin yang diawasi:
- Fitur input yang tidak relevan dalam data pelatihan dapat menghasilkan hasil yang tidak akurat.
- Persiapan dan pra-pemrosesan data selalu menjadi tantangan.
- Akurasi akan menurun ketika nilai-nilai yang mustahil, tidak mungkin, dan tidak lengkap dimasukkan sebagai data pelatihan.
- Jika pakar yang bersangkutan tidak tersedia, maka pendekatan lain adalah "brute-force." Artinya, Anda harus menebak fitur mana (variabel input) yang akan digunakan untuk melatih mesin, dan tebakan tersebut bisa saja tidak akurat.
Keuntungan Pembelajaran yang Diawasi
Dengan mempertimbangkan tantangan-tantangan tersebut, berikut adalah keunggulan pembelajaran mesin terawasi:
- Pembelajaran yang diawasi di Pembelajaran mesin Memungkinkan Anda untuk mengumpulkan data atau menghasilkan keluaran data dari pengalaman sebelumnya.
- Membantu Anda mengoptimalkan kriteria kinerja menggunakan pengalaman
- Pembelajaran mesin yang diawasi membantu Anda memecahkan berbagai jenis masalah komputasi dunia nyata.
Kekurangan Pembelajaran yang Diawasi
Berikut adalah kekurangan dari pembelajaran mesin terawasi:
- Batas keputusan mungkin mengalami overtraining jika set data pelatihan Anda tidak memiliki contoh yang ingin Anda miliki dalam suatu kelas.
- Anda perlu memilih banyak contoh bagus dari setiap kelas saat Anda melatih pengklasifikasi.
- Mengklasifikasikan data besar bisa menjadi tantangan yang nyata.
- Pelatihan untuk pembelajaran yang diawasi membutuhkan banyak waktu komputasi.
Praktik Terbaik untuk Pembelajaran Terawasi
Urutan berikut ini menjaga agar proyek tetap berjalan. track:
- Sebelum melakukan hal lain, tentukan jenis data apa yang akan digunakan sebagai set pelatihan.
- Tentukan struktur fungsi yang dipelajari dan algoritma pembelajarannya.
- Kumpulkan hasil yang relevan baik dari pakar manusia maupun dari pengukuran.
- Sisihkan satu set data uji yang tidak pernah dilihat oleh model, dan laporkan skornya.
