
Model Seq2seq (Sequence to Sequence) dengan PyTorch
 Evelyn Clarke
⚡ Ringkasan Cerdas
Seq2Seq adalah arsitektur encoder-decoder yang memetakan urutan input ke urutan output menggunakan dua jaringan saraf berulang, yang mendukung penerjemahan mesin dan tugas pemrosesan bahasa alami lainnya di mana panjang input dan output berbeda.
Apa itu NLP?
NLP atau Pemrosesan Bahasa Alami adalah salah satu cabang populer dari Kecerdasan Buatan yang membantu komputer memahami, memanipulasi, atau menanggapi manusia dalam bahasa alami mereka. NLP adalah mesin penggerak di balik Google Translate yang membantu kita memahami bahasa lain.
Apa itu Seq2Seq?
Seq2Seq adalah metode terjemahan mesin dan pemrosesan bahasa berbasis encoder-decoder yang memetakan input urutan ke output urutan dengan tag dan nilai perhatian. Idenya adalah menggunakan 2 RNN yang akan bekerja sama dengan token khusus dan mencoba memprediksi urutan keadaan berikutnya dari urutan sebelumnya.
Cara Memprediksi sequence dari sequence sebelumnya
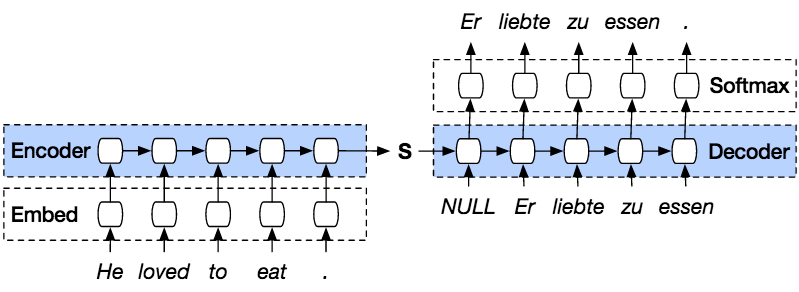
Berikut adalah langkah-langkah untuk memprediksi urutan dari urutan sebelumnya menggunakan Python.Torch.
Langkah 1) Memuat Data kami
Untuk kumpulan data kami, Anda akan menggunakan kumpulan data dari Pasangan Kalimat Bilingual yang dibatasi tab. Disini saya akan menggunakan dataset Bahasa Inggris ke Bahasa Indonesia. Anda dapat memilih apa pun yang Anda suka tetapi ingatlah untuk mengubah nama file dan direktori dalam kode.
from __future__ import unicode_literals, print_function, division
import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as F

import numpy as np
import pandas as pd

import os
import re
import random

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
Langkah 2) Persiapan Data
Anda tidak dapat menggunakan dataset secara langsung. Anda perlu memisahkan kalimat menjadi kata-kata dan mengubahnya menjadi Vektor One-Hot. Setiap kata akan diindeks secara unik di kelas Lang untuk membuat kamus. Kelas Lang akan menyimpan setiap kalimat dan memisahkannya kata demi kata dengan addSentence. Kemudian buat kamus dengan mengindeks setiap kata yang tidak dikenal untuk model Sequence to Sequence.
SOS_token = 0
EOS_token = 1
MAX_LENGTH = 20

#initialize Lang Class
class Lang:
   def __init__(self):
       #initialize containers to hold the words and corresponding index
       self.word2index = {}
       self.word2count = {}
       self.index2word = {0: "SOS", 1: "EOS"}
       self.n_words = 2  # Count SOS and EOS

#split a sentence into words and add it to the container
   def addSentence(self, sentence):
       for word in sentence.split(' '):
           self.addWord(word)

#If the word is not in the container, the word will be added to it, else, update the word counter
   def addWord(self, word):
       if word not in self.word2index:
           self.word2index[word] = self.n_words
           self.word2count[word] = 1
           self.index2word[self.n_words] = word
           self.n_words += 1
       else:
           self.word2count[word] += 1
Kelas Lang adalah kelas yang akan membantu kita membuat kamus. Untuk setiap bahasa, setiap kalimat akan dipecah menjadi kata-kata dan kemudian ditambahkan ke dalam kontainer. Setiap kontainer akan menyimpan kata-kata dalam indeks yang sesuai, menghitung jumlah kata, dan menambahkan indeks kata tersebut sehingga kita dapat menggunakannya untuk menemukan indeks suatu kata atau menemukan kata dari indeksnya.
Karena data kami dipisahkan oleh TAB, Anda perlu menggunakan panda Sebagai pemuat data kita, Pandas akan membaca data kita sebagai dataFrame dan membaginya menjadi kalimat sumber dan kalimat target. Untuk setiap kalimat yang Anda miliki, Anda akan menormalkannya menjadi huruf kecil, menghapus semua karakter non-karakter, mengonversi ke ASCII dari Unicode, dan membagi kalimat sehingga Anda memiliki setiap kata di dalamnya.
#Normalize every sentence
def normalize_sentence(df, lang):
   sentence = df[lang].str.lower()
   sentence = sentence.str.replace('[^A-Za-z\s]+', '')
   sentence = sentence.str.normalize('NFD')
   sentence = sentence.str.encode('ascii', errors='ignore').str.decode('utf-8')
   return sentence

def read_sentence(df, lang1, lang2):
   sentence1 = normalize_sentence(df, lang1)
   sentence2 = normalize_sentence(df, lang2)
   return sentence1, sentence2

def read_file(loc, lang1, lang2):
   df = pd.read_csv(loc, delimiter='\t', header=None, names=[lang1, lang2])
   return df

def process_data(lang1,lang2):
   df = read_file('text/%s-%s.txt' % (lang1, lang2), lang1, lang2)
   print("Read %s sentence pairs" % len(df))
   sentence1, sentence2 = read_sentence(df, lang1, lang2)

   source = Lang()
   target = Lang()
   pairs = []
   for i in range(len(df)):
       if len(sentence1[i].split(' ')) < MAX_LENGTH and len(sentence2[i].split(' ')) < MAX_LENGTH:
           full = [sentence1[i], sentence2[i]]
           source.addSentence(sentence1[i])
           target.addSentence(sentence2[i])
           pairs.append(full)

   return source, target, pairs
Fungsi berguna lainnya yang akan Anda gunakan adalah mengkonversi pasangan menjadi Tensor. Ini sangat penting karena jaringan kita hanya membaca data tipe tensor. Ini juga penting karena di bagian inilah, di setiap akhir kalimat, akan ada token untuk memberi tahu jaringan bahwa input telah selesai. Untuk setiap kata dalam kalimat, jaringan akan mengambil indeks dari kata yang sesuai dalam kamus dan menambahkan token di akhir kalimat.
def indexesFromSentence(lang, sentence):
   return [lang.word2index[word] for word in sentence.split(' ')]

def tensorFromSentence(lang, sentence):
   indexes = indexesFromSentence(lang, sentence)
   indexes.append(EOS_token)
   return torch.tensor(indexes, dtype=torch.long, device=device).view(-1, 1)

def tensorsFromPair(input_lang, output_lang, pair):
   input_tensor = tensorFromSentence(input_lang, pair[0])
   target_tensor = tensorFromSentence(output_lang, pair[1])
   return (input_tensor, target_tensor)
Model Seq2Seq

PyTorModel ch Seq2seq adalah jenis model yang menggunakan PyTorModel ini menggunakan encoder dan decoder. Encoder akan mengkodekan kalimat kata demi kata ke dalam indeks kosakata atau kata-kata yang dikenal dengan indeks tertentu, dan decoder akan memprediksi output dari input yang telah dikodekan dengan mendekode input secara berurutan dan akan mencoba menggunakan input terakhir sebagai input berikutnya jika memungkinkan. Dengan metode ini, dimungkinkan juga untuk memprediksi input berikutnya untuk membuat kalimat. Setiap kalimat akan diberi token untuk menandai akhir urutan. Di akhir prediksi, akan ada juga token untuk menandai akhir output. Jadi, dari encoder, akan diteruskan sebuah state ke decoder untuk memprediksi output.

Encoder akan mengkodekan kalimat masukan kita kata demi kata secara berurutan, dan pada akhirnya akan ada token untuk menandai akhir kalimat. Encoder terdiri dari lapisan Embedding dan lapisan GRU. Lapisan Embedding adalah tabel pencarian yang menyimpan embedding masukan kita ke dalam kamus kata berukuran tetap. Embedding ini akan diteruskan ke lapisan GRU. Lapisan GRU adalah Gated Recurrent Unit yang terdiri dari beberapa lapisan tipe RNN yang akan menghitung input berurutan. Lapisan ini akan menghitung keadaan tersembunyi dari yang sebelumnya dan memperbarui reset, pembaruan, dan gerbang baru.

Decoder akan menerjemahkan input dari output encoder. Ia akan mencoba memprediksi output berikutnya dan mencoba menggunakannya sebagai input berikutnya jika memungkinkan. Decoder terdiri dari lapisan Embedding, lapisan GRU, dan lapisan Linear. Lapisan embedding akan membuat tabel pencarian untuk output dan meneruskannya ke lapisan GRU untuk menghitung keadaan output yang diprediksi. Setelah itu, lapisan Linear akan membantu menghitung fungsi aktivasi untuk menentukan nilai sebenarnya dari output yang diprediksi.
class Encoder(nn.Module):
   def __init__(self, input_dim, hidden_dim, embbed_dim, num_layers):
       super(Encoder, self).__init__()

       #set the encoder input dimesion , embbed dimesion, hidden dimesion, and number of layers
       self.input_dim = input_dim
       self.embbed_dim = embbed_dim
       self.hidden_dim = hidden_dim
       self.num_layers = num_layers

       #initialize the embedding layer with input and embbed dimention
       self.embedding = nn.Embedding(input_dim, self.embbed_dim)
       #intialize the GRU to take the input dimetion of embbed, and output dimention of hidden and
       #set the number of gru layers
       self.gru = nn.GRU(self.embbed_dim, self.hidden_dim, num_layers=self.num_layers)

   def forward(self, src):
       embedded = self.embedding(src).view(1,1,-1)
       outputs, hidden = self.gru(embedded)
       return outputs, hidden

class Decoder(nn.Module):
   def __init__(self, output_dim, hidden_dim, embbed_dim, num_layers):
       super(Decoder, self).__init__()

#set the encoder output dimension, embed dimension, hidden dimension, and number of layers
       self.embbed_dim = embbed_dim
       self.hidden_dim = hidden_dim
       self.output_dim = output_dim
       self.num_layers = num_layers

# initialize every layer with the appropriate dimension. For the decoder layer, it will consist of an embedding, GRU, a Linear layer and a Log softmax activation function.
       self.embedding = nn.Embedding(output_dim, self.embbed_dim)
       self.gru = nn.GRU(self.embbed_dim, self.hidden_dim, num_layers=self.num_layers)
       self.out = nn.Linear(self.hidden_dim, output_dim)
       self.softmax = nn.LogSoftmax(dim=1)

   def forward(self, input, hidden):
# reshape the input to (1, batch_size)
       input = input.view(1, -1)
       embedded = F.relu(self.embedding(input))
       output, hidden = self.gru(embedded, hidden)
       prediction = self.softmax(self.out(output[0]))
       return prediction, hidden

class Seq2Seq(nn.Module):
   def __init__(self, encoder, decoder, device, MAX_LENGTH=MAX_LENGTH):
       super().__init__()

#initialize the encoder and decoder
       self.encoder = encoder
       self.decoder = decoder
       self.device = device

   def forward(self, source, target, teacher_forcing_ratio=0.5):
       input_length = source.size(0) #get the input length (number of words in sentence)
       batch_size = target.shape[1]
       target_length = target.shape[0]
       vocab_size = self.decoder.output_dim

#initialize a variable to hold the predicted outputs
       outputs = torch.zeros(target_length, batch_size, vocab_size).to(self.device)

#encode every word in a sentence
       for i in range(input_length):
           encoder_output, encoder_hidden = self.encoder(source[i])

#use the encoder's hidden layer as the decoder hidden
       decoder_hidden = encoder_hidden.to(device)

#add a token before the first predicted word
       decoder_input = torch.tensor([SOS_token], device=device)  # SOS

#topk is used to get the top K value over a list
#predict the output word from the current target word. If we enable the teaching force, then the next decoder input is the next word, else, use the decoder output highest value.
       for t in range(target_length):
           decoder_output, decoder_hidden = self.decoder(decoder_input, decoder_hidden)
           outputs[t] = decoder_output
           teacher_force = random.random() < teacher_forcing_ratio
           topv, topi = decoder_output.topk(1)
           input = (target[t] if teacher_force else topi)
           if(teacher_force == False and input.item() == EOS_token):
               break

       return outputs
Langkah 3) Melatih Model
Proses pelatihan pada model Seq2seq dimulai dengan mengkonversi setiap pasangan kalimat menjadi Tensor berdasarkan indeks Lang-nya. Model sequence-to-sequence kita akan menggunakan SGD sebagai optimizer dan fungsi NLLLoss untuk menghitung loss. Proses pelatihan dimulai dengan memasukkan pasangan kalimat ke dalam model untuk memprediksi output yang benar. Pada setiap langkah, output dari model akan dihitung dengan kata-kata sebenarnya untuk menemukan loss dan memperbarui parameter. Karena kita akan menggunakan 75000 iterasi, model sequence-to-sequence kita akan menghasilkan 75000 pasangan acak dari dataset kita.
teacher_forcing_ratio = 0.5

def clacModel(model, input_tensor, target_tensor, model_optimizer, criterion):
   model_optimizer.zero_grad()

   input_length = input_tensor.size(0)
   loss = 0
   epoch_loss = 0
   # print(input_tensor.shape)

   output = model(input_tensor, target_tensor)

   num_iter = output.size(0)
   print(num_iter)

#calculate the loss from a predicted sentence with the expected result
   for ot in range(num_iter):
       loss += criterion(output[ot], target_tensor[ot])

   loss.backward()
   model_optimizer.step()
   epoch_loss = loss.item() / num_iter

   return epoch_loss

def trainModel(model, source, target, pairs, num_iteration=20000):
   model.train()

   optimizer = optim.SGD(model.parameters(), lr=0.01)
   criterion = nn.NLLLoss()
   total_loss_iterations = 0

   training_pairs = [tensorsFromPair(source, target, random.choice(pairs))
                     for i in range(num_iteration)]

   for iter in range(1, num_iteration+1):
       training_pair = training_pairs[iter - 1]
       input_tensor = training_pair[0]
       target_tensor = training_pair[1]

       loss = clacModel(model, input_tensor, target_tensor, optimizer, criterion)

       total_loss_iterations += loss

       if iter % 5000 == 0:
           avarage_loss= total_loss_iterations / 5000
           total_loss_iterations = 0
           print('%d %.4f' % (iter, avarage_loss))

   torch.save(model.state_dict(), 'mytraining.pt')
   return model
Langkah 4) Uji Modelnya
Proses evaluasi Seq2seq PyTorLangkah selanjutnya adalah memeriksa output model. Setiap pasangan model Sequence to Sequence akan dimasukkan ke dalam model dan menghasilkan kata-kata yang diprediksi. Setelah itu, Anda akan melihat nilai tertinggi pada setiap output untuk menemukan indeks yang benar. Dan pada akhirnya, Anda akan membandingkannya untuk melihat prediksi model kita dengan kalimat sebenarnya.
def evaluate(model, input_lang, output_lang, sentences, max_length=MAX_LENGTH): with torch.no_grad(): input_tensor = tensorFromSentence(input_lang, sentences[0]) output_tensor = tensorFromSentence(output_lang, sentences[1]) decoded_words = [] output = model(input_tensor, output_tensor) # print(output_tensor) for ot in range(output.size(0)): topv, topi = output[ot].topk(1) # print(topi) if topi[0].item() == EOS_token: decoded_words.append('' ) break else: decoded_words.append(output_lang.index2word[topi[0].item()]) return decoded_words def evaluateRandomly(model, source, target, pairs, n=10): for i in range(n): pair = random.choice(pairs) print('source {}'.format(pair[0])) print('target {}'.format(pair[1])) output_words = evaluate(model, source, target, pair) output_sentence = ' '.join(output_words) print('predicted {}'.format(output_sentence))
Sekarang, mari kita mulai pelatihan kita dengan Seq to Seq, dengan jumlah iterasi 75000 dan jumlah lapisan RNN sebanyak 1 dengan ukuran hidden 512.
lang1 = 'eng'
lang2 = 'ind'
source, target, pairs = process_data(lang1, lang2)

randomize = random.choice(pairs)
print('random sentence {}'.format(randomize))

#print number of words
input_size = source.n_words
output_size = target.n_words
print('Input : {} Output : {}'.format(input_size, output_size))

embed_size = 256
hidden_size = 512
num_layers = 1
num_iteration = 100000

#create encoder-decoder model
encoder = Encoder(input_size, hidden_size, embed_size, num_layers)
decoder = Decoder(output_size, hidden_size, embed_size, num_layers)

model = Seq2Seq(encoder, decoder, device).to(device)

#print model
print(encoder)
print(decoder)

model = trainModel(model, source, target, pairs, num_iteration)
evaluateRandomly(model, source, target, pairs)
Seperti yang Anda lihat, kalimat prediksi kami tidak terlalu cocok, jadi untuk mendapatkan akurasi yang lebih tinggi, Anda perlu berlatih dengan lebih banyak data dan mencoba menambahkan lebih banyak iterasi dan jumlah lapisan menggunakan pembelajaran Sequence to sequence.
random sentence ['tom is finishing his work', 'tom sedang menyelesaikan pekerjaannya']
Input : 3551 Output : 4253
Encoder(
  (embedding): Embedding(3551, 256)
  (gru): GRU(256, 512)
)
Decoder(
  (embedding): Embedding(4253, 256)
  (gru): GRU(256, 512)
  (out): Linear(in_features=512, out_features=4253, bias=True)
  (softmax): LogSoftmax()
)
5000 4.0906
10000 3.9129
15000 3.8171
20000 3.8369
25000 3.8199
30000 3.7957
75000 3.7044
