
Tutorial Scikit-Learn: Cara Install & Contoh Scikit-Learn
 Evelyn Clarke
⚡ Ringkasan Cerdas
Scikit-learn adalah perangkat lunak sumber terbuka. Python Sebuah pustaka yang mencakup pra-pemrosesan, klasifikasi, regresi, pengelompokan, dan pemilihan model di balik antarmuka estimator tunggal yang konsisten, yang menjaga alur kerja pembelajaran mesin yang lengkap tetap singkat, mudah dibaca, dan dapat direproduksi dari data mentah hingga prediksi yang diberi skor.
Apa itu Scikit-belajar?
Scikit-belajar adalah sumber terbuka Python perpustakaan untuk Mesin belajarIni mendukung algoritma yang sudah mapan seperti KNN, gradient boosting, random forest, dan SVM, dan dibangun di atas JumlahPy dan SciPy. Scikit-learn banyak digunakan dalam kompetisi Kaggle serta di perusahaan teknologi terkemuka. Scikit-learn mencakup pra-pemrosesan, pengurangan dimensi, klasifikasi, regresi, pengelompokan, dan pemilihan model.
Scikit-learn memiliki dokumentasi terbaik dibandingkan pustaka sumber terbuka lainnya. Bahkan menyediakan grafik estimasi interaktif, Memilih estimator yang tepat, yang memandu Anda dari ukuran dataset Anda hingga daftar singkat algoritma yang layak dicoba.
Gambar di bawah ini mengilustrasikan cara kerja Scikit-learn.
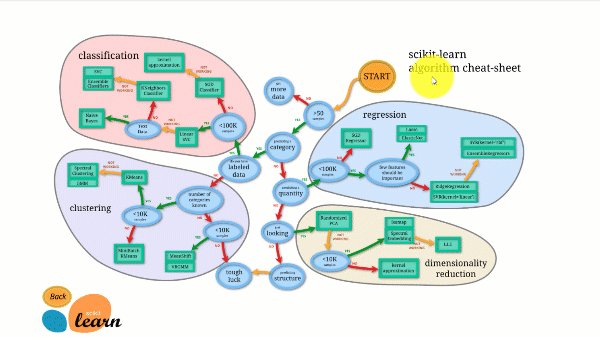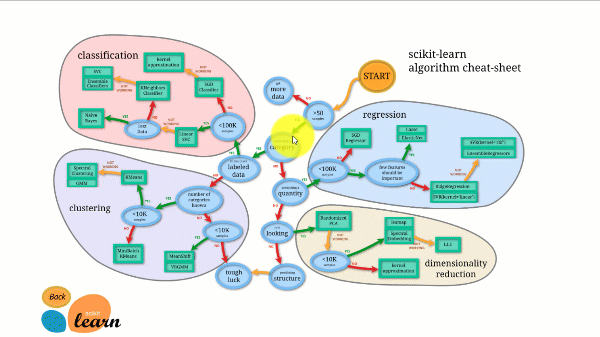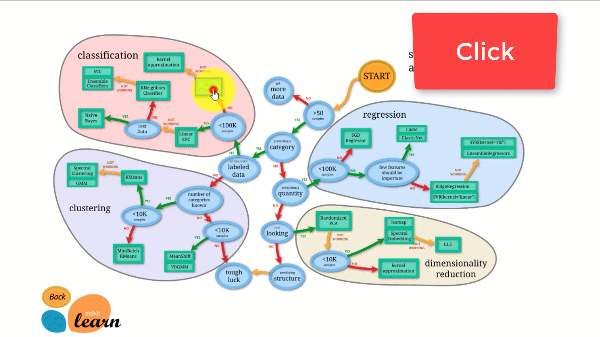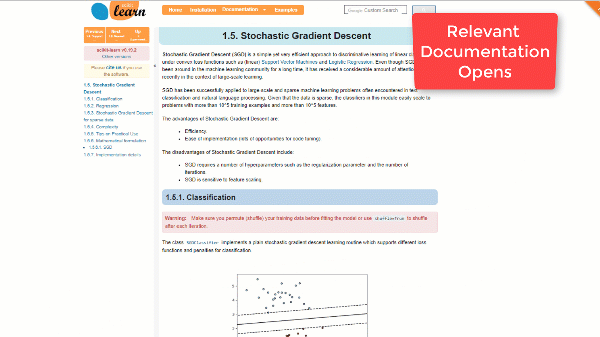
Scikit-learn tidak sulit digunakan dan memberikan hasil yang sangat baik. Namun, ia melakukan pelatihan pada CPU: pekerjaan diparalelkan di seluruh inti dengan argumen n_jobs, bukan pada GPU. Menjalankan algoritma pembelajaran mendalam dengannya dimungkinkan tetapi jarang optimal, terutama jika Anda sudah tahu cara menggunakannya. TensorFlow.
Cara Mengunduh dan Menginstal Scikit-learn
Sekarang dalam hal ini Python Tutorial Scikit-learn, Anda akan mempelajari cara mengunduh dan menginstal Scikit-learn:
Opsi 1: AWS
Scikit-learn dapat digunakan di AWS. Citra Docker dengan scikit-learn yang sudah terinstal sebelumnya akan menghemat seluruh pekerjaan penyiapan.
Untuk menginstal versi pengembang, jalankan perintah di bawah ini di dalam Jupyter:
import sys
!{sys.executable} -m pip install git+git://github.com/scikit-learn/scikit-learn.git
Opsi 2: Mac atau Windows menggunakan Anaconda
Untuk mempelajari tentang instalasi Anaconda, lihat Cara mengunduh dan menginstal TensorFlow.
Pada saat panduan ini ditulis, pengembang scikit telah merilis versi pengembangan yang memperbaiki masalah yang ada pada rilis saat itu, jadi langkah-langkah di bawah ini menggunakan versi pengembangan tersebut. Pada mesin baru saat ini, rilis stabil terbaru sudah berisi setiap transformer yang digunakan di sini, dan pip install -U scikit-learn cukup.
Cara Menginstal scikit-learn dengan Conda Environment
Jika Anda menginstal scikit-learn menggunakan lingkungan conda, ikuti langkah-langkah di bawah ini untuk memperbarui ke versi 0.20.
Langkah 1) Aktifkan lingkungan TensorFlow
source activate hello-tf
Langkah 2) Hapus scikit-learn menggunakan perintah conda
conda remove scikit-learn
Langkah 3) Instal versi pengembang
Instal versi pengembang scikit-learn beserta pustaka yang diperlukan.
conda install -c anaconda git
pip install Cython
pip install h5py
pip install git+git://github.com/scikit-learn/scikit-learn.git
CATATAN: Windows pengguna membutuhkan Microsoft visual C++ 14. Kamu bisa mendapatkannya di sini.
Contoh Scikit-Learn dengan Machine Learning
Tutorial Scikit ini dibagi menjadi dua bagian:
- Pembelajaran mesin dengan scikit-learn
- Bagaimana memercayai model Anda dengan LIME
Bagian pertama menjelaskan cara membangun pipeline, membuat model, dan menyetel hyperparameter, sedangkan bagian kedua membahas interpretasi model.
Langkah 1) Impor data
Selama tutorial Scikit learn ini, Anda akan menggunakan dataset sensus dewasa.
File tersebut dibaca langsung dari UCI Machine Learning Repository dalam kode di bawah ini, jadi tidak perlu pengunduhan manual. Jika Anda tertarik dengan statistik deskriptif, alat Dive dan Overview layak untuk dilihat. Lihat tutorial ini Untuk mempelajari lebih lanjut tentang Dive dan Gambaran Umum.
Anda mengimpor dataset dengan pandas. Perhatikan bahwa Anda perlu mengkonversi variabel kontinu ke format float.
Dataset ini mencakup delapan variabel kategorikal, yang tercantum dalam CATE_FEATURES:
- kelas kerja
- pendidikan
- perkawinan
- pekerjaan
- hubungan
- ras
- seks
- negara Asal
Ini juga mencakup enam variabel kontinu, yang tercantum dalam CONTI_FEATURES:
- usia
- fnlwgt
- pendidikan_num
- keuntungan dalam bentuk uang
- modal_rugi
- jam_minggu
Daftar ini diisi secara manual agar Anda memiliki gambaran yang lebih jelas tentang kolom mana yang digunakan. Cara yang lebih cepat untuk membuat daftar kolom kategorikal atau kontinu adalah:
## List Categorical
CATE_FEATURES = df_train.iloc[:,:-1].select_dtypes('object').columns
print(CATE_FEATURES)

## List continuous
CONTI_FEATURES =  df_train._get_numeric_data()
print(CONTI_FEATURES)
Berikut kode untuk mengimpor data:
# Import dataset
import pandas as pd

## Define path data
COLUMNS = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital',
           'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss',
           'hours_week', 'native_country', 'label']
### Define continuous list
CONTI_FEATURES  = ['age', 'fnlwgt','capital_gain', 'education_num', 'capital_loss', 'hours_week']
### Define categorical list
CATE_FEATURES = ['workclass', 'education', 'marital', 'occupation', 'relationship', 'race', 'sex', 'native_country']

## Prepare the data
features = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital',
           'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss',
           'hours_week', 'native_country']

PATH = "https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.data"

df_train = pd.read_csv(PATH, skipinitialspace=True, names = COLUMNS, index_col=False)
df_train[CONTI_FEATURES] =df_train[CONTI_FEATURES].astype('float64')
df_train.describe()
Memanggil fungsi describe() pada frame akan mengembalikan statistik ringkasan untuk enam kolom kontinu:
| usia | fnlwgt | pendidikan_num | keuntungan dalam bentuk uang | modal_rugi | jam_minggu | |
|---|---|---|---|---|---|---|
| menghitung | 32561.000000 | 3.256100e + 04 | 32561.000000 | 32561.000000 | 32561.000000 | 32561.000000 |
| berarti | 38.581647 | 1.897784e + 05 | 10.080679 | 1077.648844 | 87.303830 | 40.437456 |
| std | 13.640433 | 1.055500e + 05 | 2.572720 | 7385.292085 | 402.960219 | 12.347429 |
| menit | 17.000000 | 1.228500e + 04 | 1.000000 | 0.000000 | 0.000000 | 1.000000 |
| 25% | 28.000000 | 1.178270e + 05 | 9.000000 | 0.000000 | 0.000000 | 40.000000 |
| 50% | 37.000000 | 1.783560e + 05 | 10.000000 | 0.000000 | 0.000000 | 40.000000 |
| 75% | 48.000000 | 2.370510e + 05 | 12.000000 | 0.000000 | 0.000000 | 45.000000 |
| max | 90.000000 | 1.484705e + 06 | 16.000000 | 99999.000000 | 4356.000000 | 99.000000 |
Anda dapat memeriksa jumlah nilai unik dari fitur native_country. Hanya satu rumah tangga yang berasal dari Belanda. Rumah tangga tersebut tidak membawa informasi apa pun dan akan menimbulkan kesalahan selama pelatihan.
df_train.native_country.value_counts()
United-States                 29170
Mexico                          643
?                               583
Philippines                     198
Germany                         137
Canada                          121
Puerto-Rico                     114
El-Salvador                     106
India                           100
Cuba                             95
England                          90
Jamaica                          81
South                            80
China                            75
Italy                            73
Dominican-Republic               70
Vietnam                          67
Guatemala                        64
Japan                            62
Poland                           60
Columbia                         59
Taiwan                           51
Haiti                            44
Iran                             43
Portugal                         37
Nicaragua                        34
Peru                             31
France                           29
Greece                           29
Ecuador                          28
Ireland                          24
Hong                             20
Cambodia                         19
Trinadad&Tobago                  19
Thailand                         18
Laos                             18
Yugoslavia                       16
Outlying-US(Guam-USVI-etc)       14
Honduras                         13
Hungary                          13
Scotland                         12
Holand-Netherlands                1
Name: native_country, dtype: int64
Anda dapat mengecualikan baris yang tidak informatif ini dari kumpulan data:
## Drop Netherland, because only one row
df_train = df_train[df_train.native_country != "Holand-Netherlands"]
Selanjutnya, Anda menyimpan posisi fitur berkelanjutan dalam daftar. Anda akan membutuhkannya pada langkah berikutnya untuk membangun saluran pipa.
Kode di bawah ini mengulang semua nama kolom dalam CONTI_FEATURES, membaca setiap lokasi (yaitu, nomor kolomnya) dan menambahkannya ke daftar yang disebut conti_features.
## Get the column index of the categorical features
conti_features = []
for i in CONTI_FEATURES:
    position = df_train.columns.get_loc(i)
    conti_features.append(position)
print(conti_features)
[0, 2, 10, 4, 11, 12]
Blok berikutnya melakukan pekerjaan yang sama untuk variabel kategorikal.
## Get the column index of the categorical features
categorical_features = []
for i in CATE_FEATURES:
    position = df_train.columns.get_loc(i)
    categorical_features.append(position)
print(categorical_features)
[1, 3, 5, 6, 7, 8, 9, 13]
Sekarang mari kita lihat dataset itu sendiri. Setiap fitur kategorikal berupa string, dan sebuah model tidak dapat diberi nilai string, jadi dataset harus ditransformasikan dengan variabel dummy.
df_train.head(5)
Sebenarnya, Anda membutuhkan satu kolom untuk setiap grup di setiap fitur. Pertama, jalankan kode di bawah ini untuk menghitung jumlah total kolom yang dibutuhkan.
print(df_train[CATE_FEATURES].nunique(),
      'There are',sum(df_train[CATE_FEATURES].nunique()), 'groups in the whole dataset')
workclass          9
education         16
marital            7
occupation        15
relationship       6
race               5
sex                2
native_country    41
dtype: int64 There are 101 groups in the whole dataset
Seluruh dataset berisi 101 grup, seperti yang ditunjukkan di atas. Fitur kelas kerja saja memiliki sembilan grup. Anda dapat mencantumkan nama-nama grup dengan kode di bawah ini; unique() mengembalikan nilai unik dari setiap fitur kategorikal.
for i in CATE_FEATURES:
    print(df_train[i].unique())
['State-gov' 'Self-emp-not-inc' 'Private' 'Federal-gov' 'Local-gov' '?'
 'Self-emp-inc' 'Without-pay' 'Never-worked']
['Bachelors' 'HS-grad' '11th' 'Masters' '9th' 'Some-college' 'Assoc-acdm'
 'Assoc-voc' '7th-8th' 'Doctorate' 'Prof-school' '5th-6th' '10th'
 '1st-4th' 'Preschool' '12th']
['Never-married' 'Married-civ-spouse' 'Divorced' 'Married-spouse-absent'
 'Separated' 'Married-AF-spouse' 'Widowed']
['Adm-clerical' 'Exec-managerial' 'Handlers-cleaners' 'Prof-specialty'
 'Other-service' 'Sales' 'Craft-repair' 'Transport-moving'
 'Farming-fishing' 'Machine-op-inspct' 'Tech-support' '?'
 'Protective-serv' 'Armed-Forces' 'Priv-house-serv']
['Not-in-family' 'Husband' 'Wife' 'Own-child' 'Unmarried' 'Other-relative']
['White' 'Black' 'Asian-Pac-Islander' 'Amer-Indian-Eskimo' 'Other']
['Male' 'Female']
['United-States' 'Cuba' 'Jamaica' 'India' '?' 'Mexico' 'South'
 'Puerto-Rico' 'Honduras' 'England' 'Canada' 'Germany' 'Iran'
 'Philippines' 'Italy' 'Poland' 'Columbia' 'Cambodia' 'Thailand' 'Ecuador'
 'Laos' 'Taiwan' 'Haiti' 'Portugal' 'Dominican-Republic' 'El-Salvador'
 'France' 'Guatemala' 'China' 'Japan' 'Yugoslavia' 'Peru'
 'Outlying-US(Guam-USVI-etc)' 'Scotland' 'Trinadad&Tobago' 'Greece'
 'Nicaragua' 'Vietnam' 'Hong' 'Ireland' 'Hungary']
Oleh karena itu, dataset pelatihan akan berisi 101 + 6 kolom: grup one-hot ditambah enam fitur kontinu.
Scikit-learn dapat menangani konversi tersebut dalam dua langkah:
- Konversikan string tersebut menjadi ID. State-gov menjadi ID 1, Self-emp-not-inc menjadi ID 2, dan seterusnya. LabelEncoder melakukan ini untuk Anda.
- Pindahkan setiap ID ke kolom baru. Dataset ini memiliki 101 ID grup, sehingga akan ada 101 kolom yang menangkap setiap grup fitur kategorikal. Scikit-learn menyediakan OneHotEncoder untuk operasi ini.
Langkah 2) Buat set pelatihan/pengujian
Setelah dataset siap, bagilah menjadi 80/20: 80 persen untuk set pelatihan dan 20 persen untuk set pengujian.
Anda dapat menggunakan `train_test_split`. Argumen pertama adalah dataframe fitur dan argumen kedua adalah label. Anda mengatur ukuran set pengujian dengan `test_size`.
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(df_train[features],
                                                    df_train.label,
                                                    test_size = 0.2,
                                                    random_state=0)
X_train.head(5)
print(X_train.shape, X_test.shape)
(26048, 14) (6512, 14)
Langkah 3) Bangun saluran pipa
Pipeline ini mempermudah pemberian data yang konsisten ke model. Idenya adalah untuk memasukkan data mentah melalui satu objek yang melakukan setiap operasi secara berurutan.
Dengan dataset ini, Anda perlu menstandarisasi variabel kontinu dan mengkonversi variabel kategorikal. Setiap operasi dapat dilakukan di dalam pipeline: nilai yang hilang dapat diganti dengan nilai rata-rata atau median, dan variabel baru dapat dibuat.
Anda punya pilihan: memasukkan kedua proses secara manual (hard-coding), atau membangun pipeline. Hard-coding dapat menyebabkan kebocoran data uji ke dalam statistik yang disesuaikan dan menciptakan inkonsistensi dari waktu ke waktu, jadi pipeline adalah pilihan yang lebih baik.
from sklearn.preprocessing import StandardScaler, OneHotEncoder, LabelEncoder
from sklearn.compose import ColumnTransformer, make_column_transformer
from sklearn.pipeline import make_pipeline
from sklearn.linear_model import LogisticRegression
Pipeline tersebut melakukan dua operasi sebelum dimasukkan ke dalam pengklasifikasi logistik:
- Standarisasi variabel: StandardScaler()
- Konversikan fitur kategorikal: OneHotEncoder(sparse=False)
Anda melakukan kedua langkah tersebut dengan make_column_transformer. Saat panduan ini ditulis, fungsi tersebut belum ada dalam versi scikit-learn yang dirilis (0.19), itulah sebabnya versi pengembang digunakan; fungsi ini telah disertakan dalam setiap rilis stabil sejak versi 0.20.
Fungsi `make_column_transformer` cukup sederhana: Anda menentukan kolom mana yang akan ditransformasi dan transformasi mana yang akan diterapkan. Untuk menstandarisasi fitur kontinu, Anda memberikan parameter berikut:
- conti_features, StandardScaler() di dalam make_column_transformer
- conti_features: daftar kolom kontinu
- StandardScaler: menstandarisasi kolom-kolom tersebut
Objek OneHotEncoder di dalam make_column_transformer secara otomatis mengkodekan label.
preprocess = make_column_transformer(
    (conti_features, StandardScaler()),
    ### Need to be numeric not string to specify columns name
    (categorical_features, OneHotEncoder(sparse=False))
)
Catatan versi: Dua argumen dalam blok di atas telah berubah. Rilis terbaru mengharapkan transformator terlebih dahulu dan kolom kedua, dan jarang diganti namanya keluaran jarang di scikit-learn 1.2 dan dihapus di 1.4, jadi kode yang lebih baru berbunyi OneHotEncoder(sparse_output=False).
Anda dapat menguji apakah pipeline berfungsi dengan fit_transform. Outputnya harus memiliki bentuk 26048, 107.
preprocess.fit_transform(X_train).shape
(26048, 107)
Transformator data sudah siap. Anda membuat pipeline dengan make_pipeline, dan setelah data ditransformasikan, Anda memasukkannya ke dalam regresi logistik.
model = make_pipeline(
    preprocess,
    LogisticRegression())
Melatih model dengan scikit-learn sangat mudah: cukup panggil `fit` pada pipeline. Anda dapat mencetak akurasi dengan metode `score`.
model.fit(X_train, y_train)
print("logistic regression score: %f" % model.score(X_test, y_test))
logistic regression score: 0.850891
Terakhir, Anda dapat memprediksi kelas dengan predict_proba, yang mengembalikan probabilitas setiap kelas. Perhatikan bahwa kedua probabilitas tersebut jika dijumlahkan hasilnya satu.
model.predict_proba(X_test)
array([[0.83576663, 0.16423337],
       [0.94582765, 0.05417235],
       [0.64760587, 0.35239413],
       ...,
       [0.99639252, 0.00360748],
       [0.02072181, 0.97927819],
       [0.56781353, 0.43218647]])
Langkah 4) Menggunakan saluran pipa kami dalam pencarian grid
Menyetel hyperparameter, yaitu nilai-nilai yang menentukan struktur model, bisa jadi membosankan dan melelahkan.
Salah satu cara untuk mengevaluasi model adalah dengan mengubah ukuran set pelatihan dan mengukur kinerjanya, mengulangi latihan tersebut sepuluh kali untuk melihat sebaran skornya. Itu membutuhkan banyak pekerjaan manual.
Sebaliknya, scikit-learn menyediakan fungsi yang melakukan penyetelan parameter dan validasi silang untuk Anda.
Validasi silang
Validasi silang berarti bahwa selama pelatihan, himpunan data pelatihan dibagi sebanyak n kali menjadi beberapa bagian (fold) dan model dievaluasi sebanyak n kali. Jika cv diatur ke 10, model dilatih dan dievaluasi sepuluh kali. Pada setiap putaran, pengklasifikasi dilatih pada sembilan bagian (fold) yang dipilih secara acak dan bagian kesepuluh (fold) disimpan untuk evaluasi.
Pencarian kotak
Setiap pengklasifikasi memiliki hyperparameter yang perlu disetel. Anda dapat mencoba nilai satu per satu, atau mengatur grid parameter. Dokumentasi scikit-learn mencantumkan semua parameter yang diterima oleh pengklasifikasi logistik. Untuk menjaga agar pelatihan tetap cepat, contoh ini hanya menyetel parameter C, yang mengontrol regularisasi. Parameter ini harus positif, dan nilai kecil memberikan bobot lebih besar pada regularisasi.
Anda menggunakan objek GridSearchCV, yang menerima kamus berisi hyperparameter yang akan disetel. Cantumkan setiap hyperparameter diikuti dengan nilai yang ingin Anda coba. Untuk menyetel C, Anda menulis:
- 'logisticregression__C': [0.001, 0.01, 0.1, 1.0] — nama parameter didahului oleh nama pengklasifikasi dalam huruf kecil dan dua garis bawah.
Model ini akan mencoba empat nilai berbeda: 0.001, 0.01, 0.1, dan 1. Model ini dilatih dengan 10 lipatan (folds), yaitu cv=10.
from sklearn.model_selection import GridSearchCV
# Construct the parameter grid
param_grid = {
    'logisticregression__C': [0.001, 0.01,0.1, 1.0],
    }
Anda sekarang dapat melatih model menggunakan GridSearchCV dengan parameter grid dan cv.
# Train the model
grid_clf = GridSearchCV(model,
                        param_grid,
                        cv=10,
                        iid=False)
grid_clf.fit(X_train, y_train)
Keluaran:
GridSearchCV(cv=10, error_score='raise-deprecating',
       estimator=Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...ty='l2', random_state=None, solver='liblinear', tol=0.0001,
          verbose=0, warm_start=False))]),
       fit_params=None, iid=False, n_jobs=1,
       param_grid={'logisticregression__C': [0.001, 0.01, 0.1, 1.0]},
       pre_dispatch='2*n_jobs', refit=True, return_train_score='warn',
       scoring=None, verbose=0)
Catatan versi: itu iid Argumen yang terlihat pada output ini sudah usang di scikit-learn 0.22 dan dihapus di 0.24, jadi argumen tersebut sebaiknya dihilangkan dari panggilan GridSearchCV pada rilis terbaru.
Untuk mengakses parameter terbaik, Anda menggunakan best_params_.
grid_clf.best_params_
Keluaran:
{'logisticregression__C': 1.0}
Setelah melatih model dengan empat nilai regularisasi yang berbeda, parameter optimalnya adalah:
print("best logistic regression from grid search: %f" % grid_clf.best_estimator_.score(X_test, y_test))
regresi logistik terbaik dari pencarian grid: 0.850891
Untuk mengakses probabilitas yang diprediksi:
grid_clf.best_estimator_.predict_proba(X_test)
array([[0.83576677, 0.16423323],
       [0.9458291 , 0.0541709 ],
       [0.64760416, 0.35239584],
       ...,
       [0.99639224, 0.00360776],
       [0.02072033, 0.97927967],
       [0.56782222, 0.43217778]])
Model XGBoost dengan scikit-learn
Sekarang coba salah satu pengklasifikasi terkuat di pasaran. XGBoost adalah peningkatan gradient-boosting pada random forest. Latar belakang teorinya berada di luar cakupan pembahasan ini. Python Tutorial Scikit, tetapi perlu diingat bahwa XGBoost telah memenangkan banyak kompetisi Kaggle. Pada dataset berukuran rata-rata, performanya bisa sebaik algoritma deep learning, atau bahkan lebih baik.
Pengklasifikasi ini sulit dilatih karena mengekspos sejumlah besar parameter. Tentu saja, Anda dapat menggunakan GridSearchCV untuk memilih parameter tersebut untuk Anda.
Pilihan yang lebih baik di sini adalah RandomizedSearchCV. GridSearchCV menjadi lambat ketika grid besar, karena ruang pencarian bertambah dengan setiap parameter yang ditambahkan. Sebaliknya, RandomizedSearchCV mengambil sampel nilai setiap hyperparameter secara acak pada setiap iterasi, sehingga 1,000 iterasi mengevaluasi 1,000 kombinasi. Cara kerjanya hampir sama dengan GridSearchCV.
Anda perlu mengimpor xgboost. Jika pustaka belum terinstal, jalankan pip3 install xgboost, atau instal dari dalam file `pip install xgboost`. Jupyter buku catatan dengan:
use import sys
!{sys.executable} -m pip install xgboost
Kemudian impor pengklasifikasi dan dua pembantu pencarian:
import xgboost
from sklearn.model_selection import RandomizedSearchCV
from sklearn.model_selection import StratifiedKFold
Langkah selanjutnya dalam Scikit ini Python Tutorial ini bertujuan untuk menentukan parameter yang akan disetel. Dokumentasi resmi XGBoost mencantumkan semuanya. Demi tujuan tutorial ini, Python Dalam tutorial Sklearn, Anda hanya memilih dua hyperparameter dengan masing-masing dua nilai, karena XGBoost membutuhkan waktu lama untuk pelatihan dan setiap titik grid tambahan akan menambah waktu tunggu.
params = {
        'xgbclassifier__gamma': [0.5, 1],
        'xgbclassifier__max_depth': [3, 4]
        }
Kemudian Anda membuat pipeline baru dengan pengklasifikasi XGBoost dan 600 estimator. n_estimators sendiri dapat disesuaikan, dan nilai yang tinggi dapat menyebabkan overfitting. Anda dapat mencoba nilai lain, tetapi perlu diingat bahwa ini dapat memakan waktu berjam-jam. Setiap parameter lainnya tetap menggunakan nilai default-nya.
model_xgb = make_pipeline(
    preprocess,
    xgboost.XGBClassifier(
                          n_estimators=600,
                          objective='binary:logistic',
                          silent=True,
                          nthread=1)
)
Anda dapat meningkatkan validasi silang dengan validator silang Stratified K-Folds. Hanya tiga lipatan yang digunakan di sini untuk mempercepat komputasi, dengan sedikit penurunan kualitas; tingkatkan menjadi 5 atau 10 pada mesin Anda sendiri untuk hasil yang lebih baik. Model dilatih selama empat iterasi.
skf = StratifiedKFold(n_splits=3,
                      shuffle = True,
                      random_state = 1001)

random_search = RandomizedSearchCV(model_xgb,
                                   param_distributions=params,
                                   n_iter=4,
                                   scoring='accuracy',
                                   n_jobs=4,
                                   cv=skf.split(X_train, y_train),
                                   verbose=3,
                                   random_state=1001)
Pencarian acak sudah siap, jadi Anda dapat melatih modelnya.
#grid_xgb = GridSearchCV(model_xgb, params, cv=10, iid=False)
random_search.fit(X_train, y_train)
Fitting 3 folds for each of 4 candidates, totalling 12 fits
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8759645283888057, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8729701715996775, total= 1.0min
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8706519235199263, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8735460094437406, total= 1.3min
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8722791661868018, total=  57.7s
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8753886905447426, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8697304768486523, total= 1.3min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8740066797189912, total= 1.4min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8707671043538355, total= 1.0min
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8729701715996775, total= 1.2min
[Parallel(n_jobs=4)]: Done  10 out of  12 | elapsed:  3.6min remaining:   43.5s
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8736611770125533, total= 1.2min
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8692697535130154, total= 1.2min
[Parallel(n_jobs=4)]: Done  12 out of  12 | elapsed:  3.6min finished
/Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/sklearn/model_selection/_search.py:737: DeprecationWarning: The default of the `iid` parameter will change from True to False in version 0.22 and will be removed in 0.24. This will change numeric results when test-set sizes are unequal. DeprecationWarning)
RandomizedSearchCV(cv=<generator object _BaseKFold.split at 0x1101eb830>,
          error_score='raise-deprecating',
          estimator=Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...
       reg_alpha=0, reg_lambda=1, scale_pos_weight=1, seed=None,
       silent=True, subsample=1))]),
          fit_params=None, iid='warn', n_iter=4, n_jobs=4,
          param_distributions={'xgbclassifier__gamma': [0.5, 1], 'xgbclassifier__max_depth': [3, 4]},
          pre_dispatch='2*n_jobs', random_state=1001, refit=True,
          return_train_score='warn', scoring='accuracy', verbose=3)
Seperti yang Anda lihat, XGBoost memperoleh skor lebih baik daripada regresi logistik sebelumnya.
print("Best parameter", random_search.best_params_)
print("best logistic regression from grid search: %f" % random_search.best_estimator_.score(X_test, y_test))
Best parameter {'xgbclassifier__max_depth': 3, 'xgbclassifier__gamma': 0.5}
best logistic regression from grid search: 0.873157
random_search.best_estimator_.predict(X_test)
array(['<=50K', '<=50K', '<=50K', ..., '<=50K', '>50K', '<=50K'], dtype=object)
Buat DNN dengan MLPClassifier di scikit-learn
Terakhir, Anda dapat melatih jaringan saraf dengan scikit-learn itu sendiri. Metodenya sama seperti untuk pengklasifikasi lainnya, dan estimatornya adalah MLPClassifier.
from sklearn.neural_network import MLPClassifier
Jaringan di bawah ini didefinisikan dengan:
- pemecah Adam
- fungsi aktivasi ReLU
- Alfa = 0.0001
- Ukuran batch 150
- Dua lapisan tersembunyi dengan masing-masing 200 dan 100 neuron
model_dnn = make_pipeline(
    preprocess,
    MLPClassifier(solver='adam',
                  alpha=0.0001,
                  activation='relu',
                    batch_size=150,
                    hidden_layer_sizes=(200, 100),
                    random_state=1))
Anda dapat mengubah jumlah lapisan untuk meningkatkan model.
model_dnn.fit(X_train, y_train)
  print("DNN regression score: %f" % model_dnn.score(X_test, y_test))
Skor regresi DNN: 0.821253
LIME: Percayai Model Anda
Setelah Anda memiliki model yang bagus, Anda membutuhkan cara untuk mempercayainya. Algoritma pembelajaran mesin, terutama random forest dan jaringan saraf, dikenal sebagai model kotak hitam: algoritma tersebut berfungsi, tetapi tidak ada yang dapat melihat alasannya.
Tiga peneliti membangun sebuah alat yang menunjukkan bagaimana komputer mencapai suatu prediksi. Makalah mereka adalah... “Mengapa Aku Harus Mempercayaimu?”, dan algoritma yang mereka publikasikan disebut Local Interpretable Model-Agnostic Explanations (LIME).
Ambil contoh. Terkadang Anda tidak tahu apakah prediksi pembelajaran mesin dapat dipercaya. Seorang dokter tidak dapat menerima diagnosis hanya karena komputer yang menghasilkannya, dan Anda perlu mengetahui apakah model tersebut dapat diandalkan sebelum menerapkannya dalam produksi.
Bayangkan Anda dapat melihat mengapa pengklasifikasi mana pun membuat prediksi, bahkan untuk model serumit jaringan saraf, hutan acak, atau SVM dengan kernel sembarang. Akan jauh lebih mudah untuk mempercayai prediksi ketika alasan di baliknya terlihat, dan sama mudahnya untuk memutuskan kapan suatu model tidak dapat dipercaya. LIME memberi tahu Anda fitur mana yang mendorong keputusan pengklasifikasi tersebut.
Persiapan data
Ada beberapa hal yang perlu Anda ubah agar LIME dapat berjalan dengan baik. PythonPertama, pasang kapur di terminal dengan memasang pipa kapur.
Lime menggunakan objek LimeTabularExplainer untuk mendekati model secara lokal. Objek ini membutuhkan:
- kumpulan data di JumlahPy format
- Nama fitur: nama_fitur
- Nama kelas: nama_kelas
- Indeks kolom fitur kategorikal: fitur_kategoris
- Nama grup untuk setiap fitur kategorikal: categorical_names
Buatlah set kereta api NumPy.
Anda dapat menyalin dan mengkonversi df_train dari pandas ke NumPy dengan sangat mudah.
df_train.head(5)
# Create numpy data
df_lime = df_train
df_lime.head(3)
Dapatkan nama kelasnya
Label tersebut dapat diakses melalui unique(). Anda akan melihat:
- '<= 50K'
- '> 50K'
# Get the class name
class_names = df_lime.label.unique()
class_names
array(['<=50K', '>50K'], dtype=object)
Indeks kolom fitur kategorikal
Gunakan metode yang telah Anda pelajari sebelumnya untuk mendapatkan nama setiap grup. Anda mengkodekan label dengan LabelEncoder dan mengulangi operasi tersebut pada setiap fitur kategorikal.
##
import sklearn.preprocessing as preprocessing
categorical_names = {}
for feature in CATE_FEATURES:
    le = preprocessing.LabelEncoder()
    le.fit(df_lime[feature])
    df_lime[feature] = le.transform(df_lime[feature])
    categorical_names[feature] = le.classes_
print(categorical_names)
{'workclass': array(['?', 'Federal-gov', 'Local-gov', 'Never-worked', 'Private',
       'Self-emp-inc', 'Self-emp-not-inc', 'State-gov', 'Without-pay'],
      dtype=object), 'education': array(['10th', '11th', '12th', '1st-4th', '5th-6th', '7th-8th', '9th',
       'Assoc-acdm', 'Assoc-voc', 'Bachelors', 'Doctorate', 'HS-grad',
       'Masters', 'Preschool', 'Prof-school', 'Some-college'],
      dtype=object), 'marital': array(['Divorced', 'Married-AF-spouse', 'Married-civ-spouse',
       'Married-spouse-absent', 'Never-married', 'Separated', 'Widowed'],
      dtype=object), 'occupation': array(['?', 'Adm-clerical', 'Armed-Forces', 'Craft-repair',
       'Exec-managerial', 'Farming-fishing', 'Handlers-cleaners',
       'Machine-op-inspct', 'Other-service', 'Priv-house-serv',
       'Prof-specialty', 'Protective-serv', 'Sales', 'Tech-support',
       'Transport-moving'], dtype=object), 'relationship': array(['Husband', 'Not-in-family', 'Other-relative', 'Own-child',
       'Unmarried', 'Wife'], dtype=object), 'race': array(['Amer-Indian-Eskimo', 'Asian-Pac-Islander', 'Black', 'Other',
       'White'], dtype=object), 'sex': array(['Female', 'Male'], dtype=object), 'native_country': array(['?', 'Cambodia', 'Canada', 'China', 'Columbia', 'Cuba',
       'Dominican-Republic', 'Ecuador', 'El-Salvador', 'England',
       'France', 'Germany', 'Greece', 'Guatemala', 'Haiti', 'Honduras',
       'Hong', 'Hungary', 'India', 'Iran', 'Ireland', 'Italy', 'Jamaica',
       'Japan', 'Laos', 'Mexico', 'Nicaragua',
       'Outlying-US(Guam-USVI-etc)', 'Peru', 'Philippines', 'Poland',
       'Portugal', 'Puerto-Rico', 'Scotland', 'South', 'Taiwan',
       'Thailand', 'Trinadad&Tobago', 'United-States', 'Vietnam',
       'Yugoslavia'], dtype=object)}

df_lime.dtypes
age               float64
workclass           int64
fnlwgt            float64
education           int64
education_num     float64
marital             int64
occupation          int64
relationship        int64
race                int64
sex                 int64
capital_gain      float64
capital_loss      float64
hours_week        float64
native_country      int64
label              object
dtype: object
Sekarang setelah dataset siap, Anda dapat membuat berbagai dataset yang ditunjukkan dalam contoh Scikit learn di bawah ini. Data diubah di luar pipeline di sini untuk menghindari kesalahan dengan LIME: set pelatihan yang diberikan ke LimeTabularExplainer harus berupa array NumPy tanpa string, dan metode di atas telah menghasilkannya.
from sklearn.model_selection import train_test_split
X_train_lime, X_test_lime, y_train_lime, y_test_lime = train_test_split(df_lime[features],
                                                    df_lime.label,
                                                    test_size = 0.2,
                                                    random_state=0)
X_train_lime.head(5)
Anda dapat membuat pipeline dengan parameter optimal yang ditemukan oleh XGBoost.
model_xgb = make_pipeline(
    preprocess,
    xgboost.XGBClassifier(max_depth = 3,
                          gamma = 0.5,
                          n_estimators=600,
                          objective='binary:logistic',
                          silent=True,
                          nthread=1))

model_xgb.fit(X_train_lime, y_train_lime)
/Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/sklearn/preprocessing/_encoders.py:351: FutureWarning: The handling of integer data will change in version 0.22. Currently, the categories are determined based on the range [0, max(values)], while in the future they will be determined based on the unique values.
If you want the future behavior and silence this warning, you can specify "categories='auto'."In case you used a LabelEncoder before this OneHotEncoder to convert the categories to integers, then you can now use the OneHotEncoder directly.
  warnings.warn(msg, FutureWarning)
Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...
       reg_alpha=0, reg_lambda=1, scale_pos_weight=1, seed=None,
       silent=True, subsample=1))])
Anda mendapatkan peringatan. Peringatan tersebut menjelaskan bahwa Anda tidak perlu membuat label encoder sebelum pipeline. Jika Anda tidak menggunakan LIME, metode dari bagian pertama tutorial Machine Learning dengan Scikit-learn ini sudah tepat. Jika tidak, pertahankan pendekatan ini: pertama-tama buat dataset yang telah dienkode, kemudian terapkan one-hot encoder di dalam pipeline.
print("best logistic regression from grid search: %f" % model_xgb.score(X_test_lime, y_test_lime))
best logistic regression from grid search: 0.873157
model_xgb.predict_proba(X_test_lime)
array([[7.9646105e-01, 2.0353897e-01],
       [9.5173013e-01, 4.8269872e-02],
       [7.9344827e-01, 2.0655173e-01],
       ...,
       [9.9031430e-01, 9.6856682e-03],
       [6.4581633e-04, 9.9935418e-01],
       [9.7104281e-01, 2.8957171e-02]], dtype=float32)
Sebelum menggunakan LIME, buatlah array NumPy yang berisi fitur-fitur dari baris yang salah diklasifikasikan. Anda dapat menggunakan daftar tersebut nanti untuk mendapatkan gambaran tentang apa yang menyesatkan pengklasifikasi.
temp = pd.concat([X_test_lime, y_test_lime], axis= 1)
temp['predicted'] = model_xgb.predict(X_test_lime)
temp['wrong']=  temp['label'] != temp['predicted']
temp = temp.query('wrong==True').drop('wrong', axis=1)
temp= temp.sort_values(by=['label'])
temp.shape
(826, 16)
Kemudian, Anda membuat fungsi lambda yang mengambil prediksi dari model untuk data baru. Anda akan membutuhkannya sebentar lagi.
predict_fn = lambda x: model_xgb.predict_proba(x).astype(float)
X_test_lime.dtypes
age               float64
workclass           int64
fnlwgt            float64
education           int64
education_num     float64
marital             int64
occupation          int64
relationship        int64
race                int64
sex                 int64
capital_gain      float64
capital_loss      float64
hours_week        float64
native_country      int64
dtype: object
predict_fn(X_test_lime)
array([[7.96461046e-01, 2.03538969e-01],
       [9.51730132e-01, 4.82698716e-02],
       [7.93448269e-01, 2.06551731e-01],
       ...,
       [9.90314305e-01, 9.68566816e-03],
       [6.45816326e-04, 9.99354184e-01],
       [9.71042812e-01, 2.89571714e-02]])
Anda mengkonversi dataframe pandas menjadi array NumPy.
X_train_lime = X_train_lime.values
X_test_lime = X_test_lime.values
X_test_lime
array([[4.00000e+01, 5.00000e+00, 1.93524e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       [2.70000e+01, 4.00000e+00, 2.16481e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       [2.50000e+01, 4.00000e+00, 2.56263e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       ...,
       [2.80000e+01, 6.00000e+00, 2.11032e+05, ..., 0.00000e+00,
        4.00000e+01, 2.50000e+01],
       [4.40000e+01, 4.00000e+00, 1.67005e+05, ..., 0.00000e+00,
        6.00000e+01, 3.80000e+01],
       [5.30000e+01, 4.00000e+00, 2.57940e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01]])
model_xgb.predict_proba(X_test_lime)
array([[7.9646105e-01, 2.0353897e-01],
       [9.5173013e-01, 4.8269872e-02],
       [7.9344827e-01, 2.0655173e-01],
       ...,
       [9.9031430e-01, 9.6856682e-03],
       [6.4581633e-04, 9.9935418e-01],
       [9.7104281e-01, 2.8957171e-02]], dtype=float32)
print(features,
      class_names,
      categorical_features,
      categorical_names)
['age', 'workclass', 'fnlwgt', 'education', 'education_num', 'marital', 'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss', 'hours_week', 'native_country'] ['<=50K' '>50K'] [1, 3, 5, 6, 7, 8, 9, 13] {'workclass': array(['?', 'Federal-gov', 'Local-gov', 'Never-worked', 'Private',
       'Self-emp-inc', 'Self-emp-not-inc', 'State-gov', 'Without-pay'],
      dtype=object), 'education': array(['10th', '11th', '12th', '1st-4th', '5th-6th', '7th-8th', '9th',
       'Assoc-acdm', 'Assoc-voc', 'Bachelors', 'Doctorate', 'HS-grad',
       'Masters', 'Preschool', 'Prof-school', 'Some-college'],
      dtype=object), 'marital': array(['Divorced', 'Married-AF-spouse', 'Married-civ-spouse',
       'Married-spouse-absent', 'Never-married', 'Separated', 'Widowed'],
      dtype=object), 'occupation': array(['?', 'Adm-clerical', 'Armed-Forces', 'Craft-repair',
       'Exec-managerial', 'Farming-fishing', 'Handlers-cleaners',
       'Machine-op-inspct', 'Other-service', 'Priv-house-serv',
       'Prof-specialty', 'Protective-serv', 'Sales', 'Tech-support',
       'Transport-moving'], dtype=object), 'relationship': array(['Husband', 'Not-in-family', 'Other-relative', 'Own-child',
       'Unmarried', 'Wife'], dtype=object), 'race': array(['Amer-Indian-Eskimo', 'Asian-Pac-Islander', 'Black', 'Other',
       'White'], dtype=object), 'sex': array(['Female', 'Male'], dtype=object), 'native_country': array(['?', 'Cambodia', 'Canada', 'China', 'Columbia', 'Cuba',
       'Dominican-Republic', 'Ecuador', 'El-Salvador', 'England',
       'France', 'Germany', 'Greece', 'Guatemala', 'Haiti', 'Honduras',
       'Hong', 'Hungary', 'India', 'Iran', 'Ireland', 'Italy', 'Jamaica',
       'Japan', 'Laos', 'Mexico', 'Nicaragua',
       'Outlying-US(Guam-USVI-etc)', 'Peru', 'Philippines', 'Poland',
       'Portugal', 'Puerto-Rico', 'Scotland', 'South', 'Taiwan',
       'Thailand', 'Trinadad&Tobago', 'United-States', 'Vietnam',
       'Yugoslavia'], dtype=object)}
import lime
import lime.lime_tabular
### Train should be label encoded not one hot encoded
explainer = lime.lime_tabular.LimeTabularExplainer(X_train_lime ,
                                                   feature_names = features,
                                                   class_names=class_names,
                                                   categorical_features=categorical_features,
                                                   categorical_names=categorical_names,
                                                   kernel_width=3)
Sekarang pilih rumah tangga secara acak dari kumpulan data uji dan lihat prediksinya serta bagaimana komputer sampai pada prediksi tersebut.
import numpy as np
np.random.seed(1)
i = 100
print(y_test_lime.iloc[i])
>50K
X_test_lime[i]
array([4.20000e+01, 4.00000e+00, 1.76286e+05, 7.00000e+00, 1.20000e+01,
       2.00000e+00, 4.00000e+00, 0.00000e+00, 4.00000e+00, 1.00000e+00,
       0.00000e+00, 0.00000e+00, 4.00000e+01, 3.80000e+01])
Anda dapat menggunakan explainer dengan explain_instance untuk memeriksa alasan di balik model tersebut. Grafik yang dihasilkan ditunjukkan di bawah ini.
exp = explainer.explain_instance(X_test_lime[i], predict_fn, num_features=6)
exp.show_in_notebook(show_all=False)

Pengklasifikasi tersebut memprediksi rumah tangga ini dengan benar: pendapatannya memang di atas 50 ribu.
Hal pertama yang perlu diperhatikan adalah bahwa pengklasifikasi ini tidak terlalu yakin pada dirinya sendiri. Ia memprediksi pendapatan di atas 50 ribu dengan probabilitas 64%, dan 64% tersebut dipengaruhi oleh keuntungan modal dan status perkawinan. Warna biru memberikan kontribusi negatif pada kelas positif dan garis oranye memberikan kontribusi positif.
Pengklasifikasi ragu-ragu karena keuntungan modal rumah tangga ini adalah nol, padahal keuntungan modal biasanya merupakan prediktor kekayaan yang baik. Rumah tangga tersebut juga bekerja kurang dari 40 jam per minggu. Usia, pekerjaan, dan jenis kelamin semuanya memberikan kontribusi positif.
Jika status perkawinan adalah lajang, pengklasifikasi akan memprediksi pendapatan di bawah 50 ribu (0.64 – 0.18 = 0.46).
Sekarang coba rumah tangga lain, yang sebelumnya salah diklasifikasikan. Bagan penjelasannya ada di bawah kode tersebut.
temp.head(3)
temp.iloc[1,:-2]
age                  58
workclass             4
fnlwgt            68624
education            11
education_num         9
marital               2
occupation            4
relationship          0
race                  4
sex                   1
capital_gain          0
capital_loss          0
hours_week           45
native_country       38
Name: 20931, dtype: object
i = 1
print('This observation is', temp.iloc[i,-2:])
This observation is label        <=50K
predicted     >50K
Name: 20931, dtype: object
exp = explainer.explain_instance(temp.iloc[1,:-2], predict_fn, num_features=6)
exp.show_in_notebook(show_all=False)

Pengklasifikasi memprediksi pendapatan di bawah 50 ribu, yang salah. Rumah tangga ini tidak biasa: tidak memiliki keuntungan modal maupun kerugian modal, orang tersebut bercerai, berusia hampir 60 tahun, dan berpendidikan, yaitu education_num > 12. Mengikuti pola keseluruhan, pengklasifikasi menempatkan rumah tangga tersebut di bawah 50 ribu.
Cobalah sendiri menggunakan LIME dan Anda akan melihat banyak kesalahan mencolok dari pengklasifikasi tersebut. Repositori GitHub dari penulis pustaka tersebut menyediakan dokumentasi tambahan untuk klasifikasi gambar dan teks.
Referensi Perintah Scikit-learn
Berikut adalah daftar perintah berguna yang berlaku untuk scikit-learn versi 0.20 dan yang lebih baru.
| tugas | Fungsi atau kelas |
|---|---|
| Buat dataset pelatihan/pengujian | kereta_test_split |
| Bangun saluran pipa | |
| Pilih kolom dan terapkan transformasinya. | membuat_transformator_kolom |
| Jenis transformasi | |
| Membakukan | Penskala Standar |
| Penskalaan min-max | MinMaxScaler |
| Menormalkan | Normalisasi |
| Mengisi nilai yang hilang | SimpleImputer |
| Konversi kategorikal | OneHotEncoder |
| Cocokkan dan ubah data | fit_transform |
| Buatlah saluran pipa | make_pipeline |
| Model dasar | |
| Regresi logistik | Regresi logistik |
| XGBoost | Pengklasifikasi XGB |
| Jaringan saraf | Pengklasifikasi MLP |
| Pencarian kotak | GridSearchCV |
| Pencarian acak | PencarianAcakCV |
