
MongoDB Ekspresi Reguler ($regex) dengan Contoh
 Stephen Twain
⚡ Ringkasan Cerdas
MongoDB Ekspresi reguler melakukan pencocokan pola untuk menemukan string di dalam dokumen, menggunakan operator $regex, flag $options untuk ketidakpekaan huruf besar/kecil, jangkar untuk pencocokan persis, dan pembatas garis miring ketika nilai bidang yang tepat tidak diketahui.
Ekspresi reguler digunakan untuk pencocokan pola, yang pada dasarnya untuk menemukan string di dalam dokumen.
Terkadang saat mengambil dokumen dalam koleksi, Anda mungkin tidak mengetahui secara pasti nilai Bidang yang ingin dicari. Oleh karena itu, seseorang dapat menggunakan ekspresi reguler untuk membantu mengambil data berdasarkan nilai pencarian pencocokan pola.
Menggunakan operator $regex untuk pencocokan Pola
Operator $regex di MongoDB digunakan untuk mencari string tertentu dalam koleksi. Contoh berikut menunjukkan cara melakukannya.
Mari kita asumsikan bahwa kita memiliki koleksi Karyawan yang sama dengan nama Field "Employeeid" dan "EmployeeName". Mari kita juga asumsikan bahwa kita memiliki dokumen-dokumen berikut dalam koleksi kita.
| Identitas pegawai | nama karyawan |
|---|---|
| 22 | Martin Baru |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Gurang |
Pada kode di bawah ini, kita telah menggunakan operator $regex untuk menentukan kriteria pencarian.

db.Employee.find({EmployeeName : {$regex: "Gu" }}).forEach(printjson)
Code Penjelasan:
- Di sini kita ingin menemukan semua Nama Karyawan yang mengandung karakter 'Gu'. Oleh karena itu, kita menentukan operator $regex untuk mendefinisikan kriteria pencarian 'Gu'.
- Printjson digunakan untuk mencetak setiap dokumen yang dikembalikan oleh kueri dengan cara yang lebih baik.
Jika perintah berhasil dijalankan, Output berikut akan ditampilkan:
Keluaran:

Outputnya dengan jelas menunjukkan bahwa dokumen yang Nama Karyawannya berisi karakter 'Gu' dikembalikan.
Misalkan koleksi Anda memiliki dokumen-dokumen berikut dengan tambahan satu dokumen yang berisi Nama Karyawan sebagai “Guru999”. Jika Anda memasukkan kriteria pencarian sebagai “Guru99”, itu juga akan mengembalikan dokumen yang memiliki “Guru999”. Tetapi misalkan jika kita tidak menginginkan ini dan hanya ingin mengembalikan dokumen dengan “Guru99”. Kemudian kita dapat melakukan ini dengan pencocokan pola yang tepat. Untuk melakukan pencocokan pola yang tepat, kita akan menggunakan karakter ^ dan $. Kita akan menambahkan karakter ^ di awal string dan $ di akhir string.
| Identitas pegawai | nama karyawan |
|---|---|
| 22 | Martin Baru |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Gurang |
| 8 | Guru999 |
Contoh berikut menunjukkan bagaimana hal ini dapat dilakukan.
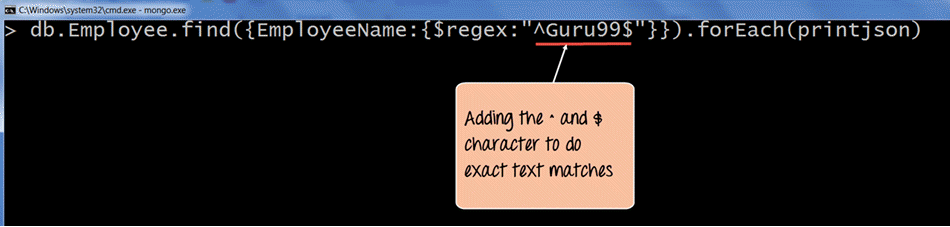
db.Employee.find({EmployeeName : {$regex: "^Guru99$"}}).forEach(printjson)
Code Penjelasan:
- Di sini, dalam kriteria pencarian, kita menggunakan karakter ^ dan $. ^ digunakan untuk memastikan bahwa string dimulai dengan karakter tertentu, dan $ digunakan untuk memastikan bahwa string diakhiri dengan karakter tertentu. Jadi, ketika kode dieksekusi, kode tersebut hanya akan mengambil string dengan nama “Guru99. "
- Printjson digunakan untuk mencetak setiap dokumen yang dikembalikan oleh kueri dengan cara yang lebih baik.
Jika perintah berhasil dijalankan, Output berikut akan ditampilkan:
Keluaran:
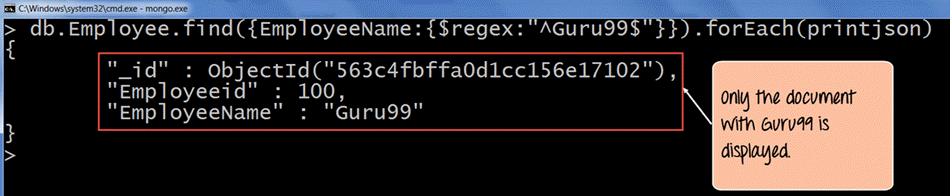
Pada output, terlihat jelas bahwa string “Guru99” diambil.
Pencocokan Pola dengan $options
Saat menggunakan operator $regex, seseorang juga dapat memberikan opsi tambahan dengan menggunakan $pilihan kata kunci. Misalnya, Anda ingin menemukan semua dokumen yang memiliki 'Gu' di Nama Karyawannya, terlepas dari apakah dokumen tersebut peka huruf besar-kecil atau tidak peka huruf besar-kecil. Jika hasil seperti itu diinginkan, maka kita perlu menggunakan $pilihan dengan parameter ketidakpekaan terhadap huruf besar/kecil.
Contoh berikut menunjukkan bagaimana hal ini dapat dilakukan.
Mari kita asumsikan bahwa kita memiliki koleksi Karyawan yang sama dengan nama Field "Employeeid" dan "EmployeeName".
Mari kita asumsikan juga bahwa kita memiliki dokumen-dokumen berikut dalam koleksi kita.
| Identitas pegawai | nama karyawan |
|---|---|
| 22 | Martin Baru |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Gurang |
| 7 | GURU99 |
Sekarang, jika kita menjalankan kueri yang sama seperti pada topik sebelumnya, kita tidak akan pernah melihat dokumen dengan "GURU99" dalam hasilnya. Untuk memastikan dokumen ini muncul dalam kumpulan hasil, kita perlu menambahkan parameter "i" pada $options.
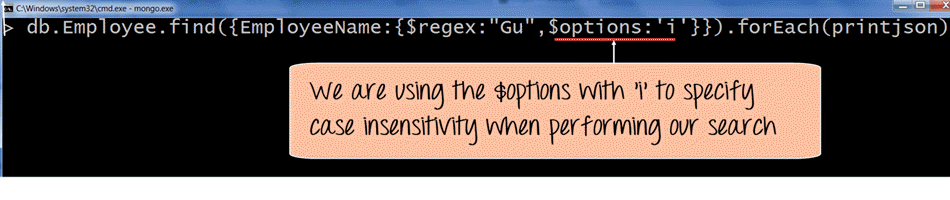
db.Employee.find({EmployeeName:{$regex: "Gu",$options:'i'}}).forEach(printjson)
Code Penjelasan:
- Opsi $options dengan parameter 'i' (yang berarti tidak peka terhadap huruf besar/kecil) menentukan bahwa kita ingin melakukan pencarian terlepas dari apakah kita menemukan huruf 'Gu' dalam huruf kecil atau huruf besar.
Jika perintah berhasil dijalankan, Output berikut akan ditampilkan:
Keluaran:
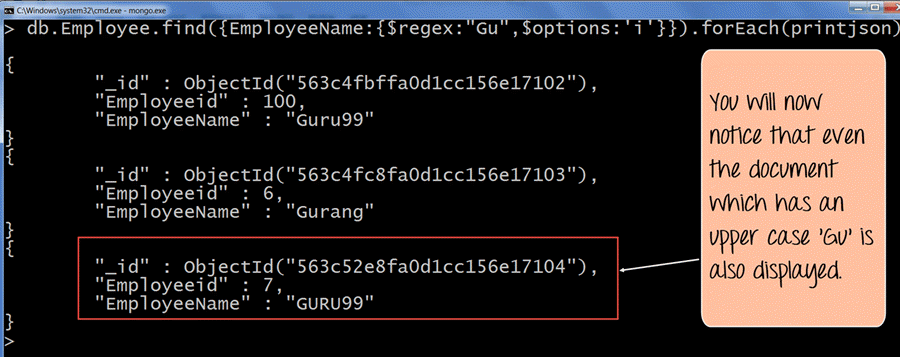
- Output tersebut dengan jelas menunjukkan bahwa meskipun sebuah dokumen memiliki huruf 'Gu' kapital, dokumen tersebut tetap ditampilkan dalam kumpulan hasil.
Pencocokan pola tanpa operator regex
Pencocokan pola juga dapat dilakukan tanpa operator $regex. Contoh berikut menunjukkan bagaimana hal ini dapat dilakukan.
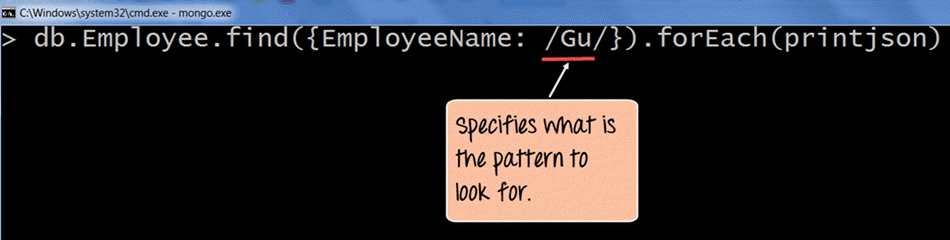
db.Employee.find({EmployeeName: /Gu/}).forEach(printjson)
Code Penjelasan:
- Pembatas “//” pada dasarnya berarti menentukan kriteria pencarian Anda di dalam pembatas ini. Oleh karena itu, kita menentukan /Gu/ untuk kembali menemukan dokumen-dokumen yang memiliki 'Gu' di dalam EmployeeName-nya.
Jika perintah berhasil dijalankan, Output berikut akan ditampilkan:
Keluaran:
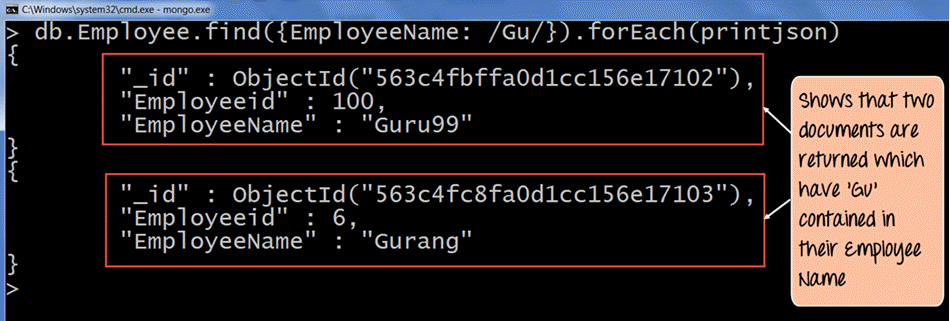
Outputnya dengan jelas menunjukkan bahwa dokumen yang Nama Karyawannya berisi karakter 'Gu' dikembalikan.
Mengambil dokumen 'n' terakhir dari koleksi
Ada berbagai cara untuk mendapatkan n dokumen terakhir dalam sebuah koleksi.
Mari kita lihat salah satu caranya melalui langkah-langkah berikut.
Contoh berikut menunjukkan bagaimana hal ini dapat dilakukan.
Mari kita asumsikan bahwa kita memiliki koleksi Karyawan yang sama dengan nama Field "Employeeid" dan "EmployeeName".
Mari kita asumsikan juga bahwa kita memiliki dokumen-dokumen berikut dalam koleksi kita:
| Identitas pegawai | nama karyawan |
|---|---|
| 22 | Martin Baru |
| 2 | Mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Gurang |
| 7 | GURU99 |
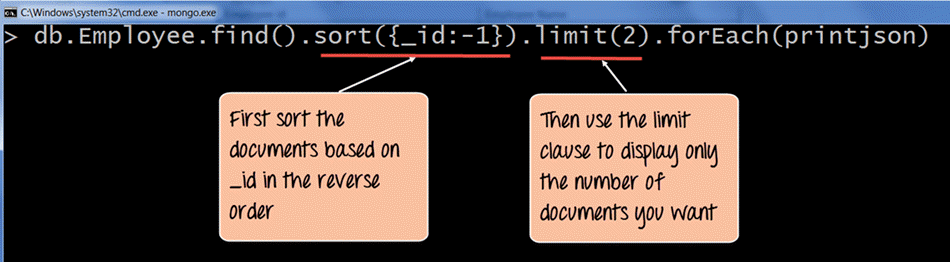
db.Employee.find().sort({_id:-1}).limit(2).forEach(printjson)
Code Penjelasan:
- Saat melakukan kueri untuk dokumen, gunakan fungsi sort untuk mengurutkan catatan dalam urutan terbalik berdasarkan nilai bidang _id dalam koleksi. Angka -1 pada dasarnya menunjukkan untuk mengurutkan dokumen dalam urutan terbalik atau urutan menurun sehingga dokumen terakhir menjadi dokumen pertama yang ditampilkan.
- Kemudian gunakan klausa limit untuk hanya menampilkan jumlah record yang Anda inginkan. Di sini kita telah menetapkan klausa limit (2), sehingga akan mengambil dua dokumen terakhir.
Jika perintah berhasil dijalankan, Output berikut akan ditampilkan:
Keluaran:
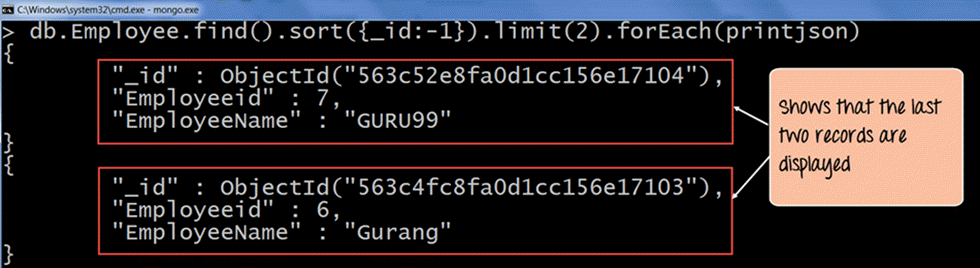
Outputnya dengan jelas menunjukkan bahwa dua dokumen terakhir dalam koleksi ditampilkan. Oleh karena itu kita telah dengan jelas menunjukkan bahwa untuk mengambil dokumen 'n' terakhir dalam koleksi, pertama-tama kita dapat mengurutkan dokumen dalam urutan menurun dan kemudian menggunakan klausa batas untuk mengembalikan jumlah 'n' dokumen yang diperlukan.
Note: Jika pencarian dilakukan pada string yang lebih dari 38,000 karakter, maka tidak akan menampilkan hasil yang benar.
