
Regresi Linier Berganda di R: Sederhana & Bertahap dengan Contoh
 Evelyn Clarke
⚡ Ringkasan Cerdas
Regresi Linier Sederhana dan Berganda di R memodelkan hasil kontinu sebagai jumlah tertimbang dari prediktor yang diestimasi dengan metode kuadrat terkecil biasa. Panduan ini mencakup fungsi lm(), pembacaan koefisien, prediktor faktor, diagnostik residual, prediksi, dan pemilihan variabel otomatis.
Di mana Regresi Linier Berperan dalam Pembelajaran Mesin
Regresi linier adalah salah satu metode supervised tertua. Mesin belajar algoritma, dan ini masih menjadi model pertama yang digunakan sebagian besar analis. Salah satu aplikasi pembelajaran mesin paling awal adalah filter spam.
Aplikasi umum lainnya dari pembelajaran mesin meliputi:
- Identifikasi pesan spam yang tidak diinginkan dalam email
- Segmentasi perilaku pelanggan untuk iklan bertarget
- Pengurangan transaksi kartu kredit palsu
- Optimalisasi penggunaan energi di rumah dan gedung perkantoran
- Pengenalan wajah
Pembelajaran yang Diawasi
In Pembelajaran yang Diawasi, data pelatihan yang Anda masukkan ke algoritme menyertakan label.
Klasifikasi Ini mungkin merupakan teknik pembelajaran terawasi yang paling banyak digunakan. Salah satu tugas klasifikasi pertama yang ditangani para peneliti adalah filter spam. Tujuan pembelajaran ini adalah untuk memprediksi apakah sebuah email diklasifikasikan sebagai spam atau ham (email yang baik). Mesin, setelah tahap pelatihan, dapat mendeteksi kelas email tersebut.
Regresi Regresi umumnya digunakan dalam bidang pembelajaran mesin untuk memprediksi nilai kontinu. Tugas regresi dapat memprediksi nilai suatu nilai. variabel tak bebas berdasarkan satu set Variabel independen (juga disebut prediktor atau regressor). Misalnya, regresi linier dapat memprediksi harga saham, ramalan cuaca, penjualan, dan sebagainya.
Beberapa algoritma pembelajaran terawasi yang mendasar adalah:
- Regresi linier
- Regresi logistik
- Tetangga Terdekat
- Dukungan Mesin Vektor (SVM)
- Pohon keputusan dan Hutan Acak
- Jaringan Saraf Tiruan
Pembelajaran Tanpa Pengawasan
In Pembelajaran Tanpa Pengawasan, data pelatihan tidak diberi label. Sistem mencoba belajar tanpa referensi. Di bawah ini adalah daftar algoritma pembelajaran tanpa pengawasan.
- K-berarti
- Hierarkis Cluster Sampel
- Maksimalisasi Harapan
- Pengurangan visualisasi dan dimensi
- Analisis Komponen Utama
- PCA kernel
- Penyematan Linier Lokal
Dengan konteks tersebut, sisa tutorial ini akan membangun model regresi di R langkah demi langkah.
Regresi Linier Sederhana di R
Regresi linier menjawab pertanyaan sederhana: dapatkah Anda mengukur hubungan yang tepat antara satu variabel target dan serangkaian prediktor?
Model probabilistik paling sederhana adalah model garis lurus:

dimana
- y = Variabel terikat
- x = Variabel bebas
-
 = komponen kesalahan acak
-
 = mencegat
-
 = Koefisien x
Perhatikan alur cerita berikut ini:
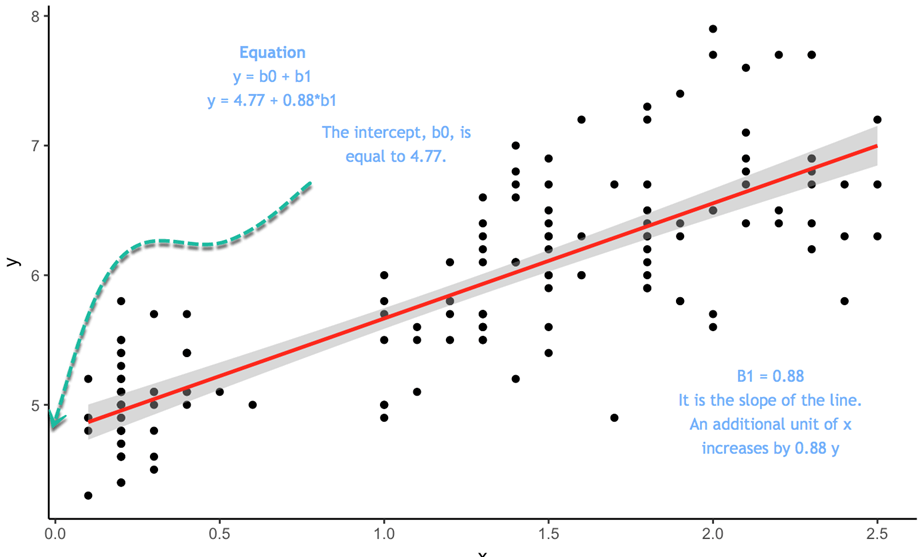
persamaannya adalah 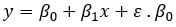 Dalam persamaan ini, titik potongnya adalah 4.77, jadi ketika x sama dengan 0, nilai y yang diprediksi adalah 4.77. Kemiringannya menunjukkan proporsi perubahan y ketika x berubah.
Untuk memperkirakan nilai optimal  ke
 , Anda menggunakan metode yang disebut Kuadrat Terkecil Biasa (OLS). Metode ini mencoba mencari parameter yang meminimalkan jumlah kesalahan kuadrat, yaitu jarak vertikal antara nilai prediksi y dengan nilai y sebenarnya. Perbedaan tersebut dikenal dengan sebutan istilah kesalahan.
Sebelum memperkirakan model, Anda dapat menentukan apakah hubungan linier antara y dan x masuk akal dengan membuat plot sebar.
petak sebar
Kami akan menggunakan kumpulan data yang sangat sederhana untuk menjelaskan konsep regresi linier sederhana. Kami akan mengimpor Rata-Rata Tinggi dan Berat Badan untuk Wanita Amerika. Dataset berisi 15 observasi. Anda ingin mengukur apakah Tinggi badan berkorelasi positif dengan berat badan.
library(ggplot2)
path <- 'https://raw.githubusercontent.com/guru99-edu/R-Programming/master/women.csv'
df <-read.csv(path)
ggplot(df,aes(x=height, y =  weight))+
geom_point()
Keluaran:

Diagram sebaran menunjukkan kecenderungan umum bahwa berat badan meningkat seiring dengan peningkatan tinggi badan. Pada langkah selanjutnya, Anda akan mengukur seberapa besar peningkatan berat badan untuk setiap penambahan satuan tinggi badan.
Estimasi Kuadrat Terkecil
Dalam regresi OLS sederhana, perhitungan  ke Ini cukup mudah. Tutorial ini tidak menurunkan rumus-rumusnya, hanya menyatakannya saja.
Anda ingin memperkirakan: 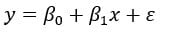
Tujuan dari regresi OLS adalah untuk meminimalkan persamaan berikut:

dimana
 adalah nilai sebenarnya dan
 adalah nilai prediksi.
Solusi untuk is 
Perhatikan bahwa  berarti nilai rata-rata x
Solusi untuk  is

Di R, Anda dapat menggunakan fungsi cov() dan var() untuk memperkirakan dan Anda dapat menggunakan fungsi mean() untuk memperkirakan 
beta <- cov(df$height, df$weight) / var (df$height)
beta
Keluaran:
##[1] 3.45
alpha <- mean(df$weight) - beta * mean(df$height)
alpha
Keluaran:
## [1] -87.51667
Koefisien beta menunjukkan bahwa untuk setiap penambahan satu inci tinggi badan, berat rata-rata meningkat sebesar 3.45 pon.
Memperkirakan persamaan linear secara manual memang bermanfaat, tetapi tidak praktis. R menyediakan fungsi lm() untuk melakukannya untuk Anda, dan Anda akan menggunakannya mulai dari bagian selanjutnya. Dalam proyek nyata, Anda hampir tidak pernah akan menyesuaikan model prediktor tunggal; tugas regresi biasanya melibatkan banyak estimator sekaligus.
Regresi Linier Berganda di R
Penerapan praktis analisis regresi menggunakan model yang lebih kompleks daripada model garis lurus sederhana. Model probabilistik yang mencakup lebih dari satu variabel independen disebut model regresi berganda. Bentuk umum dari model ini adalah:

Dalam notasi matriks, Anda dapat menulis ulang modelnya:

Variabel terikat y sekarang merupakan fungsi dari k variabel bebas. Nilai koefisien  menentukan kontribusi variabel independen
 ke .
Kami secara singkat memperkenalkan asumsi yang kami buat tentang kesalahan acak  dari OLS:
- Berarti sama dengan 0
- Varians sama dengan

- Distribusi normal
- Kesalahan acak bersifat independen (dalam arti probabilistik)

Anda perlu menyelesaikannya , vektor koefisien regresi yang meminimalkan jumlah kesalahan kuadrat antara nilai y prediksi dan nilai aktual.
Solusi bentuk tertutupnya adalah:

dengan:
- menunjukkan mengubah urutan dari matriks X
 menunjukkan matriks yang dapat dibalik
 menunjukkan matriks yang dapat dibalik
Contoh-contoh di bawah ini menggunakan dataset mtcars bawaan. Tujuannya adalah untuk memprediksi konsumsi bahan bakar (mil per galon/mpg) dari serangkaian fitur.
Variabel Kontinyu di R
Untuk saat ini, Anda hanya akan menggunakan variabel kontinu dan mengesampingkan fitur kategoris. Variabel am adalah variabel biner yang mengambil nilai 1 jika transmisi manual dan 0 untuk mobil otomatis; vs juga merupakan variabel biner.
library(dplyr)
df <- mtcars %>%
select(-c(am, vs, cyl, gear, carb))
glimpse(df)
Keluaran:
## Observations: 32
## Variables: 6
## $ mpg  <dbl> 21.0, 21.0, 22.8, 21.4, 18.7, 18.1, 14.3, 24.4, 22.8, 19....
## $ disp <dbl> 160.0, 160.0, 108.0, 258.0, 360.0, 225.0, 360.0, 146.7, 1...
## $ hp   <dbl> 110, 110, 93, 110, 175, 105, 245, 62, 95, 123, 123, 180, ...
## $ drat <dbl> 3.90, 3.90, 3.85, 3.08, 3.15, 2.76, 3.21, 3.69, 3.92, 3.9...
## $ wt   <dbl> 2.620, 2.875, 2.320, 3.215, 3.440, 3.460, 3.570, 3.190, 3...
## $ qsec <dbl> 16.46, 17.02, 18.61, 19.44, 17.02, 20.22, 15.84, 20.00, 2...
Anda dapat menggunakan fungsi lm() untuk menghitung parameter. Sintaks dasar dari fungsi ini adalah:
lm(formula, data, subset)
Arguments:
	-formula: The equation you want to estimate
	-data: The dataset used
	-subset: Estimate the model on a subset of the dataset
Ingat persamaan memiliki bentuk berikut

di R
- Simbol = diganti dengan ~
- Setiap x diganti dengan nama variabel
- Jika Anda ingin menghilangkan konstanta, tambahkan -1 di akhir rumus
Contoh:
Anda ingin memperkirakan berat badan seseorang berdasarkan tinggi badan dan pendapatannya. Persamaannya adalah

Persamaan dalam R ditulis sebagai berikut:
y ~ X1+ X2+…+Xn # Dengan intersepsi
Jadi untuk contoh kita:
- Timbang ~ tinggi badan + pendapatan
Tujuan Anda adalah memperkirakan mil per galon berdasarkan serangkaian variabel. Persamaan untuk memperkirakannya adalah:

Anda akan memperkirakan regresi linier pertama Anda dan menyimpan hasilnya di objek fit.
model <- mpg ~ disp + hp + drat + wt + qsec
fit <- lm(model, df)
fit
Code Penjelasan
- model <- mpg ~ disp + hp + drat + wt + qsec: Simpan model yang akan diestimasi
- lm(model, df): Perkirakan model dengan kerangka data df
##
## Call:
## lm(formula = model, data = df)
##
## Coefficients:
## (Intercept)         disp           hp         drat           wt
##    16.53357      0.00872     -0.02060      2.01577     -4.38546
##        qsec
##     0.64015
Output tidak memberikan informasi yang cukup tentang kualitas kecocokan. Anda dapat mengakses detail lebih lanjut seperti signifikansi koefisien, derajat kebebasan, dan bentuk residual dengan fungsi summary().
summary(fit)
Keluaran:
## return the p-value and coefficient
##
## Call:
## lm(formula = model, data = df)
##
## Residuals:
##     Min      1Q  Median      3Q     Max
## -3.5404 -1.6701 -0.4264  1.1320  5.4996
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept) 16.53357   10.96423   1.508  0.14362
## disp         0.00872    0.01119   0.779  0.44281
## hp          -0.02060    0.01528  -1.348  0.18936
## drat         2.01578    1.30946   1.539  0.13579
## wt          -4.38546    1.24343  -3.527  0.00158 **
## qsec         0.64015    0.45934   1.394  0.17523
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 2.558 on 26 degrees of freedom
## Multiple R-squared:  0.8489, Adjusted R-squared:  0.8199
## F-statistic: 29.22 on 5 and 26 DF, p-value: 6.892e-10
Kesimpulan dari keluaran tabel di atas
- Tabel tersebut menunjukkan hubungan negatif yang kuat antara wt dan mpg, serta koefisien positif untuk drat.
- Hanya variabel wt yang memiliki dampak statistik terhadap mpg. Ingat, untuk menguji hipotesis dalam statistik, kami menggunakan:
- H0: Tidak ada dampak statistik
- H1: Prediktor mempunyai pengaruh yang berarti terhadap y
- Jika nilai p lebih kecil dari 0.05, hal ini menunjukkan variabel tersebut signifikan secara statistik
- R-kuadrat yang disesuaikan: bagian dari varians y yang dijelaskan oleh model, dikoreksi untuk jumlah prediktor. Di sini nilainya adalah 0.8199, jadi model tersebut menjelaskan sekitar 82 persen dari varians mpg. R-kuadrat selalu berada di antara 0 dan 1, dan nilai yang lebih tinggi lebih baik.
Anda dapat menjalankan ANOVA uji untuk memperkirakan pengaruh setiap fitur terhadap varians dengan fungsi anova()
anova(fit)
Keluaran:
## Analysis of Variance Table
##
## Response: mpg
##           Df Sum Sq Mean Sq  F value   Pr(>F)
## disp       1 808.89  808.89 123.6185 2.23e-11 ***
## hp         1  33.67   33.67   5.1449 0.031854 *
## drat       1  30.15   30.15   4.6073 0.041340 *
## wt         1  70.51   70.51  10.7754 0.002933 **
## qsec       1  12.71   12.71   1.9422 0.175233
## Residuals 26 170.13    6.54
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Cara yang lebih konvensional untuk memperkirakan kinerja model adalah dengan menampilkan residu terhadap berbagai ukuran.
Anda dapat menggunakan fungsi plot() untuk menampilkan empat grafik:
– Nilai Residual vs Nilai yang Dipasang
– Plot QQ normal: Kuartil Teoretis vs Residu terstandar
– Skala-Lokasi: Nilai yang disesuaikan vs Akar kuadrat dari residu standar
– Residual vs Leverage: Leverage vs Residual terstandar
Anda menambahkan kode par(mfrow = c(2, 2)) sebelum plot(fit). Jika Anda tidak menambahkan baris kode ini, R akan meminta Anda untuk menekan perintah enter untuk menampilkan grafik berikutnya.
par(mfrow = c(2, 2))
Code Penjelasan
- (mfrow=c(2,2)): mengembalikan jendela dengan empat grafik berdampingan.
- 2 yang pertama menambahkan jumlah baris
- 2 yang kedua menambahkan jumlah kolom.
- Jika Anda menulis (mfrow=c(3,2)): Anda akan membuat jendela 3 baris 2 kolom
plot(fit)
Keluaran:

Rumus lm() mengembalikan daftar yang berisi banyak informasi berguna. Anda dapat mengaksesnya dengan objek fit yang telah Anda buat, diikuti dengan tanda $ dan informasi yang ingin Anda ekstrak.tract.
– koefisien: `koefisien$cocok`
– sisa: `cocok$sisa`
– nilai pas: `fit$fitted.values`
Faktor Regresi di R
Dalam estimasi model terakhir, Anda melakukan regresi mpg pada variabel kontinu saja. Menambahkan variabel faktor ke model sangatlah mudah. Anda menambahkan variabel am ke model Anda. Penting untuk memastikan bahwa variabel tersebut merupakan tingkat faktor dan tidak kontinu.
df <- mtcars %>%
    mutate(cyl = factor(cyl),
        vs = factor(vs),
        am = factor(am),
        gear = factor(gear),
        carb = factor(carb))
model <- mpg ~ .
summary(lm(model, df))
Keluaran:
##
## Call:
## lm(formula = model, data = df)
##
## Residuals:
##     Min      1Q  Median      3Q     Max
## -3.5087 -1.3584 -0.0948  0.7745  4.6251
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept) 23.87913   20.06582   1.190   0.2525
## cyl6        -2.64870    3.04089  -0.871   0.3975
## cyl8        -0.33616    7.15954  -0.047   0.9632
## disp         0.03555    0.03190   1.114   0.2827
## hp          -0.07051    0.03943  -1.788   0.0939 .
## drat         1.18283    2.48348   0.476   0.6407
## wt          -4.52978    2.53875  -1.784   0.0946 .
## qsec         0.36784    0.93540   0.393   0.6997
## vs1          1.93085    2.87126   0.672   0.5115
## am1          1.21212    3.21355   0.377   0.7113
## gear4        1.11435    3.79952   0.293   0.7733
## gear5        2.52840    3.73636   0.677   0.5089
## carb2       -0.97935    2.31797  -0.423   0.6787
## carb3        2.99964    4.29355   0.699   0.4955
## carb4        1.09142    4.44962   0.245   0.8096
## carb6        4.47757    6.38406   0.701   0.4938
## carb8        7.25041    8.36057   0.867   0.3995
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 2.833 on 15 degrees of freedom
## Multiple R-squared:  0.8931, Adjusted R-squared:  0.779
## F-statistic:  7.83 on 16 and 15 DF,  p-value: 0.000124
R menggunakan tingkat faktor pertama sebagai kelompok dasar. Anda perlu membandingkan koefisien kelompok lain dengan kelompok dasar.
Asumsi Regresi Linier di R
Metode kuadrat terkecil biasa (Ordinary Least Squares/OLS) hanya menghasilkan koefisien dan nilai p yang dapat dipercaya jika lima kondisi terpenuhi. Empat plot diagnostik yang dihasilkan oleh plot(fit) ada justru untuk memeriksa kondisi-kondisi tersebut.
- Linearitas: Hubungan antara setiap prediktor dan y bersifat linier. Periksa Residual vs. Sesuai plot; kurva yang terlihat berarti Anda memerlukan transformasi atau suku polinomial.
- Kemerdekaan: Istilah kesalahan tidak berkorelasi. Data yang diurutkan berdasarkan waktu sering melanggar hal ini, yang dapat Anda uji dengan durbinWatsonTest() dari paket car.
- Homoskedastisitas: Varians kesalahan bersifat konstan di seluruh nilai yang diprediksi. Bentuk corong pada Lokasi Skala Plot tersebut memberi sinyal adanya pelanggaran.
- Normalitas residual: Kesalahan tersebut mengikuti distribusi normal. Titik-titik tersebut seharusnya berada pada diagonalnya. QQ normal merencanakan.
- Tidak ada multikolinearitas: Prediktor bukanlah duplikat yang hampir identik satu sama lain. Faktor inflasi varians di atas 5 biasanya merupakan garis peringatan.
library(car)
vif(fit)           # variance inflation factors
shapiro.test(residuals(fit))   # normality of residuals
Pelanggaran tidak selalu membatalkan model, tetapi hal itu mengubah seberapa yakin Anda dapat terhadap nilai p, jadi periksalah sebelum melaporkan koefisien apa pun.
Cara Membuat Prediksi dengan Model Regresi Linier di R
Membuat model hanyalah setengah dari pekerjaan. Fungsi predict() menerapkan koefisien yang telah disesuaikan ke observasi baru.
predict(object, newdata, interval = "none", level = 0.95)
arguments:
-object: The model returned by lm()
-newdata: A data frame whose columns match the predictors used in the formula
-interval: "none", "confidence" for the mean response, or "prediction" for a single new case
-level: The confidence level, 0.95 by default
Ikuti tiga langkah ini.
- Buatlah data frame untuk kasus-kasus baru. Nama kolom harus sama persis dengan nama prediktor dalam rumus, dan level faktor harus sesuai dengan data pelatihan.
- Panggil fungsi predict(). Lewatkan objek yang telah disesuaikan dan data frame yang baru.
- Tambahkan interval. Pilih “confidence” jika Anda menginginkan ketidakpastian seputar respons rata-rata, dan “prediction” jika Anda menginginkan rentang untuk satu mobil tertentu.
new_cars <- data.frame(wt = c(2.5, 3.2), hp = c(110, 175))
fit_final <- lm(mpg ~ wt + hp, data = mtcars)

predict(fit_final, newdata = new_cars)
predict(fit_final, newdata = new_cars, interval = "prediction")
Membaca hasilnya. Sebuah mobil dengan berat 2.5 pon dan tenaga 110 tenaga kuda diprediksi memiliki konsumsi bahan bakar sekitar 24.1 mpg. Interval prediksi selalu lebih lebar daripada interval kepercayaan, karena interval prediksi membawa ketidakpastian dari satu pengamatan di atas ketidakpastian garis yang dipasang.
Dua aturan menjaga prediksi tetap akurat. Jangan pernah melakukan ekstrapolasi di luar rentang prediktor pelatihan, karena garis lurus tidak memiliki bukti di luar sana. Dan selalu evaluasi pada data yang belum pernah dilihat model, jika tidak, kesalahan yang dilaporkan akan terlalu optimis.
Regresi Linier vs Regresi Logistik di R
Analis sering menggunakan lm() ketika hasilnya tidak kontinu. Tabel di bawah ini menunjukkan di mana batasnya berada.
| Kriteria | linear Regression | Regresi logistik |
|---|---|---|
| Variabel respons | Kontinu | Biner atau kategorikal |
| Output yang diprediksi | Bilangan riil apa pun | Probabilitas antara 0 dan 1 |
| Perkiraan | Kuadrat terkecil biasa | Kemungkinan maksimum |
| Ukuran yang pas | R-squared, RMSE | AIC, deviasi, akurasi |
| fungsi R | lm(rumus, data) | glm(formula, data, family = “binomial”) |
Jika hasilnya berupa keputusan ya atau tidak, lanjutkan ke langkah berikutnya. model linier umum alih-alih memaksakan garis lurus melalui angka nol dan satu.
Regresi Linier Bertahap dalam R
Bagian terakhir dari tutorial ini membahas tentang regresi bertahap algoritma. Tujuan dari algoritma ini adalah untuk menambah dan menghapus kandidat potensial dalam model dan mempertahankan kandidat yang memiliki dampak signifikan pada variabel dependen. Algoritma ini berguna ketika kumpulan data berisi daftar prediktor yang besar. Anda tidak perlu menambahkan dan menghapus variabel independen secara manual. Regresi bertahap dibuat untuk memilih kandidat terbaik agar sesuai dengan model.
Mari kita lihat cara kerjanya secara langsung. Anda menggunakan dataset mtcars dengan variabel kontinu saja untuk ilustrasi pedagogis. Sebelum memulai analisis, ada baiknya untuk memeriksa hubungan dalam data dengan matriks korelasi. Pustaka GGally adalah perluasan dari ggplot2.
Pustaka ini mencakup berbagai fungsi untuk menampilkan ringkasan statistik seperti korelasi dan distribusi semua variabel dalam matriks. Kami akan menggunakan fungsi ggscatmat, tetapi Anda dapat merujuk ke skema untuk informasi lebih lanjut tentang perpustakaan GGally.
Sintaks dasar untuk ggscatmat() adalah:
ggscatmat(df, columns = 1:ncol(df), corMethod = "pearson")
arguments:
-df:  A matrix of continuous variables
-columns: Pick up the columns to use in the function. By default, all columns are used
-corMethod: Define the function to compute the correlation between variable. By default, the algorithm uses the Pearson formula
Anda menampilkan korelasi untuk semua variabel Anda dan memutuskan mana yang merupakan kandidat terbaik untuk langkah pertama regresi bertahap. Terdapat beberapa korelasi yang kuat antara variabel Anda dan variabel dependen, mpg.
library(GGally)
df <- mtcars %>%
	select(-c(am, vs, cyl, gear, carb))
ggscatmat(df, columns = 1: ncol(df))
Keluaran:

Contoh Regresi Bertahap Langkah demi Langkah
Pemilihan variabel merupakan bagian penting dalam menyesuaikan model, dan regresi bertahap melakukan pencarian tersebut secara otomatis. Untuk memperkirakan berapa banyak pilihan yang mungkin ada dalam dataset, Anda menghitung  dengan k adalah jumlah prediktor. Besarnya kemungkinan semakin besar seiring dengan banyaknya variabel independen. Itu sebabnya Anda perlu memiliki pencarian otomatis.
Anda perlu menginstal paket olsrr dari CRAN. Paket ini belum tersedia di Anaconda. Oleh karena itu, Anda menginstalnya langsung dari baris perintah:
install.packages("olsrr")
Anda dapat memplot semua himpunan bagian kemungkinan dengan kriteria kecocokan (yaitu R-square, Adjusted R-square, kriteria Bayesian). Model dengan kriteria AIC terendah akan menjadi model akhir.
library(olsrr)
model <- mpg~.
fit <- lm(model, df)
test <- ols_all_subset(fit)
plot(test)
Code Penjelasan
- mpg ~.: Buatlah model yang akan diestimasi
- lm(model, df): Jalankan model OLS
- ols_all_subset(sesuaikan): Buat grafik dengan informasi statistik yang relevan
- merencanakan (tes): Plot grafiknya
Keluaran:

Model regresi linier menggunakan uji-t Untuk memperkirakan dampak statistik dari variabel independen terhadap variabel dependen. Para peneliti umumnya menetapkan ambang batas maksimum pada 10 persen, dan nilai p yang lebih rendah menunjukkan hubungan statistik yang lebih kuat. Regresi bertahap dibangun berdasarkan uji ini untuk menambah dan menghapus prediktor kandidat. Algoritma bekerja sebagai berikut:

- Langkah 1: Regresi setiap prediktor pada y secara terpisah. Yaitu regresi x_1 pada y, x_2 pada y hingga x_n. Simpan p-value dan pertahankan regressor dengan nilai p lebih rendah dari ambang batas yang ditentukan (0.1 secara default). Prediktor dengan signifikansi lebih rendah dari ambang batas akan ditambahkan ke model akhir. Jika tidak ada variabel yang memiliki nilai p lebih rendah dari ambang batas yang dimasukkan, maka algoritme berhenti, dan Anda memiliki model akhir dengan konstanta saja.
- Langkah 2: Gunakan prediktor dengan nilai-p terendah dan tambahkan satu variabel secara terpisah. Anda meregresi sebuah konstanta, prediktor terbaik dari langkah pertama dan variabel ketiga. Anda menambahkan ke model bertahap, prediktor baru dengan nilai lebih rendah dari ambang batas yang masuk. Jika tidak ada variabel yang memiliki nilai-p lebih rendah dari 0.1, maka algoritme berhenti, dan Anda memiliki model akhir dengan satu prediktor saja. Anda meregresi model bertahap untuk memeriksa signifikansi prediktor terbaik langkah pertama. Jika lebih tinggi dari ambang batas penghapusan, Anda mempertahankannya dalam model bertahap. Jika tidak, Anda mengecualikannya.
- Langkah 3: Anda mengulangi langkah 2 pada model bertahap terbaik yang baru. Algoritme menambahkan prediktor ke model bertahap berdasarkan nilai yang dimasukkan dan mengecualikan prediktor dari model bertahap jika tidak memenuhi ambang batas pengecualian.
- Algoritme terus berjalan hingga tidak ada variabel yang dapat ditambahkan atau dikecualikan.
Anda dapat menjalankan algoritma dengan fungsi ols_stepwise() dari paket olsrr.
ols_stepwise(fit, pent = 0.1, prem = 0.3, details = FALSE)

arguments:
-fit:  Model to fit. Need to use `lm()`before to run `ols_stepwise()
-pent: Threshold of the p-value used to enter a variable into the stepwise model. By default, 0.1
-prem: Threshold of the p-value used to exclude a variable into the stepwise model. By default, 0.3
-details: Print the details of each step
⚠️ Catatan pada kemasan: Versi terbaru olsrr telah mengganti nama fungsi-fungsi ini. Gunakan ols_step_all_possible() sebagai pengganti ols_all_subset() dan ols_step_both_p() sebagai pengganti ols_stepwise(). Argumen dan outputnya tidak berubah.
Sebelum itu, kami tunjukkan langkah-langkah algoritmanya. Di bawah ini adalah tabel variabel terikat dan bebas:
| Variabel tak bebas | Variabel independen |
|---|---|
| mpg | tersedia |
| hp | |
| tikus | |
| wt | |
| qdetik |
Start
Untuk memulainya, algoritma dimulai dengan menjalankan model pada setiap variabel independen secara terpisah. Tabel menunjukkan nilai p untuk setiap model.
## [[1]]
##  (Intercept)         disp
## 3.576586e-21 9.380327e-10
##
## [[2]]
##  (Intercept)           hp
## 6.642736e-18 1.787835e-07
##
## [[3]]
##  (Intercept)         drat
## 0.1796390847 0.0000177624
##
## [[4]]
##  (Intercept)           wt
## 8.241799e-19 1.293959e-10
##
## [[5]
## (Intercept)        qsec
##  0.61385436  0.01708199
Untuk memasukkan model, algoritma menyimpan variabel dengan nilai p terendah. Dari output di atas, itu adalah wt
Langkah 1
Pada langkah pertama, algoritme menjalankan mpg pada wt dan variabel lainnya secara independen.
## [[1]]
##  (Intercept)           wt         disp
## 4.910746e-16 7.430725e-03 6.361981e-02
##
## [[2]]
##  (Intercept)           wt           hp
## 2.565459e-20 1.119647e-06 1.451229e-03
##
## [[3]]
##  (Intercept)           wt         drat
## 2.737824e-04 1.589075e-06 3.308544e-01
##
## [[4]]
##  (Intercept)           wt         qsec
## 7.650466e-04 2.518948e-11 1.499883e-03
Setiap variabel merupakan kandidat potensial untuk masuk ke dalam model akhir. Namun, algoritma hanya mempertahankan variabel dengan nilai p yang lebih rendah. Ternyata hp memiliki nilai p yang sedikit lebih rendah daripada qsec, sehingga hp masuk ke dalam model akhir.
Langkah 2
Algoritme mengulangi langkah pertama tetapi kali ini dengan dua variabel independen di model akhir.
## [[1]]
##  (Intercept)           wt           hp         disp
## 1.161936e-16 1.330991e-03 1.097103e-02 9.285070e-01
##
## [[2]]
##  (Intercept)           wt           hp         drat
## 5.133678e-05 3.642961e-04 1.178415e-03 1.987554e-01
##
## [[3]]
##  (Intercept)           wt           hp         qsec
## 2.784556e-03 3.217222e-06 2.441762e-01 2.546284e-01
Tidak satu pun dari kandidat yang tersisa memiliki nilai p di bawah ambang batas masuk. Algoritma berhenti di sini, dan ini adalah model akhirnya:
##
## Call:
## lm(formula = mpg ~ wt + hp, data = df)
##
## Residuals:
##    Min     1Q Median     3Q    Max
## -3.941 -1.600 -0.182  1.050  5.854
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept) 37.22727    1.59879  23.285  < 2e-16 ***
## wt          -3.87783    0.63273  -6.129 1.12e-06 ***
## hp          -0.03177    0.00903  -3.519  0.00145 **
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 2.593 on 29 degrees of freedom
## Multiple R-squared:  0.8268, Adjusted R-squared:  0.8148
## F-statistic: 69.21 on 2 and 29 DF,  p-value: 9.109e-12
Anda dapat menggunakan fungsi ols_stepwise() untuk membandingkan hasilnya.
stp_s <-ols_stepwise(fit, details=TRUE)
Keluaran:
Algoritma ini menemukan solusi setelah dua langkah dan memberikan output yang sama dengan panduan manual di atas.
Oleh karena itu, model akhir dijelaskan oleh dua prediktor dan sebuah intersep: konsumsi bahan bakar (mil per galon) berbanding terbalik dengan tenaga kuda kotor dan berat.
## You are selecting variables based on p value...
## 1 variable(s) added....
## Variable Selection Procedure
##  Dependent Variable: mpg
##
##  Stepwise Selection: Step 1
##
##  Variable wt Entered
##
##                         Model Summary
## --------------------------------------------------------------
## R                       0.868       RMSE                3.046
## R-Squared               0.753       Coef. Var          15.161
## Adj. R-Squared          0.745       MSE                 9.277
## Pred R-Squared          0.709       MAE                 2.341
## --------------------------------------------------------------
##  RMSE: Root Mean Square Error
##  MSE: Mean Square Error
##  MAE: Mean Absolute Error
##		ANOVA
## --------------------------------------------------------------------
##                 Sum of
##                Squares        DF    Mean Square      F         Sig.
## --------------------------------------------------------------------
## Regression     847.725         1        847.725    91.375    0.0000
## Residual       278.322        30          9.277
## Total         1126.047        31
## --------------------------------------------------------------------
##
##                                   Parameter Estimates
## ----------------------------------------------------------------------------------------
##       model      Beta    Std. Error    Std. Beta      t        Sig      lower     upper
## ----------------------------------------------------------------------------------------
## (Intercept)    37.285         1.878                 19.858    0.000    33.450    41.120
##          wt    -5.344         0.559       -0.868    -9.559    0.000    -6.486    -4.203
## ----------------------------------------------------------------------------------------
## 1 variable(s) added...
## Stepwise Selection: Step 2
##
##  Variable hp Entered
##
##                         Model Summary
## --------------------------------------------------------------
## R                       0.909       RMSE                2.593
## R-Squared               0.827       Coef. Var          12.909
## Adj. R-Squared          0.815       MSE                 6.726
## Pred R-Squared          0.781       MAE                 1.901
## --------------------------------------------------------------
##  RMSE: Root Mean Square Error
##  MSE: Mean Square Error
##  MAE: Mean Absolute Error
##			ANOVA
## --------------------------------------------------------------------
##                 Sum of
##                Squares        DF    Mean Square      F         Sig.
## --------------------------------------------------------------------
## Regression     930.999         2        465.500    69.211    0.0000
## Residual       195.048        29          6.726
## Total         1126.047        31
## --------------------------------------------------------------------
##
##                                   Parameter Estimates
## ----------------------------------------------------------------------------------------
##       model      Beta    Std. Error    Std. Beta      t        Sig      lower     upper
## ----------------------------------------------------------------------------------------
## (Intercept)    37.227         1.599                 23.285    0.000    33.957    40.497
##          wt    -3.878         0.633       -0.630    -6.129    0.000    -5.172    -2.584
##          hp    -0.032         0.009       -0.361    -3.519    0.001    -0.050    -0.013
## ----------------------------------------------------------------------------------------
## No more variables to be added or removed.
Regresi Linier di R: Poin-Poin Penting dan Referensi Fungsi
- Regresi linier menjawab pertanyaan sederhana: dapatkah Anda mengukur hubungan yang tepat antara satu variabel target dan serangkaian prediktor?
- Metode Ordinary Least Squares (OLS) menemukan parameter yang meminimalkan jumlah kuadrat kesalahan, yaitu jarak vertikal antara nilai y yang diprediksi dan nilai y sebenarnya.
- Model probabilistik yang mencakup lebih dari satu variabel independen disebut model regresi berganda.
- Tujuan dari algoritma Regresi Linier Bertahap adalah untuk menambah dan menghapus kandidat potensial dalam model dan mempertahankan kandidat yang memiliki dampak signifikan pada variabel dependen.
- Pemilihan variabel merupakan bagian penting dari penyesuaian model, dan regresi bertahap melakukan pencarian tersebut secara otomatis.
Semua fungsi yang digunakan dalam tutorial ini tercantum di bawah ini:
| Perpustakaan | Tujuan | fungsi | kasus |
|---|---|---|---|
| mendasarkan | Hitung regresi linier | aku() | rumus, data |
| mendasarkan | Ringkaslah modelnya | ringkasan() | cocok |
| mendasarkan | Extrackoefisien t | lm()$koefisien | |
| mendasarkan | Extracsisaan t | lm()$sisa | |
| mendasarkan | Extracnilai yang sesuai | lm()$dilengkapi.nilai | |
| olsrr | Jalankan regresi bertahap | ols_bertahap() | cocok, pent = 0.1, prem = 0.3, detail = SALAH |
NoteIngat untuk mengubah variabel kategorikal menjadi faktor sebelum menyesuaikan model.
