
Tutorial Hadoop Pig: Apa itu Apache Pig? Architekstur, Contoh
 Prafulla Ranadive
⚡ Ringkasan Cerdas
Apache Pig adalah platform tingkat tinggi untuk menganalisis kumpulan data besar di Hadoop, yang menggabungkan bahasa aliran data Pig Latin dengan runtime yang mengkompilasi setiap skrip menjadi MapReduce, Tez, atau Spark pekerjaan secara otomatis.
Tutorial ini dimulai dengan gagasan di balik Apache Pig, kemudian membahas cara menginstalnya dan menjalankan skrip Pig Latin lengkap dari awal hingga akhir.
Apa itu Babi Apache?
Babi adalah hewan tingkat tinggi bahasa pemrograman Berguna untuk menganalisis kumpulan data besar. Pig adalah hasil upaya pengembangan di Yahoo!
Dalam kerangka kerja MapReduce, program perlu diterjemahkan ke dalam serangkaian tahapan Map dan Reduce. Namun, ini bukanlah model pemrograman yang familiar bagi analis data. Oleh karena itu, untuk menjembatani kesenjangan ini, diperlukan sebuah solusi abstrak.tracBangunan bernama Pig dibangun di atas Hadoop.
Apache Pig memungkinkan orang untuk lebih fokus pada analisis kumpulan data besar dan menghabiskan lebih sedikit waktu untuk menulis program MapReduce. Mirip dengan babi yang memakan apa saja, bahasa pemrograman Apache Pig dirancang untuk bekerja pada semua jenis data. Itulah mengapa namanya Pig! Maskot proyek di bawah ini menegaskan hal yang sama.

Proyek ini masih aktif. Apache Pig 0.18.0 Dirilis pada 15 September 2025 dan menambahkan dukungan untuk Hadoop 3, Tez 0.10, Hive 3, Spark 3, HBase 2 dan Python tahun 3, menurut Halaman rilis Apache PigPanduan di bawah ini awalnya ditulis berdasarkan versi 0.12.1 yang jauh lebih lama, jadi beberapa langkah memiliki catatan karena versi terbaru berperilaku berbeda.
Babi Architekstur
Arsitektur Pig terdiri dari dua komponen:
- babi latin, yang merupakan bahasa
- Lingkungan waktu proses, untuk menjalankan program Pig Latin.
Program Pig Latin terdiri dari serangkaian operasi atau transformasi yang diterapkan pada data masukan untuk menghasilkan keluaran. Operasi-operasi ini menggambarkan aliran data yang diterjemahkan ke dalam representasi yang dapat dieksekusi oleh lingkungan eksekusi Hadoop Pig. Di baliknya, hasil dari transformasi ini adalah serangkaian PetaKurangi pekerjaan yang tidak disadari oleh programmer. Jadi, dengan kata lain, Pig di Hadoop memungkinkan programmer untuk fokus pada data daripada pada sifat eksekusi.
Pig Latin adalah bahasa yang relatif kaku yang menggunakan kata kunci yang familiar dari pengolahan data, misalnya, Gabung, Kelompokkan, dan Saring. Diagram di bawah ini tracsebuah skrip dari shell Grunt melewati parser, optimizer, dan compiler dalam perjalanannya menuju mesin eksekusi.

Mode eksekusi
Pig di Hadoop memiliki dua mode eksekusi, dan panduan instalasi di bawah ini menggunakan keduanya:
- Mode lokal: Dalam mode ini, bahasa Hadoop Pig berjalan dalam satu proses tunggal. FMV dan memanfaatkan sistem file lokal. Mode ini hanya cocok untuk analisis dataset kecil menggunakan Pig di Hadoop.
- Mode MapReduce: Dalam mode ini, kueri yang ditulis dalam Pig Latin diterjemahkan menjadi pekerjaan MapReduce dan dijalankan pada klaster Hadoop (klaster tersebut dapat berupa pseudo-distributed atau fully distributed). Mode MapReduce dengan klaster fully distributed berguna untuk menjalankan Pig pada dataset besar.
Kedua hal itu adalah pasangan klasik. Rilis terbaru sebenarnya menampilkan enam jenis eksekusi, atau exectypes, yang masing-masing dipilih dengan cara yang sama. -x bendera, seperti yang didokumentasikan dalam Panduan Memulai Pig 0.18.0.
| Exectype | perintah | Di mana pekerjaan berlangsung |
|---|---|---|
| Lokal | babi -x lokal | Sebuah JVM tunggal yang berinteraksi dengan sistem file lokal. |
| Tez lokal | babi -x tez_lokal | Sebuah JVM tunggal yang menggunakan runtime Tez (eksperimental) |
| Spark lokal | babi -x spark_local | Sebuah JVM tunggal yang menggunakan Spark waktu eksekusi (eksperimental) |
| PetaKurangi | babi atau babi -x mapreduce | Klaster Hadoop dengan HDFS; ini adalah pengaturan default. |
| tesis | babi -x tez | Klaster Hadoop yang menjalankan mesin Tez. |
| Spark | babi -x percikan | A SparkKlaster YARN atau Mesos dengan HDFS |
Tipe Data Bahasa Pig Latin dan Operatorso
Sebelum menulis skrip, ada baiknya mengetahui apa yang dapat ditampung oleh Pig dan apa yang dapat dilakukannya terhadap data tersebut. Model datanya sepenuhnya bersarang (nested), yang memungkinkan Pig membaca file log dan input lain yang strukturnya tidak terlalu jelas yang akan ditolak oleh tabel relasional.
Bahasa Pig Latin menawarkan dua kelompok tipe:
- Tipe skalar:
int,long,float,double,chararray,bytearray,boolean,datetime,bigintegerkebigdecimalSkrip contoh selanjutnya mendeklarasikan setiap kolom sebagaichararray. - Jenis kompleks: a tupel adalah himpunan bidang yang terurut dan berperilaku seperti baris; sebuah tas adalah koleksi tupel yang tidak terurut dan berperilaku seperti tabel; peta adalah himpunan pasangan kunci dan nilai yang kuncinya harus berupa
chararray.
Para operator terbagi dalam sejumlah kecil pekerjaan, dan segelintir dari mereka mengoperasikan hampir setiap jalur pipa:
| Operator | Apa yang dilakukannya |
|---|---|
| MUAT / SIMPAN | Baca sebuah relasi dari sistem file dan tulis kembali hasilnya. |
| FILTER | Hanya simpan tuple yang sesuai dengan suatu kondisi. |
| UNTUK SETIAP … HASILKAN | Kerjakan kolom demi kolom, membangun bidang baru. |
| GRUP / KOGROUP | Kelompokkan satu relasi, atau dua relasi atau lebih, berdasarkan sebuah kunci. |
| BERGABUNG | Gabungkan relasi dengan inner join atau outer join. |
| PERSATUAN / PERPISAHAN | Gabungkan relasi, atau pisahkan satu relasi menjadi beberapa bagian. |
| URUTKAN BERDASARKAN / KATEGORI / BATAS | Urutkan, hilangkan duplikat, dan batasi jumlah tuple. |
| MENCURAHKAN / MENGGAMBARKAN / MENJELASKAN / MENGGAMBARKAN | Periksa hasil, skema, rencana eksekusi, dan contoh jalankan. |
Keempat operator inspeksi tersebut juga memiliki pintasan Grunt, yang menghemat waktu.ping selama proses debugging: \d untuk TEMPAT PEMBUANGAN, \de untuk MENJELASKAN, \e untuk MENJELASKAN dan \i untuk MENGGAMBARKAN.
Prasyarat
Pig adalah alat sisi klien. Ia mengurai skrip, merencanakan pekerjaan, dan mengirimkan tugas, tetapi tidak menyediakan penyimpanan atau klaster sendiri, sehingga instalasi Hadoop yang berfungsi harus ada terlebih dahulu. Daftar persyaratan Apache cukup singkat.
| Komponen | Kebutuhan | Mengapa itu dibutuhkan |
|---|---|---|
| Hadoop | Hadoop 2.x atau 3.x, dengan HADOOP_HOME diekspor. | Menyediakan HDFS dan mesin eksekusi. Tanpa HADOOP_HOME, Pig 0.18.0 akan kembali menggunakan Hadoop 2.7.3 yang tertanam. |
| Java | Java Versi 1.7 atau lebih baru, dengan JAVA_HOME diatur ke direktori root instalasi. | Pig dan daemon Hadoop adalah Java program |
| Python (Opsional) | Python 2.7 | Hanya dibutuhkan untuk streaming Python fungsi yang ditentukan pengguna |
| Semut (opsional) | Semut 1.8 | Hanya diperlukan saat membangun atau mengkompilasi ulang Pig dari kode sumber. |
Ada dua poin praktis yang menyertai daftar tersebut. Pertama, jalankan semuanya sebagai pengguna Linux yang sudah memiliki direktori home di HDFS dan izin untuk menulis ke dalamnya; tutorial ini menggunakan hduserPertama, akun yang dibuat selama pengaturan Hadoop. Kedua, mulai klaster sebelum meluncurkan Pig dalam mode MapReduce, karena Pig akan langsung gagal jika NameNode dan ResourceManager mati. Jika Hadoop belum diinstal, ikuti langkah-langkah berikut. cara menginstal Hadoop pertama.
Cara Mengunduh dan Menginstal Pig
Sekarang dalam tutorial Apache Pig ini, kita akan mempelajari cara mengunduh dan menginstal Pig:
Sebelum kita memulai proses sebenarnya, pastikan Anda telah menginstal Hadoop. Ubah pengguna menjadi 'hduser' (ID yang digunakan saat mengkonfigurasi Hadoop; Anda dapat beralih ke ID pengguna yang digunakan selama konfigurasi Hadoop Anda sendiri).

Langkah 1) Unduh rilis stabil terbaru Pig Hadoop dari salah satu situs mirror yang tersedia di
https://pig.apache.org/releases.html
Pilih file tar.gz (dan bukan src.tar.gz) untuk diunduh, seperti yang ditunjukkan di bawah ini.

Langkah 2) Setelah pengunduhan selesai, navigasikan ke direktori yang berisi file tar yang diunduh dan pindahkan file tar tersebut ke lokasi tempat Anda ingin menginstal Pig Hadoop. Dalam hal ini, kita akan memindahkannya ke /usr/local.

Pindah ke direktori yang akan berisi file Pig Hadoop.
cd /usr/local
Extracisi file tar seperti di bawah ini.
sudo tar -xvf pig-0.12.1.tar.gz

Langkah 3) Ubah file ~/.bashrc untuk menambahkan variabel lingkungan yang berkaitan dengan Pig.
Buka file ~/.bashrc di editor teks pilihan Anda dan lakukan modifikasi di bawah ini.
export PIG_HOME=<Installation directory of Pig>
export PATH=$PIG_HOME/bin:$HADOOP_HOME/bin:$PATH

Langkah 4) Sekarang, jalankan konfigurasi lingkungan ini menggunakan perintah di bawah ini.
. ~/.bashrc

Langkah 5) Kita perlu mengkompilasi ulang Pig agar mendukung Hadoop 2.2.0.
Berikut langkah-langkah untuk melakukannya.
Buka direktori utama Pig.
cd $PIG_HOME
Instal Ant.
sudo apt-get install ant

Catatan: Proses pengunduhan akan dimulai dan akan memakan waktu sesuai dengan kecepatan internet Anda.
Kompilasi ulang Pig.
sudo ant clean jar-all -Dhadoopversion=23

Harap dicatat bahwa dalam proses kompilasi ulang ini, beberapa komponen diunduh, jadi sistem harus terhubung ke internet.
Selain itu, jika proses ini macet di suatu tempat dan Anda tidak melihat pergerakan apa pun pada command prompt selama lebih dari 20 menit, tekan Ctrl + c dan jalankan kembali perintah yang sama.
Dalam kasus kami, dibutuhkan waktu 20 menit.

Langkah kompilasi ulang ini termasuk dalam era 0.12.1, ketika jar yang dikirimkan dibangun berdasarkan Hadoop 1 dan -Dhadoopversion=23 flag tersebut mengalihkan build Ant ke lini Hadoop 0.23 dan 2.x. Apache Pig 0.18.0 menyertakan binary yang sudah berjalan di Hadoop 2.7 dan di atasnya serta Hadoop 3, jadi pada rilis terbaru Anda biasanya dapat mengekstrak tarball dan langsung menuju ke pengujian di bawah ini.
Langkah 6) Uji instalasi Pig menggunakan perintah
pig -help

Contoh Skrip Babi
Setelah Pig terpasang, sisa tutorial Apache Pig ini akan menjalankan skrip lengkap. Kita akan menggunakan Skrip Pig untuk mencari jumlah produk yang terjual di setiap negara.
Masukan: Kumpulan data masukan kami berupa file CSV, PenjualanJan2009.csv.
Langkah 1) Mulai Hadoop.
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Langkah 2) Pig dalam Big Data mengambil file dari HDFS dalam mode MapReduce dan menyimpan hasilnya kembali ke HDFS.
Salin file SalesJan2009.csv (yang tersimpan di sistem file lokal di ~/input/SalesJan2009.csv) ke direktori utama HDFS (Hadoop Distributed File System).
Dalam contoh Apache Pig ini, file berada di folder input. Jika file tersimpan di lokasi lain, berikan nama lokasi tersebut sebagai gantinya.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/input/SalesJan2009.csv /

Verifikasi apakah file tersebut benar-benar telah disalin atau belum.
$HADOOP_HOME/bin/hdfs dfs -ls /

Langkah 3) Konfigurasi Babi.
Pertama, masuk ke direktori $PIG_HOME/conf dan simpan salinan file properti aslinya.
cd $PIG_HOME/conf
sudo cp pig.properties pig.properties.original

Buka file pig.properties menggunakan editor teks pilihan Anda, dan tentukan jalur file log menggunakan pig.logfile.
sudo gedit pig.properties

Program pencatat log akan menggunakan file ini untuk mencatat kesalahan.
Langkah 4) Jalankan perintah 'pig', yang akan memulai prompt perintah Pig, sebuah shell interaktif untuk kueri Pig.
pig

Langkah 5) Di jendela command prompt Grunt untuk Pig, jalankan perintah Pig di bawah ini secara berurutan.
— A. Memuat file yang berisi data.
salesTable = LOAD '/SalesJan2009.csv' USING PigStorage(',') AS (Transaction_date:chararray,Product:chararray,Price:chararray,Payment_Type:chararray,Name:chararray,City:chararray,State:chararray,Country:chararray,Account_Created:chararray,Last_Login:chararray,Latitude:chararray,Longitude:chararray);
Tekan Enter setelah perintah ini.
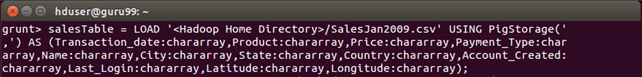
— B. Kelompokkan data berdasarkan kolom Negara.
GroupByCountry = GROUP salesTable BY Country;

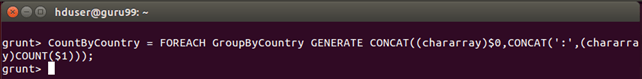
— C. Untuk setiap tuple dalam 'GroupByCountry', hasilkan string dengan format Nama Negara: Jumlah produk terjual.
CountByCountry = FOREACH GroupByCountry GENERATE CONCAT((chararray)$0,CONCAT(':',(chararray)COUNT($1)));
Tekan Enter setelah perintah ini.
— D. Simpan hasil aliran data di direktori 'pig_output_sales' di HDFS.
STORE CountByCountry INTO 'pig_output_sales' USING PigStorage('\t');

Perintah ini akan membutuhkan waktu untuk dieksekusi. Setelah selesai, Anda akan melihat layar berikut.

Langkah 6) Hasilnya dapat dilihat melalui antarmuka perintah sebagai berikut:
$HADOOP_HOME/bin/hdfs dfs -cat pig_output_sales/part-r-00000

Hasilnya juga dapat dilihat melalui antarmuka web.
Buka http://localhost:50070/ di peramban web.
Port 50070 adalah UI web NameNode pada Hadoop 2. Hadoop 3 memindahkan halaman yang sama ke port 9870, jadi gunakan alamat tersebut jika klaster Anda menjalankan Hadoop 3.

Sekarang pilih 'Jelajahi sistem file' dan navigasikan ke atas ke /user/hduser/pig_output_sales.

Buka part-r-00000 untuk membaca pasangan negara dan jumlah produk yang dihasilkan oleh skrip.

Apache Pig vs Hive vs MapReduce
Pig jarang dievaluasi secara terpisah. Pertanyaan yang biasa diajukan adalah apakah suatu pekerjaan termasuk dalam kategori Pig, atau dalam kategori lainnya. Sarang lebah atau dalam program MapReduce yang ditulis tangan, karena ketiganya pada akhirnya menjadi pekerjaan pada klaster yang sama.
| Aspek | MapReduce (Java) | Babi Apache | Sarang Apache |
|---|---|---|---|
| Antarmuka | Java API | Pig Latin, sebuah bahasa skrip aliran data. | sarang QL, sebuah dialek SQL |
| Tingkat abstracproduksi | Rendah | Medium | High |
| Pengguna umum | Java pembangun | Insinyur data atau peneliti | Analis yang mahir dalam SQL |
| Data yang sesuai | Segala sesuatu, ditangani secara manual | Terstruktur dan semi-terstruktur; skema bersifat opsional pada saat pemuatan. | Tabel terstruktur yang terdaftar di metastore |
| Code volume | Sebagian besar baris | Antrean lebih sedikit | Jumlah baris paling sedikit untuk sebuah kueri. |
| Berjalan sebagai | Sebuah pekerjaan MapReduce | Dikompilasi ke MapReduce, Tez atau Spark pekerjaan | Dikompilasi ke MapReduce, Tez atau Spark pekerjaan |
| Terbaik di | Kontrol penuh dan logika kustom. | Pipeline ETL multi-langkah | Pengumpulan dan pelaporan ad hoc |
Dalam praktiknya, pemisahannya cukup mudah. Gunakan Hive ketika data sudah berbentuk tabel dan pertanyaannya berbentuk SQL. Gunakan Pig ketika inputnya berantakan, ketika pipeline merupakan rangkaian transformasi dan bukan kueri tunggal, atau ketika skrip yang sama harus bercabang dan bergabung kembali. Gunakan MapReduce hanya ketika tidak ada solusi yang mutlak diperlukan.traction dapat mengekspresikan logika, karena jumlah baris bertambah dengan cepat.
Babi juga dapat hidup berdampingan dengan nyaman dengan ekosistem lainnya. Sqoop dan Flume Masukkan data mentah, olah data tersebut menggunakan Pig atau Hive, dan gunakan penjadwal seperti... Apache Oozie merangkai langkah-langkah menjadi alur kerja yang dapat diulang. Untuk gambaran yang lebih luas tentang di mana alat-alat ini cocok, lihat panduan untuk data besar dan rangkuman dari alat data besarUntuk alternatif ETL komersial selain skrip yang ditulis tangan, lihat Talend.
