
Tutorial DataStage untuk Pemula: IBM Alat ETL
 David Carter
⚡ Ringkasan Cerdas
DataStage dari IBM InfoSphere mantantracDB2 memproses, mentransformasi, dan memuat data perusahaan dalam skala besar. Halaman ini menjelaskan arsitektur, komponen, pemrosesan paralel, pengaturan replikasi SQL, pembuatan proyek, kompilasi pekerjaan, dan pengujian integrasi menggunakan contoh praktis DB2 untuk bisnis ritel.
Apa itu DataStage?
Data Stage adalah alat ETL yang digunakan untuk mengekstrak data.tracMengolah, mengubah, dan memuat data dari sumber ke tujuan target. Sumber data ini dapat mencakup file sekuensial, file terindeks, basis data relasional, sumber data eksternal, arsip, aplikasi perusahaan, dll. DataStage digunakan untuk memfasilitasi analisis bisnis dengan menyediakan data berkualitas untuk membantu dalam memperoleh kecerdasan bisnis.
Perangkat lunak ETL DataStage digunakan di organisasi besar sebagai antarmuka antara berbagai sistem. Perangkat lunak ini menangani berbagai hal, termasuk:tracProses ini mencakup penerjemahan dan pemuatan data dari sumber ke tujuan. Pertama kali diluncurkan oleh VMark pada pertengahan tahun 90-an. Dengan IBM mengakuisisi DataStage pada tahun 2005, namanya diubah menjadi IBM WebSphere DataStage dan kemudian ke IBM InfoSphere.
Berbagai versi Datastage yang tersedia di pasaran sejauh ini adalah Enterprise Edition (PX), Server Edition, MVS Edition, DataStage for PeopleSoft dan sebagainya. Edisi terbaru adalah IBM InfoSphere DataStage.
IBM Server informasi mencakup produk-produk berikut,
- IBM Tahap Data InfoSphere
- IBM Tahap Kualitas InfoSphere
- IBM Direktur Layanan Informasi InfoSphere
- IBM Penganalisis Informasi InfoSphere
- IBM Server Informasi CepatTrack
- IBM Glosarium Bisnis InfoSphere
Setelah definisi ditetapkan, bagian selanjutnya akan membahas apa yang sebenarnya dapat dilakukan produk tersebut di dalam sebuah pergudangan data lingkungan.
Ikhtisar Tahap Data
Datastage memiliki Kemampuan berikut.
- Ini dapat mengintegrasikan data dari berbagai sumber data perusahaan dan eksternal
- Menerapkan aturan validasi data
- Ini berguna dalam memproses dan mengubah data dalam jumlah besar
- Ini menggunakan pendekatan pemrosesan paralel yang dapat diskalakan
- Ia dapat menangani transformasi kompleks dan mengelola beberapa proses integrasi
- Manfaatkan konektivitas langsung ke aplikasi perusahaan sebagai sumber atau target
- Manfaatkan metadata untuk analisis dan pemeliharaan
- Operates secara batch, real-time, atau sebagai layanan Web
Pada bagian berikut dari tutorial DataStage ini, kami menjelaskan secara singkat aspek-aspek berikut IBM Tahap Data InfoSphere:
- Transformasi data
- Jobs
- Proses paralel
InfoSphere DataStage dan QualityStage dapat mengakses data dalam aplikasi perusahaan dan sumber data seperti:
- Database relasional
- Basis data kerangka utama
- Aplikasi bisnis dan analitik
- Perencanaan sumber daya perusahaan (ERP) atau database manajemen hubungan pelanggan (CRM).
- Pemrosesan analitik online (OLAP) atau database manajemen kinerja
Jenis Tahap Pemrosesan
IBM Pekerjaan infosfer terdiri dari tahapan-tahapan individual yang dihubungkan satu sama lain. Ini menggambarkan aliran data dari sumber data ke target data. Biasanya, suatu tahapan memiliki minimal satu masukan data dan/atau satu keluaran data. Namun, beberapa tahapan dapat menerima lebih dari satu input data dan keluaran ke lebih dari satu tahapan.
Dalam desain Job berbagai tahapan yang dapat Anda gunakan adalah:
- Tahap transformasi
- Tahap penyaring
- Tahap agregator
- Hapus tahap duplikat
- Bergabunglah dengan panggung
- Tahap pencarian
- Tahap penyalinan
- Tahap penyortiran
- Wadah
Mengapa Menggunakan DataStage untuk Integrasi Data?
Mengetahui daftar fitur adalah satu hal; mengetahui kapan alat tersebut sepadan dengan biaya lisensinya adalah hal lain. DataStage dipilih untuk beban kerja di mana volume, tata kelola, dan sumber heterogen membuat skrip yang ditulis tangan menjadi tidak terkendali.
Alasan yang paling jelas adalah throughput. Karena mesin membagi data di seluruh node dan mengalirkan rekaman antar tahapan secara bersamaan, penambahan perangkat keras meningkatkan throughput hampir secara linier. Sebuah pekerjaan yang dirancang pada kotak pengembangan dua node berjalan tanpa perubahan pada klaster produksi delapan node.
Alasan lainnya lebih bersifat organisasional daripada teknis:
- Metadata bersama: Definisi tabel, koneksi, dan istilah bisnis disimpan sekali di repositori dan digunakan kembali oleh setiap pekerjaan, yang menghilangkan perbedaan yang muncul ketika setiap pengembang mendefinisikan sumber secara independen.
- Kualitas data bawaan: QualityStage menjalankan investigasi, standardisasi, pencocokan, dan penentuan kelangsungan hidup di samping alur ETL, sehingga pembersihan tidak memerlukan produk kedua.
- Konektivitas luas: Konektor asli terhubung ke DB2, Oracle, Teradata, mainframe VSAM, SAP, Salesforce, dan penyimpanan objek cloud tanpa kode kustom.
- Operakontrol nasional: Direktur memberikan riwayat eksekusi, jumlah baris, peringatan, dan titik restart, yang diterima oleh auditor sebagai bukti adanya alur data yang terkontrol.
- Dapat digunakan kembali: Kontainer dan set parameter bersama memungkinkan satu transformasi yang telah diuji untuk melayani banyak pekerjaan, alih-alih disalin ke setiap pekerjaan tersebut.
Manfaat-manfaat ini bergantung langsung pada bagaimana produk tersebut dirakit, yang akan dijelaskan di bagian selanjutnya.
Komponen DataStage dan Architekstur
DataStage memiliki empat komponen utama yaitu,
- Administrator: Ini digunakan untuk tugas-tugas administrasi. Ini termasuk menyiapkan pengguna DataStage, menyiapkan kriteria pembersihan, dan membuat & memindahkan proyek.
- Manajer: Ini adalah antarmuka utama Repositori ETL DataStage. Ini digunakan untuk penyimpanan dan pengelolaan Metadata yang dapat digunakan kembali. Melalui manajer DataStage, seseorang dapat melihat dan mengedit konten Repositori.
- Designer: Antarmuka desain yang digunakan untuk membuat aplikasi ATAU pekerjaan DataStage. Ini menentukan sumber data, transformasi yang diperlukan, dan tujuan data. Pekerjaan dikompilasi untuk membuat executable yang dijadwalkan oleh Direktur dan dijalankan oleh Server
- Direktur: Ini digunakan untuk memvalidasi, menjadwalkan, mengeksekusi, dan memantau pekerjaan server DataStage dan pekerjaan paralel.

Gambar di atas menjelaskan caranya IBM Infoosphere DataStage berinteraksi dengan elemen lain dari IBM Platform Server Informasi. DataStage dibagi menjadi dua bagian, Komponen Bersama, dan Runtime ArchiteksturTabel di bawah ini menjelaskan lebih detail kontribusi dari masing-masing bagian tersebut.
|
bersama |
Antarmuka pengguna terpadu |
|
|
Layanan Umum |
|
|
|
Pemrosesan Paralel Umum |
|
|
|
Runtime Architekstur |
Skrip K3 |
|
Cara Kerja Pemrosesan Paralel di DataStage
Tabel arsitektur di atas menyebutkan pemrosesan paralel umum sebagai layanan bersama. Bagian ini menjelaskan bagaimana layanan tersebut sebenarnya mengeksekusi suatu pekerjaan, karena konsep tersebut telah dijanjikan dalam gambaran umum dan menentukan seberapa cepat suatu pekerjaan selesai.
Sebuah proses paralel menggunakan dua mekanisme secara bersamaan, dan keduanya diterapkan secara otomatis saat runtime, bukan dikodekan secara manual.
1. Paralelisme pipeline. Setiap tahapan dalam suatu pekerjaan dimulai sekaligus, alih-alih menunggu tahapan sebelumnya selesai. Tahapan sumber mulai membaca baris dan memasukkannya ke dalam pipeline dalam memori. Transformer dimulai segera setelah baris pertama tiba dan memasukkan outputnya ke dalam pipeline kedua. Konektor target mulai menulis segera setelah itu. Tidak ada file pendaratan perantara yang ditulis, sehingga pekerjaan tiga tahap tumpang tindih antara pembacaan, transformasi, dan penulisan, alih-alih menjalankannya secara berurutan.
2. Paralelisme partisi. Baris-baris tersebut dibagi menjadi partisi-partisi terpisah, dan salinan lengkap logika tahapan dijalankan terhadap setiap partisi pada node-nya sendiri. Delapan partisi berarti delapan instance Transformer yang berjalan secara bersamaan. Pada akhir alur, partisi-partisi tersebut dikumpulkan kembali menjadi satu aliran tunggal untuk target.
Memilih metode partisi yang tepat adalah keputusan penyetelan utama yang dibuat oleh seorang pengembang:
- Auto: Standar default. Mesin memilih metode berdasarkan kebutuhan tahapan tersebut.
- hash: Mengirim baris dengan nilai kunci yang sama ke node yang sama. Diperlukan sebelum Join, Aggregator, dan Remove Duplicates agar kunci yang cocok bertemu.
- Usul: Membagi baris secara merata satu per satu. Terbaik untuk memuat file datar di mana grup kunciping tidak apa-apa.
- Seluruh: Menyalin seluruh kumpulan data ke setiap node. Digunakan untuk tabel referensi kecil pada tahap Pencarian (Lookup).
- Sama: Mempertahankan partisi yang ada tanpa perubahan, sehingga menghindari partisi ulang yang tidak perlu antara dua tahap.
- Jangkauan dan Modulus: Distribusikan baris berdasarkan rentang nilai atau sisa kunci numerik bila diperlukan penyebaran yang merata.
Berkas konfigurasi (APT_CONFIG_FILE) menyatakan berapa banyak node yang ada. Karena jumlah node berada di luar pekerjaan, pekerjaan yang sama yang telah dikompilasi dapat diskalakan dari laptop ke grid produksi tanpa perubahan desain.
Sebelum semua ini dapat dicoba, lingkungan harus sudah siap.
Prasyarat untuk Alat Datastage
Untuk DataStage, Anda memerlukan pengaturan berikut.
- Infosfer
- DataStage Server 9.1.2 atau lebih tinggi
- Microsoft Visual Studio .NET 2010 Edisi Ekspres C++
- Oracle klien (klien penuh, bukan klien instan) jika terhubung ke Oracle Database
- Klien DB2 jika terhubung ke database DB2
Sekarang dalam seri tutorial DataStage untuk Pemula ini, kita akan mempelajari cara mengunduh dan menginstal server informasi InfoSphere.
Unduh dan Instalasi Server Informasi InfoSphere
Untuk mengakses DataStage, unduh dan instal versi terbaru IBM Server InfoSphere. Server mendukung AIX, Linux, dan Windows sistem operasi. Anda dapat memilih sesuai kebutuhan.
Untuk memigrasikan data Anda dari infosfer versi lama ke versi baru, gunakan alat pertukaran aset.
File Instalasi
Untuk menginstal dan mengonfigurasi Infosphere Datastage, Anda harus memiliki file berikut dalam pengaturan Anda.
Untuk Windows,
- Paket Penerapan Etl-windows-oracle.pkg
- Paket Penerapan Etl-windows-db2.pkg
Untuk Linux,
- EtlDeploymentPackage-linux-db2.pkg
- Paket Penerapan Etl-linux-oracle.pkg
Setelah server terpasang, contoh yang dikerjakan di bagian selanjutnya dari halaman ini menggunakan pengambilan data perubahan (change data capture), jadi ada baiknya untuk melihat bagaimana data perubahan mengalir sebelum membangunnya.
Alur proses Perubahan Data dalam Pekerjaan Tahap Transaksi CDC

Diagram di atas tracIni adalah perubahan tunggal dari basis data sumber ke basis data target, sesuai urutan yang tercantum di bawah ini.
- Layanan 'InfoSphere CDC' untuk database memantau dan menangkap perubahan dari database sumber
- Menurut definisi replikasi, “InfoSphere CDC” mentransfer data perubahan ke “InfoSphere CDC untuk InfoSphere DataStage.”
- Server “InfoSphere CDC untuk InfoSphere DataStage” mengirimkan data ke “Tahap Transaksi CDC” melalui sesi TCP/IP. Server “InfoSphere CDC untuk InfoSphere DataStage” juga mengirimkan pesan COMMIT (bersama dengan informasi bookmark) untuk menandai batas transaksi di log yang diambil.
- Untuk setiap pesan COMMIT yang dikirim oleh server “InfoSphere CDC for InfoSphere DataStage”, “Tahap Transaksi CDC” membuat penanda end-of-wave (EOW). Penanda ini dikirim pada semua link keluaran ke tahap konektor database target.
- Ketika “tahap konektor database target” menerima penanda akhir gelombang pada semua link input, ia menulis informasi bookmark ke tabel bookmark dan kemudian melakukan transaksi ke database target.
- Server “InfoSphere CDC untuk InfoSphere DataStage” meminta informasi penanda dari tabel penanda pada “database target.”
- Server “InfoSphere CDC untuk InfoSphere DataStage” menerima informasi Bookmark.
Informasi ini digunakan untuk,
- Tentukan titik awal dalam log transaksi tempat perubahan dibaca saat replikasi dimulai.
- Untuk menentukan apakah log transaksi yang ada dapat dibersihkan
Menyiapkan Replikasi SQL
Sebelum memulai Datastage, Anda perlu menyiapkan database. Anda akan membuat dua database DB2.
- Satu untuk dijadikan sebagai sumber replikasi dan
- Satu sebagai sasarannya.
Anda juga akan membuat dua tabel (Produk dan Inventaris) dan mengisinya dengan data sampel. Kemudian Anda dapat menguji integrasi Anda di antara keduanya SQL Replikasi dan Tahap Data.
Ke depannya, Anda akan menyiapkan replikasi SQL dengan membuat tabel kontrol, kumpulan langganan, registrasi, dan anggota kumpulan langgananKita akan mempelajarinya lebih lanjut secara rinci di bagian berikutnya.
Disini kita akan mengambil contoh item penjualan Retail sebagai database kita dan membuat dua tabel Inventory dan Product. Tabel ini akan memuat data dari sumber ke target melalui kumpulan ini. (tabel kontrol, kumpulan langganan, registrasi, dan anggota kumpulan langganan.)
Langkah 1) Buat database sumber yang disebut sebagai PENJUALAN. Di bawah database ini, buat dua tabel produk ke Inventaris.
Langkah 2) Jalankan perintah berikut untuk membuat database SALES.
db2 create database SALES
Langkah 3) Aktifkan pencatatan arsip untuk database SALES. Cadangkan juga database dengan menggunakan perintah berikut
db2 update db cfg for SALES using LOGARCHMETH3 LOGRETAIN
db2 backup db SALES
Langkah 4) Di jendela command prompt yang sama, ubah direktori ke subdirektori setupDB di direktori sqlrepl-datastage-tutorial yang Anda buat sebelumnya.tracdiambil dari file terkompresi yang diunduh.

Langkah 5) Gunakan perintah berikut untuk membuat tabel Inventaris dan mengimpor data ke dalam tabel dengan menjalankan perintah berikut.
db2 import from inventory.ixf of ixf create into inventory
Langkah 6) Buat tabel target. Beri nama database target sebagai STAGEDB.
Karena sekarang Anda telah membuat sumber dan target database, langkah selanjutnya dalam tutorial DataStage ini, kita akan melihat cara mereplikasinya.
Informasi berikut dapat membantu dalam menyiapkan sumber data ODBC dalam IBM Dokumentasi InfoSphere Information Server.
Membuat Objek Replikasi SQL
Gambar di bawah ini menunjukkan bagaimana alur data perubahan dikirim dari basis data sumber ke basis data target. Anda membuat peta sumber-ke-target.ping di antara meja yang dikenal sebagai anggota set langganan dan mengelompokkan anggotanya menjadi a berlangganan.

Unit replikasi dalam InfoSphere CDC (Change Data Capture) disebut sebagai langganan.
- Perubahan yang dilakukan di sumber ditangkap dalam “Capture control table” yang dikirim ke tabel CD dan kemudian ke tabel target. Sementara program apply akan memiliki rincian tentang baris tempat perubahan perlu dilakukan. Program ini juga akan menggabungkan tabel CD dalam set langganan.
- Langganan berisi petaping Rincian yang menentukan bagaimana data dalam penyimpanan data sumber diterapkan ke penyimpanan data target. Catatan, CDC sekarang disebut sebagai Replikasi data infosfer.
- Saat langganan dijalankan, InfoSphere CDC merekam perubahan pada basis data sumber. InfoSphere CDC mengirimkan data perubahan ke target, dan menyimpan informasi titik sinkronisasi dalam tabel penanda di basis data target.
- InfoSphere CDC menggunakan informasi penanda untuk memantau kemajuan pekerjaan InfoSphere DataStage.
- Jika terjadi kegagalan, informasi penanda digunakan sebagai titik mulai ulang. Dalam contoh kita, ASN.IBMTabel SNAP_FEEDETL menyimpan informasi synchpoint terkait DataStage yang digunakan untuk tracKemajuan k DataStage.
Di bagian ini IBM Tutorial pelatihan DataStage, Anda harus melakukan hal-hal berikut,
- Buat tabel CAPTURE CONTROL dan tabel APPLY CONTROL untuk menyimpan opsi replikasi
- Daftarkan tabel PRODUK dan INVENTARISASI sebagai sumber replikasi
- Buat kumpulan langganan dengan dua anggota
- Buat anggota kumpulan langganan dan targetkan tabel CCD
Gunakan program baris perintah ASNCLP untuk mengatur replikasi SQL
Langkah 1) Temukan file skrip crtCtlTablesCaptureServer.asnclp di direktori sqlrepl-datastage-tutorial/setupSQLRep.
Langkah 2) Di file ganti Dan " ” dengan ID pengguna dan kata sandi Anda untuk terhubung ke database PENJUALAN.
Langkah 3) Ubah direktori ke direktori sqlrepl-datastage-tutorial/setupSQLRep dan jalankan skrip. Gunakan perintah berikut. Perintah tersebut akan terhubung ke database SALES, menghasilkan skrip SQL untuk membuat tabel kontrol Capture.
asnclp –f crtCtlTablesCaptureServer.asnclp
Langkah 4) Temukan file skrip crtCtlTablesApplyCtlServer.asnclp di direktori yang sama. Sekarang ganti dua contoh Dan " ” dengan ID pengguna dan kata sandi untuk menghubungkan ke database STAGEDB.
Langkah 5) Sekarang pada prompt perintah yang sama gunakan perintah berikut untuk membuat tabel kontrol terapan.
asnclp –f crtCtlTablesApplyCtlServer.asnclp
Langkah 6) Temukan file skrip crtRegistration.asnclp dan ganti semua instance dengan ID pengguna untuk menghubungkan ke database PENJUALAN. Juga, ubah “ ” ke kata sandi koneksi.
Langkah 7) Untuk mendaftarkan tabel sumber, gunakan skrip berikut. Sebagai bagian dari pembuatan pendaftaran, program ASNCLP akan membuat dua tabel CD. CDPRODUCT DAN CDINVENTORY.
asnclp –f crtRegistration.asnclp
Perintah CREATE REGISTRATION menggunakan opsi berikut:
- Penyegaran Diferensial: Ini meminta Terapkan program untuk memperbarui tabel target hanya ketika baris dalam tabel sumber berubah
- Gambar keduanya: Opsi ini digunakan untuk mendaftarkan nilai di kolom sumber sebelum perubahan terjadi, dan satu lagi untuk nilai setelah perubahan terjadi.
Langkah 8) Untuk menghubungkan ke basis data target (STAGEDB), gunakan langkah-langkah berikut.
- Temukan file crtTableSpaceApply.bat, buka di editor teks
- Mengganti Dan dengan ID pengguna dan kata sandi
- Di jendela perintah DB2, masukkan crtTableSpaceApply.bat dan jalankan file.
- File batch ini membuat tablespace baru pada database target (STAGEDB)
Langkah 9) Temukan file skrip crtSubscriptionSetAndAddMembers.asnclp dan lakukan perubahan berikut.
- Ganti semua contoh Dan dengan user ID dan password untuk menghubungkan ke database PENJUALAN (sumber).
- Ganti semua contoh Dan dengan ID pengguna untuk menghubungkan ke database STAGEDB (target).
Setelah perubahan, jalankan skrip untuk membuat set langganan (ST00) yang mengelompokkan tabel sumber dan target. Skrip ini juga membuat dua anggota kumpulan langganan, dan CCD (data perubahan konsisten) di database target yang akan menyimpan data yang dimodifikasi. Data ini akan digunakan oleh Infoosphere DataStage.
Langkah 10) Jalankan skrip untuk membuat kumpulan langganan, anggota kumpulan langganan, dan tabel CCD.
asnclp –f crtSubscriptionSetAndAddMembers.asnclp
Berbagai opsi yang digunakan untuk membuat kumpulan langganan dan dua anggota disertakan
- Selesai dalam keadaan kental
- Luar
- Ekspor impor jenis beban
- Waktu terus menerus
Langkah 11) Karena cacat pada alat administrasi replikasi. Anda harus menjalankan file batch lain untuk mengatur kolom TARGET_CAPTURE_SCHEMA di IBMtabel kontrol SNAP_SUBS_SET menjadi nol.
- Temukan file updateTgtCapSchema.bat. Buka di editor teks. Mengganti Dan dengan ID pengguna untuk menghubungkan ke database STAGEDB.
- Di jendela perintah DB2, masukkan perintah updateTgtCapSchema.bat dan jalankan file.
Membuat File Definisi untuk Memetakan Tabel CCD ke DataStage
Sebelum kita melakukan replikasi pada langkah selanjutnya, kita perlu menghubungkan tabel CCD dengan DataStage. Di bagian ini, kita akan melihat cara menghubungkan SQL dengan DataStage.
Untuk menghubungkan tabel CCD dengan DataStage, Anda perlu membuat file definisi DataStage (.dsx). Format file .dsx digunakan oleh DataStage untuk mengimpor dan mengekspor definisi pekerjaan. Anda akan menggunakan skrip ASNCLP untuk membuat dua file .dsx. Misalnya, di sini kami telah membuat dua file .dsx.
- stagedb_AQ00_SET00_sJobs.dsx: Membuat urutan pekerjaan yang mengarahkan alur kerja dari empat pekerjaan paralel.
- stagedb_AQ00_SET00_pJobs.dsx : Menciptakan empat pekerjaan paralel
Program ASNCLP secara otomatis memetakan kolom CCD ke format Kolom Datastage. Ini hanya didukung ketika ASNCLP berjalan Windows, Linux, atau Prosedur Unix.

Pekerjaan datastage menarik baris dari tabel CCD.
- Satu pekerjaan menetapkan titik sinkronisasi di mana DataStage berhenti sebelumnya.tracmengambil data dari kedua tabel. Job tersebut mendapatkan informasi ini dengan memilih nilai SYNCHPOINT untuk set langganan ST00 dari IBMTabel SNAP_SUBS_SET dan memasukkannya ke dalam kolom MAX_SYNCHPOINT IBMtabel SNAP_FEEDETL.
- Dua pekerjaan yang pernahtracData dari tabel PRODUCT_CCD dan INVENTORY_CCD. Job tersebut mengetahui baris mana yang harus mulai diproses.tracdengan memilih nilai MIN_SYNCHPOINT dan MAX_SYNCHPOINT dari IBMTabel SNAP_FEEDETL untuk kumpulan langganan.
Setelah definisi dipetakan, replikasi dapat dimulai sehingga tabel CCD mulai terisi.
Memulai Replikasi
Untuk memulai replikasi, Anda akan menggunakan langkah-langkah di bawah ini. Ketika tabel CCD diisi dengan data, ini menunjukkan pengaturan replikasi telah divalidasi. Untuk melihat data yang direplikasi dalam tabel CCD target, gunakan antarmuka pengguna grafis Pusat Kontrol DB2.
Langkah 1) Pastikan DB2 berjalan jika tidak maka gunakan db2 mulai perintah.
Langkah 2) Kemudian gunakan perintah asncap dari prompt sistem operasi untuk mulai menangkap program. Misalnya.
asncap capture_server=SALES
Perintah di atas menentukan database PENJUALAN sebagai server Capture. Biarkan jendela perintah tetap terbuka saat pengambilan sedang berjalan.
Langkah 3) Sekarang buka prompt perintah baru. Kemudian mulai BERLAKU program dengan menggunakan perintah asnapply.
asnapply control_server=STAGEDB apply_qual=AQ00

- Perintah tersebut menentukan database STAGEDB sebagai server kontrol Terapkan (database yang berisi tabel kontrol Terapkan)
- AQ00 sebagai kualifikasi Terapkan (pengidentifikasi untuk kumpulan tabel kontrol ini)
Biarkan jendela perintah terbuka dengan Terapkan sedang berjalan.
Langkah 4) Sekarang buka command prompt lain dan jalankan perintah db2cc untuk meluncurkan Pusat Kontrol DB2. Terima Pusat Kontrol default.
Langkah 5) Sekarang di pohon navigasi kiri, buka All Databases > STAGEDB dan kemudian klik Tables. Double klik pada nama tabel (Produk CCD) untuk membuka tabel. Ini akan terlihat seperti ini.

Demikian pula, Anda juga dapat membuka tabel CCD untuk INVENTORY.

Replikasi kini memasukkan data ke tabel CCD, sehingga perhatian beralih dari sisi basis data ke klien DataStage.
Cara Membuat Proyek di Alat Datastage
Pertama-tama, Anda akan membuat Proyek di DataStage. Untuk itu, Anda harus menjadi administrator InfoSphere DataStage.
Setelah Instalasi dan replikasi selesai, Anda perlu membuat proyek. Di DataStage, proyek adalah metode untuk mengatur data Anda. Ini mencakup pendefinisian file data, tahapan, dan membangun pekerjaan dalam proyek tertentu.
Untuk membuat proyek di DataStage, ikuti langkah-langkah di bawah ini:
Langkah 1) Luncurkan perangkat lunak DataStage
Luncurkan Administrator DataStage dan QualityStage. Kemudian klik Mulai > Semua program > IBM Server Informasi > IBM Administrator DataStage WebSphere dan QualityStage.
Langkah 2) Hubungkan server dan klien DataStage
Untuk menghubungkan ke server DataStage dari klien DataStage Anda, masukkan rincian seperti Nama domain, ID pengguna, kata sandi, dan informasi server.
Langkah 3) Tambahkan Proyek Baru
Di jendela Administrasi WebSphere DataStage. Klik tab Proyek lalu klik Tambah.
Langkah 4) Masukkan detail proyek
Di jendela Administrasi WebSphere DataStage, masukkan detail seperti
- Nama
- Lokasi berkas
- Klik 'OK'

Setiap proyek berisi:
- Pekerjaan DataStage
- Komponen bawaan. Ini adalah komponen yang telah ditentukan sebelumnya yang digunakan dalam suatu pekerjaan.
- Komponen yang ditentukan pengguna. Ini adalah komponen khusus yang dibuat menggunakan DataStage Manager atau DataStage Designer.
Kita akan melihat cara mengimpor pekerjaan replikasi di Datastage Infoosphere.
Cara Mengimpor Pekerjaan Replikasi di Datastage dan QualityStage Designer
Anda akan mengimpor pekerjaan di IBM Klien InfoSphere DataStage dan QualityStage Designer. Dan Anda mengeksekusinya di IBM Klien InfoSphere DataStage dan QualityStage Director.
Klien-desainer ibarat kanvas kosong untuk proyek pembangunan.tracts, transformasi, pemuatan, dan pengecekan kualitas data. Ini menyediakan alat-alat yang membentuk blok bangunan dasar dari sebuah Job. Ini termasuk
- magang: Terhubung ke sumber data untuk membaca atau menulis file dan memproses data.
- Link: Ini menghubungkan tahapan sepanjang aliran data Anda
Tahapan di klien InfoSphere DataStage dan QualityStage Designer disimpan di palet alat Designer.
Tahapan berikut termasuk dalam InfoSphere QualityStage:
- Tahap selidiki
- Tahap standarisasi
- Tahap Frekuensi Pencocokan
- Tahap Pertandingan satu sumber
- Tahap Pertandingan dua sumber
- Tahap bertahan hidup
- Tahap Penilaian Mutu Standardisasi (SQA).
Anda dapat membuat 4 jenis Pekerjaan di infosfer DataStage.
- Pekerjaan Paralel
- Urutan Pekerjaan
- Pekerjaan Mainframe
- Pekerjaan Server
Mari kita lihat langkah demi langkah tentang cara mengimpor file pekerjaan replikasi.
Langkah 1) Mulai DataStage dan QualityStage Designer. Klik Mulai > Semua program > IBM Server Informasi > IBM WebSphere DataStage dan Desainer QualityStage
Langkah 2) Pada jendela Lampirkan ke Proyek, masukkan rincian berikut.
- Domain
- Nama pengguna
- Kata Sandi
- Nama Proyek
- OK

Langkah 3) Sekarang dari menu File klik impor -> Komponen Tahap Data.
Jendela Impor Repositori DataStage baru akan terbuka.
- Di jendela ini jelajahi STAGEDB_AQ00_ST00_sJobs.dsx file yang telah kita buat sebelumnya
- Pilih opsi “Impor semua.”
- Centang kotak “Lakukan Analisis Dampak”.
- Klik 'OK'.

Setelah tugas diimpor, DataStage akan membuat tugas STAGEDB_AQ00_ST00_sequence.
Langkah 4) Ikuti langkah yang sama untuk mengimpor File STAGEDB_AQ00_ST00_pJobs.dsx. Impor ini menciptakan empat lapangan kerja paralel.
Langkah 5) Di bawah panel Repositori Desainer -> Buka folder SQLREP. Di dalam folder tersebut, Anda akan melihat, Urutan Pekerjaan dan empat pekerjaan paralel.
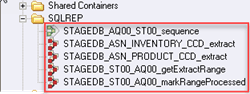
Langkah 6) Untuk melihat urutan pekerjaan. Buka pohon repositori, klik kanan pekerjaan STAGEDB_AQ00_ST00_sequence dan klik Edit. Ini akan menunjukkan alur kerja dari empat pekerjaan paralel yang dikontrol urutan pekerjaan.

Setiap ikon adalah panggung,
- getExtracTahap jangkauan: Ini memperbarui IBMTabel SNAP_FEEDETL. Tabel ini akan menetapkan titik awal untuk data extracsampai pada titik di mana DataStage terakhir kalitracbaris yang telah ditentukan dan menetapkan titik akhir ke transaksi terakhir yang diproses untuk set langganan tersebut.
- getExtractRangeSuccessTahap ini memberikan titik awal kepada extractFromINVENTORY_CCD stage and extracTahap tFromPRODUCT_CCD
- AllExtractsSukses: Tahap ini memastikan bahwa kedua mantantractFromINVENTORY_CCD dan extractFromPRODUCT_CCD berhasil diselesaikan. Kemudian meneruskan titik sinkronisasi untuk baris terakhir yang diambil ke tahap setRangeProcessed.
- tahap setRangeProcessed: Ini diperbarui IBMTabel SNAP_FEEDETL. Jadi, DataStage tahu dari mana harus memulai putaran data berikutnya.tracproduksi
Langkah 7) Untuk melihat pekerjaan paralel. Klik kanan STAGEDB_ASN_INVENTORY_CCD dan pilih edit di bawah repositori. Ini akan membuka jendela seperti yang ditunjukkan di bawah ini.

Di sini, di gambar di atas, Anda dapat melihat data dari tabel CCD Inventaris dan SyncRincian titik h dari tabel FEEDETL ditampilkan ke tahap Lookup_6.
Pekerjaan yang diimpor masih belum mengarah ke mana pun, jadi objek koneksi data harus didefinisikan selanjutnya.
Membuat Koneksi Data dari DataStage ke Database STAGEDB
Sekarang langkah selanjutnya adalah membangun koneksi data antara InfoSphere DataStage dan database target Replikasi SQL. Ini berisi tabel CCD.
Di DataStage, Anda menggunakan objek koneksi data dengan tahapan konektor terkait untuk dengan cepat menentukan koneksi ke sumber data dalam desain pekerjaan.
Langkah 1) STAGEDB berisi tabel kontrol Apply yang digunakan DataStage untuk menyinkronkan datanya, misalnyatracdan tabel CCD dari mana data tersebut diambil.tracted. Gunakan perintah berikut
db2 catalog tcpip node SQLREP remote ip_address server 50000
db2 catalog database STAGEDB as STAGEDB2 at node SQLREP
Note: Alamat IP sistem tempat STAGEDB dibuat
Langkah 2) Klik File > Baru > Lainnya > Sambungan Data.
Langkah 3) Anda akan memiliki jendela dengan dua tab, Parameter, dan Umum.

Langkah 4) Pada langkah ini,
- Secara umum, tab, beri nama koneksi data sqlreplConnect
- Di tab Parameter, seperti yang ditunjukkan di bawah ini
- Klik tombol telusuri di sebelah 'Hubungkan menggunakan bidang Tipe Panggung', dan di
- Buka jendela, navigasikan pohon repositori ke Tipe Tahap -> Paralel– > Basis Data —-> Konektor DB2.
- Klik Buka.

Langkah 5) Pada tabel parameter Koneksi, masukkan detail seperti
- KoneksiString: STAGEDB2
- Nama Pengguna: ID Pengguna untuk menghubungkan ke database STAGEDB
- Kata Sandi: Kata sandi untuk menghubungkan ke database STAGEDB
- Contoh: Nama instans DB2 yang berisi database STAGEDB
Langkah 6) Di jendela berikutnya simpan koneksi data. Klik tombol 'simpan'.
Mengimpor Definisi Tabel dari STAGEDB ke DataStage
Pada langkah sebelumnya, kita melihat InfoSphere DataStage dan database STAGEDB terhubung. Sekarang, impor definisi kolom dan metadata lainnya untuk tabel PRODUCT_CCD dan INVENTORY_CCD ke dalam repositori Server Informasi.
Di jendela desainer, ikuti langkah-langkah di bawah ini.
Langkah 1) Pilih Impor > Definisi Tabel > Mulai Wizard Impor Konektor
Langkah 2) Dari halaman pemilihan konektor di wizard, pilih Konektor DB2 dan klik Berikutnya.

Langkah 3) Klik muat pada halaman detail koneksi. Ini akan mengisi kolom wizard dengan informasi koneksi dari koneksi data yang Anda buat di bab sebelumnya.

Langkah 4) Klik Uji koneksi di halaman yang sama. Ini akan meminta DataStage untuk mencoba koneksi ke database STAGEDB. Anda dapat melihat pesan “koneksi berhasil”. Klik Berikutnya.

Langkah 5) Pastikan pada halaman Lokasi sumber data, bidang Nama Host dan Nama database diisi dengan benar. Kemudian klik berikutnya.
Langkah 6) Di halaman Skema. Masukkan skema Terapkan tabel kontrol (ASN) atau periksa apakah skema ASN sudah diisi sebelumnya ke dalam bidang skema. Kemudian klik berikutnya. Halaman pilihan akan menampilkan daftar tabel yang ditentukan dalam Skema ASN.

Langkah 7) Tabel pertama yang kita perlukan untuk mengimpor metadata adalah IBMSNAP_FEEDETL, sebuah tabel kontrol Apply. Tabel ini berisi detail tentang titik sinkronisasi yang memungkinkan DataStage untuk terus memperbarui data. track baris mana yang telah diambil dari tabel CCD. Pilih IBMSNAP_FEEDETL dan klik Berikutnya.
Langkah 8) Untuk menyelesaikan impor IBMDefinisi tabel SNAP_FEEDETL. Klik impor dan kemudian di jendela yang terbuka klik buka.
Langkah 9) Ulangi langkah 1-8 dua kali lagi untuk mengimpor definisi tabel PRODUCT_CCD dan kemudian tabel INVENTORY_CCD.
CATATAN: Saat mengimpor definisi untuk inventaris dan produk, pastikan Anda mengubah skema dari ASN ke skema tempat PRODUCT_CCD dan INVENTORY_CCD dibuat.
Sekarang DataStage memiliki semua rincian yang dibutuhkan untuk terhubung ke database target Replikasi SQL.
Mengatur Properti untuk Pekerjaan DataStage
Untuk masing-masing dari empat pekerjaan paralel DataStage yang kami miliki, ini berisi satu atau lebih tahapan yang terhubung dengan database STAGEDB. Anda perlu mengubah tahapan untuk menambahkan informasi koneksi dan menautkan ke file himpunan data yang diisi DataStage.
Tahapan memiliki properti yang telah ditentukan sebelumnya dan dapat diedit. Di sini kita akan mengubah beberapa properti ini untuk STAGEDB_ASN_PRODUCT_CCD_ex.tracpekerjaan paralel.
Langkah 1) Telusuri struktur repositori Designer. Di bawah folder SQLREP, pilih STAGEDB_ASN_PRODUCT_CCD_ex.tracUntuk mengedit, klik kanan pada pekerjaan paralel. Jendela desain pekerjaan paralel akan terbuka di Palet Desainer.
Langkah 2) Cari ikon hijau. Ikon ini menandakan tahap konektor DB2. Ini digunakan untuk misalnyatracmengambil data dari tabel CCD. Double-klik ikonnya. Jendela editor panggung terbuka.


Langkah 3) Di editor, klik Muat untuk mengisi kolom dengan informasi koneksi. Untuk menutup editor panggung dan menyimpan perubahan Anda, klik OK.
Langkah 4) Sekarang kembali ke jendela desain untuk STAGEDB_ASN_PRODUCT_CCD_extracpekerjaan paralel. Temukan ikon untuk mendapatkannya.SyncTahap konektor DB2 hPoints. Kemudian klik dua kali ikon tersebut.
Langkah 5) Sekarang klik tombol muat untuk mengisi kolom dengan informasi koneksi.
CATATAN: Jika Anda menggunakan database selain STAGEDB sebagai server kontrol Terapkan. Kemudian pilih opsi untuk memuat informasi koneksi untuk didapatSynctahap hPoints, yang berinteraksi dengan tabel kontrol, bukan tabel CCD.
Langkah 6) Pada langkah ini,
- Buat file teks kosong di sistem tempat InfoSphere DataStage dijalankan.
- Beri nama file ini sebagai productdataset.ds dan catat di mana Anda menyimpannya.
- DataStage akan menulis perubahan pada file ini setelah mengambil perubahan dari tabel CCD.
- Kumpulan data atau file yang digunakan untuk memindahkan data antar pekerjaan tertaut dikenal sebagai kumpulan data persisten. Itu diwakili oleh tahap DataSet.
Langkah 7) Sekarang buka editor stage di jendela desain, lalu klik dua kali pada ikon insert_into_a_dataset. Jendela lain akan terbuka.

Langkah 8) Di jendela ini,

- Di bawah tab properti pastikan Target folder terbuka dan properti File = DATASETNAME disorot.
- Di sebelah kanan, Anda akan memiliki kolom file
- Masukkan path lengkap ke file productdataset.ds
- Klik 'OK'.
Anda sekarang telah memperbarui semua properti yang diperlukan untuk tabel CCD produk. Tutup jendela desain dan simpan semua perubahan.
Langkah 9) Sekarang temukan dan buka STAGEDB_ASN_INVENTORY_CCD_extracJalankan pekerjaan paralel dari panel repositori Designer dan ulangi Langkah 3-8.
CATATAN:
- Anda harus memuat informasi koneksi untuk database server kontrol ke dalam editor panggung untuk mendapatkannyaSynctahap hPoints. Jika server kontrol Anda bukan STAGEDB.
- Untuk STAGEDB_ST00_AQ00_getExtractRange dan STAGEDB_ST00_AQ00_markRangeProcessed pekerjaan paralel, buka semua tahapan konektor DB2. Kemudian gunakan fungsi load untuk menambahkan informasi koneksi untuk database STAGEDB.
Semua properti telah diatur, sehingga pekerjaan dapat dikompilasi dan dieksekusi.
Mengompilasi dan Menjalankan Pekerjaan DataStage
Saat pekerjaan DataStage siap dikompilasi, Desainer memvalidasi desain pekerjaan dengan melihat masukan, transformasi, ekspresi, dan detail lainnya.
Ketika kompilasi pekerjaan selesai dengan sukses, maka siap dijalankan. Kami akan mengkompilasi kelima pekerjaan, tetapi hanya akan menjalankan “urutan pekerjaan”. Hal ini karena pekerjaan ini mengontrol keempat pekerjaan paralel.
Langkah 1) Di bawah folder SQLREP. Pilih masing-masing dari lima pekerjaan dengan (Cntrl+Shift). Kemudian klik kanan dan pilih opsi Kompilasi beberapa pekerjaan.

Langkah 2) Anda akan melihat lima pekerjaan dipilih di Wizard Kompilasi DataStage. Klik Berikutnya.

Langkah 3) Kompilasi dimulai dan menampilkan pesan “Kompilasi berhasil” setelah selesai.

Langkah 4) Sekarang mulai DataStage dan QualityStage Director. Pilih Mulai > Semua program > IBM Server Informasi > IBM Direktur WebSphere DataStage dan QualityStage.
Langkah 5) Di panel navigasi proyek di sebelah kiri. Klik folder SQLREP. Ini membawa kelima pekerjaan ke dalam tabel status direktur.
Langkah 6) Pilih pekerjaan STAGEDB_AQ00_S00_sequence. Dari bilah menu, klik Pekerjaan > Jalankan Sekarang.

Setelah kompilasi selesai, Anda akan melihat status selesai.

Sekarang periksa apakah baris yang diubah yang tersimpan di tabel PRODUCT_CCD dan INVENTORY_CCD telah dihapus.tracDiproses oleh DataStage dan dimasukkan ke dalam dua file kumpulan data.
Langkah 7) Kembali ke Designer dan buka STAGEDB_ASN_PRODUCT_CCD_extracpekerjaan t. Untuk membuka editor panggung Double-klik ikon insert_into_a_dataset. Lalu klik lihat data.
Langkah 8) Terima nilai default pada baris yang akan ditampilkan. Lalu klik OK. Jendela peramban data akan terbuka untuk menampilkan isi berkas kumpulan data.

Menguji Integrasi Antara Replikasi SQL dan DataStage
Pada langkah sebelumnya, kami mengkompilasi dan mengeksekusi pekerjaan. Di bagian ini, kita akan memeriksa integrasi replikasi SQL dan DataStage. Untuk itu, kami akan membuat perubahan pada tabel sumber dan melihat apakah perubahan yang sama diperbarui ke DataStage.
Langkah 1) Arahkan ke folder sqlrepl-datastage-scripts untuk sistem operasi Anda.
Langkah 2) Mulai Replikasi SQL dengan langkah-langkah berikut:
- Jalankan startSQLCapture.bat (Windows) file untuk memulai program Capture di database PENJUALAN.
- Jalankan startSQLAply.bat (Windows) file untuk memulai program Terapkan di database STAGEDB.
Langkah 3) Sekarang buka file updateSourceTables.sql. Untuk menghubungkan ke database PENJUALAN ganti Dan dengan ID pengguna dan kata sandi.
Langkah 4) Buka jendela perintah DB2. Ubah direktori menjadi sqlrepl-datastage-tutorial\scripts, dan jalankan masalah dengan perintah yang diberikan:
db2 -tvf updateSourceTables.sql
Script SQL akan melakukan berbagai operasi seperti Update, Insert dan delete pada kedua tabel (PRODUK, INVENTORY) di database Penjualan.
Langkah 5) Pada sistem tempat DataStage berjalan. Buka DataStage Director dan jalankan pekerjaan STAGEDB_AQ00_S00_sequence. Klik Pekerjaan > Jalankan Sekarang.

Ketika Anda menjalankan pekerjaan, aktivitas berikut akan dilakukan.
- Program Capture membaca perubahan enam baris dalam log database PENJUALAN dan memasukkannya ke dalam tabel CD.
- Program Apply mengambil baris perubahan dari tabel CD di SALES dan memasukkannya ke dalam tabel CCD di STAGEDB.
- Kedua DataStage tersebuttracTugas-tugas tersebut mengambil perubahan dari tabel CCD dan menuliskannya ke file productdataset.ds dan inventory dataset.ds.
Anda dapat memeriksa apakah langkah-langkah di atas telah dilakukan dengan melihat kumpulan data.
Langkah 6) Ikuti langkah-langkah di bawah ini,
- Mulai Designer. Buka STAGEDB_ASN_PRODUCT_CCD_extracpekerjaan t.
- Kemudian Double-klik ikon insert_into_a_dataset. Di editor panggung. Klik Lihat Data.
- Terima default di baris jendela yang akan ditampilkan dan klik OK.
Kumpulan data berisi tiga baris baru. Cara termudah untuk memeriksa penerapan perubahan adalah dengan menggulir ke bawah paling kanan dari Peramban Data. Sekarang lihat tiga baris terakhir (lihat gambar di bawah)

Huruf I, U dan D menentukan operasi INSERT, UPDATE dan DELETE yang menghasilkan setiap baris baru.
Anda dapat melakukan pemeriksaan yang sama untuk tabel Inventaris.
DataStage vs Alat ETL Populer Lainnya
Setelah alur kerja ujung-ke-ujung berjalan dengan baik, pertanyaan selanjutnya yang biasa muncul adalah bagaimana posisi DataStage dibandingkan dengan alternatif yang mungkin sudah dimiliki tim. Tabel di bawah ini membandingkannya dengan tiga platform yang banyak digunakan berdasarkan kriteria yang paling sering menentukan keputusan pembelian.
| Kriteria | IBM Data Stage | Informatika Pusat Daya | Talend | SSIS |
|---|---|---|---|---|
| Model pemrosesan | Paralelisme pipeline plus partisi | Pemartisian berbasis metadata | Dihasilkan Java or Spark kode | Aliran data dalam memori |
| Paling cocok | Beban kerja batch dan CDC perusahaan yang sangat besar | Arsitektur lama yang kompleks dengan tata kelola yang ketat. | Tim yang berbasis cloud dan peka terhadap biaya. | Microsoft SQL Server perkebunan |
| Perizinan | Komersial, tingkat premium | Komersial | Edisi sumber terbuka plus tingkatan komersial | Disertai dengan SQL Server |
| Kurva belajar | Steep, spesialis ETL dibutuhkan | Curam | Tingkat kesulitan sedang, kemampuan pemrograman akan sangat membantu. | Moderat |
| Kualitas data | QualityStage termasuk dalam paket perangkat lunak ini. | Produk Kualitas Data Terpisah | Kualitas Data Talend disertakan | Komponen tambahan |
Singkatnya, DataStage dipilih ketika throughput mentah, jangkauan mainframe, dan silsilah yang siap diaudit lebih penting daripada biaya lisensi. Tim yang sebagian besar bekerja di cloud. arsitektur danau data atau membandingkan contohtracUrutan pertama mungkin menemukan kompromi dalam ETL vs ELT lebih relevan, dan daftar pendek yang lebih luas muncul dalam rangkuman Alat ETL ke alat integrasi data.
