
Tutorial Apache Flume: Apa itu, Archicontoh tekstur & Hadoop
 Prafulla Ranadive
⚡ Ringkasan Cerdas
Apache Flume adalah layanan terdistribusi untuk mengumpulkan, menggabungkan, dan memindahkan sejumlah besar data log ke HDFS, yang dibangun di sekitar agen yang menghubungkan sumber, saluran, dan tujuan secara berantai.
Apa itu Apache Flume di Hadoop?
Apache Flume adalah sistem yang andal dan terdistribusi untuk mengumpulkan, menggabungkan, dan memindahkan sejumlah besar data log. Sistem ini memiliki arsitektur yang sederhana namun fleksibel berdasarkan aliran data streaming. Apache Flume digunakan untuk mengumpulkan data log yang terdapat dalam file log dari server web dan menggabungkannya menjadi beberapa bagian. HDFS untuk analisis.
Flume di Hadoop mendukung berbagai sumber, termasuk:
- 'tail' (yang mengalirkan data dari file lokal dan menuliskannya ke HDFS melalui Flume, mirip dengan perintah Unix 'tail')
- Log sistem
- Apache log4j (yang memungkinkan) Java aplikasi untuk menulis acara ke file dalam HDFS melalui Flume).
Rilis saat ini adalah Flume 1.11.0, diterbitkan pada 25 Oktober 2022 dan tersedia dari Halaman unduhan Apache FlumePanduan ini ditulis berdasarkan versi 1.4.0, jadi beberapa langkah di bawah ini memiliki catatan di mana versi terbaru berperilaku berbeda.
Mengalir Architekstur
Agen Flume adalah seorang FMV Suatu proses dengan tiga komponen – sumber Flume, saluran Flume, dan sink Flume – di mana peristiwa merambat setelah dipicu di sumber eksternal. Diagram di bawah ini menunjukkan bagaimana ketiganya terhubung.
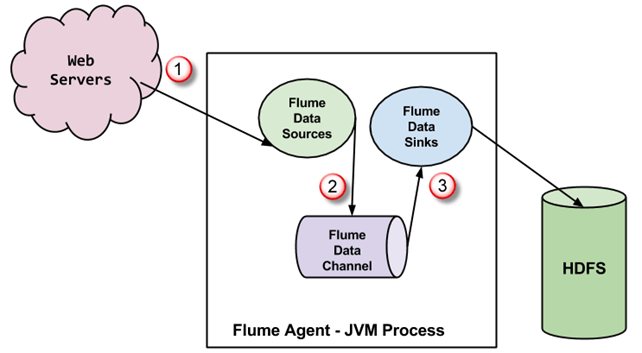
- Peristiwa yang dihasilkan oleh sumber eksternal (server web) dikonsumsi oleh sumber Flume. Sumber eksternal mengirimkan peristiwa ke sumber Flume dalam format yang dikenali oleh sumber target.
- Sumber Flume menerima sebuah peristiwa dan menyimpannya ke dalam satu atau lebih saluran. Saluran tersebut bertindak sebagai penyimpanan yang menjaga peristiwa tersebut hingga dikonsumsi oleh penerima Flume. Saluran ini dapat menggunakan sistem file lokal untuk menyimpan peristiwa-peristiwa ini.
- Flume sink menghapus event dari sebuah channel dan menyimpannya ke dalam repositori eksternal seperti HDFS. Mungkin ada beberapa agent Flume, dalam hal ini Flume sink meneruskan event tersebut ke source Flume dari agent berikutnya dalam alur kerja.
Beberapa Fitur Penting dari Flume
- Flume memiliki desain fleksibel yang berbasis pada aliran data streaming. Sistem ini toleran terhadap kesalahan dan tangguh, dengan berbagai mekanisme failover dan pemulihan. Flume menawarkan berbagai tingkat keandalan, termasuk 'pengiriman upaya terbaik' ke 'pengiriman ujung ke ujung'. Pengiriman dengan upaya terbaik tidak mentolerir kegagalan node Flume apa pun, sedangkan pengiriman ujung ke ujung menjamin pengiriman bahkan jika terjadi kegagalan pada beberapa node.
- Flume mentransfer data antara sumber dan tujuan. Pengumpulan data ini dapat dijadwalkan atau berdasarkan peristiwa. Flume memiliki mesin pemrosesan kueri sendiri, yang memudahkan transformasi setiap kumpulan data baru sebelum dipindahkan ke tujuan yang dimaksud.
- Mungkin Flume tenggelam termasuk HDFS dan HBaseFlume juga dapat mentransfer data peristiwa seperti data lalu lintas jaringan, data yang dihasilkan oleh situs web media sosial, dan pesan email.
Penyiapan Flume, pustaka, dan kode sumber
Sebelum kita memulai proses sebenarnya, pastikan Anda telah menginstal Hadoop; jika belum, ikuti langkah-langkah berikut. cara menginstal Hadoop Pertama, ubah pengguna menjadi 'hduser' (ID yang digunakan saat mengkonfigurasi Hadoop; Anda dapat beralih ke ID pengguna yang digunakan selama konfigurasi Hadoop Anda sendiri).

Langkah 1) Buat direktori baru dengan nama 'FlumeTutorial'.
sudo mkdir FlumeTutorial
- Berikan izin baca, tulis, dan eksekusi.
sudo chmod -R 777 FlumeTutorial
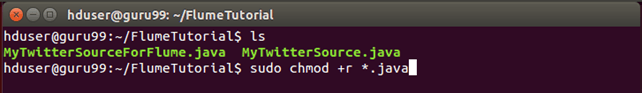
- Salin file-file tersebut Sumber Twitter Saya.java ke MyTwitterSourceForFlume.java ke dalam direktori ini.
Periksa izin akses semua file ini, seperti di bawah ini, dan berikan izin 'baca' jika izin tersebut belum ada.
Langkah 2) Unduh 'Apache Flume' dari https://flume.apache.org/download.html.
Apache Flume 1.4.0 telah digunakan dalam tutorial Flume ini.

Selanjutnya, klik tautan ke halaman mirror.

Langkah 3) Salin file tarball yang diunduh ke direktori pilihan Anda dan jalankan.tracTampilkan isi menggunakan perintah berikut.
sudo tar -xvf apache-flume-1.4.0-bin.tar.gz

Ini akan membuat direktori baru bernama apache-flume-1.4.0-bin dan extracmemasukkan file-file tersebut ke dalamnya. Direktori tersebut disebut sebagai di bagian selanjutnya dari artikel ini.
Langkah 4) Instalasi pustaka Flume. Salin twitter4j-core-4.0.1.jar, flume-ng-configuration-1.4.0.jar, flume-ng-core-1.4.0.jar dan flume-ng-sdk-1.4.0.jar ke
/lib/
Salah satu atau semua file JAR yang disalin mungkin memiliki izin eksekusi, yang dapat menyebabkan masalah pada kompilasi kode, jadi cabut izin tersebut. Dalam kasus saya, twitter4j-core-4.0.1.jar memiliki izin eksekusi. Saya mencabutnya seperti di bawah ini.
sudo chmod -x twitter4j-core-4.0.1.jar

Setelah itu, perintah di bawah ini memberikan izin 'baca' pada twitter4j-core-4.0.1.jar kepada semua pengguna.
sudo chmod +rrr /usr/local/apache-flume-1.4.0-bin/lib/twitter4j-core-4.0.1.jar
Harap dicatat bahwa saya mengunduh twitter4j-core-4.0.1.jar dari Repositori Maven, dan semua JAR Flume, yaitu flume-ng-*-1.4.0.jar, dari artefak org.apache.flume.
Muat data dari Twitter menggunakan Flume
Langkah 1) Masuk ke direktori yang berisi file kode sumber.
Langkah 2) Atur CLASSPATH agar berisi /lib/* dan ~/FlumeTutorial/flume/mytwittersource/*.
export CLASSPATH="/usr/local/apache-flume-1.4.0-bin/lib/*:~/FlumeTutorial/flume/mytwittersource/*"

Langkah 3) Kompilasi kode sumber menggunakan perintah di bawah ini.
javac -d . MyTwitterSourceForFlume.java MyTwitterSource.java

Langkah 4) Buat file JAR. Pertama, buat file Manifest.txt menggunakan editor teks pilihan Anda dan tambahkan baris di bawah ini ke dalamnya.
Main-Class: flume.mytwittersource.MyTwitterSourceForFlume
Di sini, `flume.mytwittersource.MyTwitterSourceForFlume` adalah nama kelas utama. Harap perhatikan bahwa Anda harus menekan tombol Enter di akhir baris ini, seperti yang ditunjukkan di bawah ini.

Sekarang, buat file JAR 'MyTwitterSourceForFlume.jar' sebagai berikut.
jar cfm MyTwitterSourceForFlume.jar Manifest.txt flume/mytwittersource/*.class

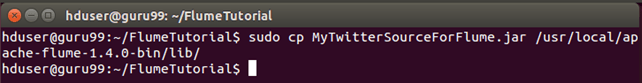
Langkah 5) Salin file JAR ini ke /lib/.
sudo cp MyTwitterSourceForFlume.jar <Flume Installation Directory>/lib/
Langkah 6) Masuk ke direktori konfigurasi Flume, /konflik.
Jika file flume.conf tidak ada, salin file flume-conf.properties.template dan ganti namanya menjadi flume.conf.
sudo cp flume-conf.properties.template flume.conf

Jika file flume-env.sh tidak ada, salin file flume-env.sh.template dan ganti namanya menjadi flume-env.sh.
sudo cp flume-env.sh.template flume-env.sh

Membuat Aplikasi Twitter
Baca ini dulu. Streaming v1.1 statuses/filter Endpoint yang dibutuhkan twitter4j 4.0.1 telah dihentikan pada 9 Maret 2023, dan API v2 yang memfilter aliran yang menggantikannya, sekarang berada di pengembang.x.com, berada di balik tingkatan berbayar. Perlakukan layar di bawah ini sebagai pola sumber kustom, lalu arahkan agen yang sama ke file, eksekusi, atau sumber Kafka.
Langkah 1) Buat aplikasi Twitter dengan masuk ke portal pengembang.


Langkah 2) Buka 'Aplikasi saya' (opsi ini akan muncul saat tombol 'Telur' di pojok kanan atas diklik).

Langkah 3) Buat aplikasi baru dengan mengklik 'Buat Aplikasi Baru'.
Langkah 4) Isilah detail aplikasi dengan menentukan nama aplikasi, deskripsi, dan situs web. Anda dapat merujuk pada catatan yang diberikan di bawah setiap kotak input.
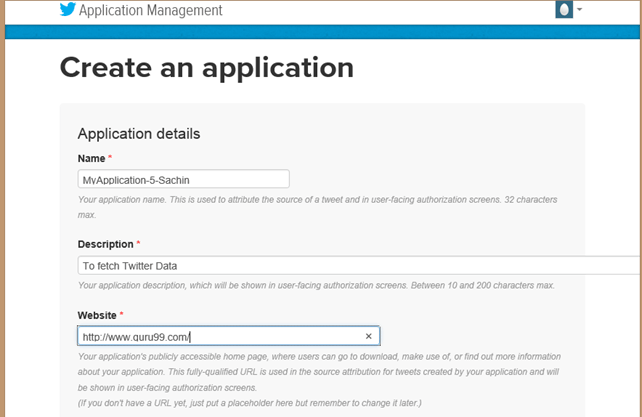
Langkah 5) Gulir ke bawah halaman, setujui persyaratan dengan memberi tanda 'Ya, saya setuju' dan klik tombol 'Buat aplikasi Twitter Anda'.

Langkah 6) Pada jendela aplikasi yang baru dibuat, buka tab 'Kunci API', gulir ke bawah halaman, lalu klik tombol 'Buat token akses saya'.


Langkah 7) Segarkan halaman.
Langkah 8) Klik 'Uji OAuth'. Ini akan menampilkan pengaturan 'OAuth' aplikasi.

Langkah 9) Ubah file 'flume.conf' menggunakan pengaturan OAuth ini. Langkah-langkah untuk mengubah file 'flume.conf' diberikan di bawah ini.

Kita perlu menyalin kunci konsumen, rahasia konsumen, token akses, dan rahasia token akses untuk memperbarui 'flume.conf'.
Catatan: Nilai-nilai ini milik pengguna dan karenanya bersifat rahasia, jadi tidak boleh dibagikan.
Ubah File 'flume.conf'
Langkah 1) Buka 'flume.conf' dalam mode tulis dan atur nilai untuk parameter di bawah ini.
sudo gedit flume.conf
Salin isi di bawah ini.
MyTwitAgent.sources = Twitter
MyTwitAgent.channels = MemChannel
MyTwitAgent.sinks = HDFS
MyTwitAgent.sources.Twitter.type = flume.mytwittersource.MyTwitterSourceForFlume
MyTwitAgent.sources.Twitter.channels = MemChannel
MyTwitAgent.sources.Twitter.consumerKey = <Copy consumer key value from Twitter App>
MyTwitAgent.sources.Twitter.consumerSecret = <Copy consumer secret value from Twitter App>
MyTwitAgent.sources.Twitter.accessToken = <Copy access token value from Twitter App>
MyTwitAgent.sources.Twitter.accessTokenSecret = <Copy access token secret value from Twitter App>
MyTwitAgent.sources.Twitter.keywords = guru99
MyTwitAgent.sinks.HDFS.channel = MemChannel
MyTwitAgent.sinks.HDFS.type = hdfs
MyTwitAgent.sinks.HDFS.hdfs.path = hdfs://localhost:54310/user/hduser/flume/tweets/
MyTwitAgent.sinks.HDFS.hdfs.fileType = DataStream
MyTwitAgent.sinks.HDFS.hdfs.writeFormat = Text
MyTwitAgent.sinks.HDFS.hdfs.batchSize = 1000
MyTwitAgent.sinks.HDFS.hdfs.rollSize = 0
MyTwitAgent.sinks.HDFS.hdfs.rollCount = 10000
MyTwitAgent.channels.MemChannel.type = memory
MyTwitAgent.channels.MemChannel.capacity = 10000
MyTwitAgent.channels.MemChannel.transactionCapacity = 1000

Langkah 2) Selain itu, atur TwitterAgent.sinks.HDFS.hdfs.path seperti di bawah ini.
TwitterAgent.sinks.HDFS.hdfs.path = hdfs:// : / /flume/tweet/

Untuk menemukan , Dan , lihat nilai parameter 'fs.defaultFS' yang diatur dalam $HADOOP_HOME/etc/hadoop/core-site.xml, seperti yang ditunjukkan di bawah ini.

Langkah 3) Untuk memindahkan data ke HDFS saat data tersebut tiba, hapus entri di bawah ini jika ada.
TwitterAgent.sinks.HDFS.hdfs.rollInterval = 600
Contoh: Streaming Data Twitter menggunakan Flume
Langkah 1) Buka 'flume-env.sh' dalam mode tulis dan atur nilai untuk parameter di bawah ini.
JAVA_HOME=<Installation directory of Java>
FLUME_CLASSPATH="<Flume Installation Directory>/lib/MyTwitterSourceForFlume.jar"

Langkah 2) Mulai Hadoop.
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Langkah 3) Dua file JAR dari tarball Flume tidak kompatibel dengan Hadoop 2.2.0, jadi dalam contoh Apache Flume ini kita mengikuti langkah-langkah di bawah ini untuk membuat Flume kompatibel dengan Hadoop 2.2.0. Penggantian JAR ini adalah perbaikan era 1.4.0; Flume 1.11.0 sudah menyertakan build protobuf dan Guava terbaru, jadi tarball modern biasanya tidak memerlukannya.
a. Pindahkan protobuf-java-2.4.1.jar keluar dari ' /lib'. Masuk ke direktori itu terlebih dahulu.
CD /lib
sudo mv protobuf-java-2.4.1.jar ~/

b. Temukan file JAR 'guava' seperti di bawah ini.
find . -name "guava*"

Pindahkan guava-10.0.1.jar keluar dari ' /lib'.
sudo mv guava-10.0.1.jar ~/

c. Unduh guava-17.0.jar dari Repositori Maven, ditunjukkan di bawah ini.

Sekarang, salin file JAR yang telah diunduh ini ke ' /lib'.
Langkah 4) Pergi ke ' /bin' dan jalankan Flume sebagai berikut.
./flume-ng agent -n MyTwitAgent -c conf -f <Flume Installation Directory>/conf/flume.conf

Tampilan jendela command prompt tempat Flume mengambil tweet terlihat seperti ini.

Dari pesan jendela perintah, kita dapat melihat bahwa output ditulis ke direktori /user/hduser/flume/tweets/. Sekarang, buka direktori ini menggunakan peramban web.
Langkah 5) Untuk melihat hasil pemuatan data, buka http://localhost:50070/ di browser, telusuri sistem file, lalu masuk ke direktori tempat data telah dimuat, yaitu
/flume/tweet/
Port 50070 adalah antarmuka pengguna web NameNode pada Hadoop 2; Hadoop 3 memindahkan halaman yang sama ke port 9870.

Flume adalah setengah dari proses penyerapan: Skup mengimpor tabel secara bertahap, Flume mengalirkan peristiwa, lalu Babi or Sarang lebah bentuk file dan Oozie menjadwalkan rantai tersebut. Lihat juga alat analisis data besar, Penggabungan dan penghitung MapReduce ke Talend.
