
Tutorial Jaringan Saraf Buatan (ANN) dengan TensorFlow
 Evelyn Clarke
⚡ Ringkasan Cerdas
Jaringan Neural Buatan belajar dengan memasukkan input melalui lapisan yang terhubung, memberi skor pada hasilnya dengan fungsi kerugian, dan mengoreksi bobot dengan pengoptimal. Panduan ini membangunnya di TensorFlow dan mengklasifikasikan angka MNIST.
Apa itu Jaringan Syaraf Tiruan?
An Jaringan Syaraf Tiruan (JST) Jaringan Saraf Buatan (Artificial Neural Network/ANN) adalah sistem komputer yang terinspirasi oleh jaringan saraf biologis untuk menciptakan otak buatan berdasarkan kumpulan unit yang terhubung yang disebut neuron buatan. Sistem ini dirancang untuk menganalisis dan memproses informasi seperti yang dilakukan manusia. ANN memiliki kemampuan belajar mandiri untuk menghasilkan hasil yang lebih baik seiring tersedianya lebih banyak data.
Diagram di bawah ini tracsatu kali proses penuh melalui jaringan tersebut, dari input mentah hingga pengoptimal yang mengoreksi bobot.

Jaringan Syaraf Tiruan (JST) terdiri dari empat objek utama:
- Lapisan: Semua pembelajaran terjadi di dalam lapisan. Ada 3 lapisan: 1) Input, 2) Hidden, dan 3) Output.
- Fitur dan label: Data masukan ke jaringan (fitur) dan keluaran dari jaringan (label)
- Fungsi kerugian: Metrik yang digunakan untuk memperkirakan kinerja fase pembelajaran.
- Pengoptimal: Tingkatkan pembelajaran dengan memperbarui pengetahuan di jaringan.
Jaringan saraf mengambil data masukan dan memasukkannya ke dalam kumpulan lapisan. Jaringan kemudian mengevaluasi kinerjanya dengan fungsi kerugian. Fungsi kerugian memberi jaringan gambaran tentang jalur yang perlu ditempuhnya sebelum menguasai pengetahuan tersebut. Jaringan meningkatkan pengetahuan itu dengan bantuan pengoptimal.
Jika Anda melihat gambar di atas, Anda akan memahami mekanisme yang mendasarinya.
Program ini mengambil beberapa nilai input dan memasukkannya ke dalam dua lapisan yang terhubung sepenuhnya. Bayangkan Anda memiliki soal matematika. Hal pertama yang Anda lakukan adalah membaca bab yang sesuai untuk menyelesaikannya. Kemudian Anda menerapkan pengetahuan baru Anda pada soal tersebut. Ada kemungkinan besar Anda tidak akan mendapatkan nilai yang bagus. Hal yang sama berlaku untuk jaringan: pertama kali jaringan melihat data dan membuat prediksi, hasilnya tidak akan sepenuhnya sesuai dengan data sebenarnya.
Untuk meningkatkan pengetahuannya, jaringan tersebut menggunakan pengoptimal. Dalam analogi ini, pengoptimal dapat diibaratkan seperti membaca ulang bab tersebut. Anda memperoleh wawasan baru dengan membaca lagi. Demikian pula, jaringan menggunakan pengoptimal, memperbarui pengetahuannya, dan menguji pengetahuan baru tersebut untuk memeriksa seberapa banyak yang masih perlu dipelajari. Program mengulangi langkah ini hingga menghasilkan kesalahan serendah mungkin.
Dalam analogi soal matematika, artinya Anda membaca bab buku teks berkali-kali hingga benar-benar memahami isi materi. Bahkan setelah membaca berkali-kali, jika Anda terus membuat kesalahan, itu berarti Anda telah mencapai kapasitas pengetahuan materi saat ini. Anda perlu menggunakan buku teks yang berbeda atau mencoba metode yang berbeda untuk meningkatkan nilai Anda. Untuk jaringan saraf, prosesnya sama. Jika kesalahan berhenti berkurang dan kurva kerugian menjadi datar, arsitektur saat ini tidak dapat mempelajari hal lain. Jaringan harus dioptimalkan lebih baik untuk meningkatkan pengetahuan.
Keempat objek tersebut dipetakan secara langsung ke komponen yang Anda konfigurasikan saat mendesain jaringan.
Jaringan syaraf Architekstur
Arsitektur Jaringan Saraf Buatan terdiri dari komponen-komponen berikut:
- Lapisan
- Fungsi aktivasi
- Fungsi kerugian
- Pengoptimal
Lapisan
Sebuah layer adalah tempat semua pembelajaran berlangsung. Di dalam sebuah layer terdapat sejumlah neuron, masing-masing memegang bobotnya sendiri. Jaringan saraf tipikal sering diproses oleh layer yang terhubung secara padat (juga disebut layer yang terhubung sepenuhnya). Artinya, semua input terhubung ke output.
Jaringan saraf tiruan pada umumnya menerima vektor input dan skalar yang berisi label. Konfigurasi paling sederhana adalah klasifikasi biner dengan hanya dua kelas: 0 dan 1.
Jaringan menerima input, mengirimkannya ke semua node yang terhubung, dan menghitung sinyal dengan fungsi aktivasi. Diagram bernomor di bawah ini memperluas satu node sehingga Anda dapat melihat jumlah tertimbang dan langkah aktivasi secara terpisah.

Gambar di atas menggambarkan ide ini. Lapisan pertama menyimpan nilai input. Lapisan kedua, yang disebut lapisan tersembunyi, menerima input berbobot dari lapisan sebelumnya.
- Node pertama adalah nilai input.
- Neuron tersebut diuraikan menjadi bagian input dan fungsi aktivasi. Bagian kiri menerima semua input dari lapisan sebelumnya. Bagian kanan adalah jumlah dari input yang diteruskan ke fungsi aktivasi.
- Nilai keluaran yang dihitung dari lapisan tersembunyi digunakan untuk membuat prediksi. Untuk klasifikasi, nilainya sama dengan jumlah kelas. Untuk regresi, hanya satu nilai yang diprediksi.
Fungsi aktivasi
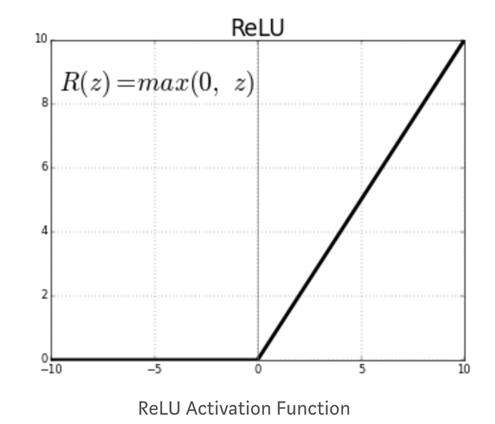
Fungsi aktivasi suatu node menentukan output yang diberikan berdasarkan sekumpulan input. Anda memerlukan fungsi aktivasi agar jaringan dapat mempelajari pola non-linear. Fungsi aktivasi yang umum digunakan adalah ReLU, yaitu Rectified Linear Unit. Fungsi ini memberikan nilai nol untuk semua nilai negatif.
Fungsi aktivasi lainnya adalah:
- Linier Sepotong-sepotong
- sigmoid
- Tanho
- ReLU bocor
Grafik di bawah ini menunjukkan mengapa ReLU digambarkan seperti itu: kurva datar pada angka nol untuk setiap input negatif dan naik secara linear setelahnya.
Keputusan penting yang harus diambil saat membangun jaringan saraf adalah:
- Berapa banyak lapisan dalam jaringan saraf
- Berapa banyak unit tersembunyi untuk setiap lapisan
Jaringan saraf dengan banyak lapisan dan unit tersembunyi dapat mempelajari representasi data yang kompleks, tetapi hal itu membuat komputasi jaringan menjadi sangat mahal.
Fungsi kerugian
Setelah Anda menentukan lapisan tersembunyi dan fungsi aktivasi, Anda perlu menentukan fungsi kerugian dan pengoptimal.
Untuk klasifikasi biner, praktik umum yang digunakan adalah fungsi kerugian binary cross entropy. Dalam regresi linierAnda menggunakan kesalahan kuadrat rata-rata.
Fungsi kerugian merupakan metrik penting untuk memperkirakan kinerja pengoptimal. Selama pelatihan, metrik ini akan diminimalkan. Anda harus memilih jumlah ini dengan hati-hati tergantung pada jenis masalah yang Anda hadapi.
Pengoptimal
Fungsi kerugian (loss function) adalah ukuran kinerja model. Optimizer akan membantu meningkatkan bobot jaringan untuk mengurangi kerugian. Tersedia berbagai optimizer, tetapi yang paling umum adalah Stochastic Gradient Descent.
Pengoptimal konvensional adalah:
- Momentum optimasi
- Gradien yang Dipercepat Nesterov
- AdaGrad
- Optimasi Adam
ArchiStruktur saja tidak menjamin model yang dapat digunakan.
Keterbatasan Jaringan Neural
Berikut adalah keterbatasan jaringan saraf tiruan:
overfitting
Masalah umum pada jaringan saraf kompleks adalah kesulitan dalam melakukan generalisasi pada data yang belum pernah dilihat sebelumnya. Jaringan saraf dengan banyak bobot dapat mengidentifikasi detail spesifik dalam set data pelatihan dengan sangat baik, tetapi hal itu sering menyebabkan overfitting. Jika data tidak seimbang dalam kelompok (yaitu, tidak cukup data tersedia di beberapa kelompok), jaringan akan belajar dengan sangat baik selama pelatihan tetapi tidak akan memiliki kemampuan untuk menggeneralisasi pola tersebut ke data yang belum pernah dilihat sebelumnya.
Ada pertukaran dalam Mesin belajar antara optimasi dan generalisasi.
- Mengoptimalkan model memerlukan pencarian parameter terbaik yang meminimalkan kerugian pada set data pelatihan.
- Generalisasi, bagaimanapun, menunjukkan bagaimana model berperilaku terhadap data yang tidak terlihat.
Untuk mencegah model menangkap detail spesifik atau pola yang tidak diinginkan dari data pelatihan, Anda dapat menggunakan berbagai teknik. Metode terbaik adalah memiliki dataset yang seimbang dengan jumlah data yang cukup. Seni mengurangi overfitting disebut regularisasi. Tiga teknik di bawah ini adalah titik awal konvensional.
| Teknik | Apa yang dibatasinya | Pengaturan umum dalam tutorial ini |
|---|---|---|
| Ukuran jaringan | Jumlah lapisan dan unit tersembunyi | Dua lapisan tersembunyi, 300 dan 100 unit. |
| Regularisasi bobot L1 / L2 | Besarnya koefisien bobot | l1_regularization_strength dan l2_regularization_strength sebesar 0.01 |
| Keluar | Proporsi unit yang dimatikan per langkah pelatihan | tingkat putus sekolah sebesar 0.3 |
Ukuran jaringan
Jaringan saraf dengan terlalu banyak lapisan dan unit tersembunyi dikenal sangat rumit. Cara mudah untuk mengurangi kompleksitas model adalah dengan mengurangi ukurannya. Tidak ada satu praktik terbaik pun untuk menentukan jumlah lapisan. Anda perlu memulai dengan jumlah lapisan yang kecil dan meningkatkan ukurannya hingga Anda menemukan model mengalami overfitting.
Regularisasi Berat Badan
Teknik standar untuk mencegah overfitting adalah dengan menambahkan batasan pada bobot jaringan. Batasan tersebut memaksa bobot jaringan untuk hanya mengambil nilai-nilai kecil. Batasan tersebut ditambahkan ke fungsi kerugian (loss function) dari kesalahan. Ada dua jenis regularisasi:
- L1 (Lasso): Biaya berbanding lurus dengan nilai absolut dari koefisien bobot.
- L2 (Punggung Bukit): Biaya berbanding lurus dengan kuadrat nilai koefisien bobot.
Keluar
Dropout adalah teknik yang aneh namun berguna. Jaringan dengan dropout berarti beberapa unit akan dimatikan secara acak selama langkah pelatihan, sehingga sinyal keluarannya menjadi nol. Bayangkan Anda memiliki array bobot [0.1, 1.7, 0.7, -0.9]. Jika jaringan saraf memiliki dropout, maka akan menjadi [0.1, 0, 0, -0.9] dengan nilai 0 yang terdistribusi secara acak. Parameter yang mengontrol dropout adalah tingkat dropout. Tingkat ini menentukan berapa banyak unit yang dimatikan. Tingkat antara 0.2 dan 0.5 adalah hal yang umum.
Contoh interaktif sederhana memudahkan pengamatan siklus pelatihan.
Contoh Jaringan Neural di TensorFlow
Berikut adalah contoh Jaringan Saraf Buatan (Artificial Neural Network/ANN) yang sedang beraksi, menunjukkan bagaimana jaringan saraf bekerja pada masalah klasifikasi tipikal. Terdapat dua input, x1 dan x2, masing-masing dengan nilai acak. Outputnya adalah kelas biner. Tujuannya adalah untuk mengklasifikasikan label berdasarkan dua fitur tersebut. Untuk melaksanakan tugas ini, arsitektur jaringan saraf didefinisikan sebagai berikut:
- Dua lapisan tersembunyi
- Lapisan pertama memiliki empat neuron yang terhubung sepenuhnya
- Lapisan kedua memiliki dua neuron yang terhubung sepenuhnya
- Fungsi aktivasi yang digunakan adalah ReLU.
- Tambahkan Regularisasi L2 dengan kecepatan pembelajaran 0.003
Jaringan akan mengoptimalkan bobot selama 180 epoch dengan ukuran batch 10. Dalam animasi contoh ANN di bawah ini, Anda dapat melihat bagaimana bobot berkembang seiring waktu dan bagaimana jaringan meningkatkan peta klasifikasi.ping.

Pertama-tama, jaringan memberikan nilai acak untuk semua bobot.
- Dengan bobot acak, yaitu tanpa optimasi, output loss adalah 0.453. Gambar di bawah ini merepresentasikan jaringan dengan warna yang berbeda.
- Secara umum warna oranye mewakili nilai negatif sedangkan warna biru menunjukkan nilai positif.
- Titik-titik data memiliki representasi yang sama: yang berwarna biru adalah label positif dan yang berwarna oranye adalah label negatif.

Di dalam lapisan tersembunyi kedua, garis-garis diwarnai sesuai dengan tanda bobotnya. Garis oranye memiliki bobot negatif dan garis biru memiliki bobot positif.
Seperti yang Anda lihat, pada peta outputpingJaringan tersebut membuat cukup banyak kesalahan. Sekarang, perhatikan bagaimana perilaku jaringan setelah optimasi.
Gambar contoh ANN di bawah ini menggambarkan hasil dari jaringan yang dioptimalkan. Pertama-tama, Anda perhatikan bahwa jaringan telah berhasil mempelajari cara mengklasifikasikan titik data. Membandingkannya dengan gambar sebelumnya, bobot awal adalah -0.43 sedangkan setelah optimasi menghasilkan bobot -0.95.

Ide ini dapat digeneralisasikan untuk jaringan dengan lebih banyak lapisan tersembunyi dan neuron. Anda dapat bereksperimen dengan pengaturan tersebut sendiri di Taman Bermain TensorFlow.
Penjelasan langkah demi langkah di bawah ini membangun ide yang sama dalam kode dengan menggunakan kumpulan data nyata.
Cara Melatih Jaringan Neural dengan TensorFlow
Berikut adalah proses langkah demi langkah tentang cara melatih jaringan saraf dengan TensorFlow ANN menggunakan estimator DNNClassifier dari API.
Kami akan menggunakan kumpulan data MNIST untuk melatih jaringan saraf pertama Anda. Melatih jaringan saraf dengan TensorFlow Ini tidak terlalu rumit. Langkah pra-pemrosesan persis sama seperti pada tutorial sebelumnya. Anda akan melanjutkan sebagai berikut:
- Impor data
- Ubah datanya
- Susun tensornya
- Bangun model
- Melatih dan mengevaluasi model
- Tingkatkan modelnya
Catatan versi: Kode dalam panduan ini menargetkan API Estimator TensorFlow 1.x. Rilis final paket tf-estimator disertakan dengan TensorFlow 2.15, dan tf.estimator dihapus di TensorFlow 2.16. Untuk menjalankan langkah-langkah ini pada rilis terbaru, Anda dapat menggunakan TensorFlow 2.15 atau membangun kembali jaringan dua lapis yang sama dengan tf.keras.layers.Dense dan model.fit().
Langkah 1) Impor data
Pertama-tama, Anda perlu mengimpor pustaka yang diperlukan. Anda dapat mengimpor dataset MNIST menggunakan scikit-belajar seperti yang ditunjukkan pada contoh Jaringan Saraf TensorFlow di bawah ini.
Dataset MNIST adalah dataset yang paling umum digunakan untuk menguji teknik atau algoritma baru. Ini adalah kumpulan gambar berukuran 28×28 piksel, masing-masing menampilkan angka tulisan tangan dari 0 hingga 9. Sebuah komite jaringan konvolusional dalam yang dilatih dengan distorsi elastis menurunkan kesalahan pengujian hingga 0.27 persen.
import numpy as np
import tensorflow as tf
np.random.seed(1337)
Panduan awal mengunduh file MNIST secara manual dan mengarahkan fetch_mldata ke folder tersebut.
from sklearn.datasets import fetch_mldata
mnist = fetch_mldata(' /Users/Thomas/Dropbox/Learning/Upwork/tuto_TF/data/mldata/MNIST original')
print(mnist.data.shape)
print(mnist.target.shape)
Catatan API: mldata.org sudah tidak lagi online dan fetch_mldata telah dihapus di scikit-learn 0.22. Pada instalasi terbaru, ganti panggilan di atas dengan fetch_openml('mnist_784', version=1), yang mengunduh 70,000 digit yang sama dan menampilkan data serta atribut target yang identik.
Setelah itu, Anda membagi data dan mendapatkan bentuk dari kedua dataset tersebut.
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(mnist.data, mnist.target, test_size=0.2, random_state=42)
y_train  = y_train.astype(int)
y_test  = y_test.astype(int)
batch_size =len(X_train)

print(X_train.shape, y_train.shape,y_test.shape )
Langkah 2) Transformasikan data
Pada tutorial sebelumnya, Anda telah mempelajari bahwa Anda perlu mentransformasi data untuk membatasi pengaruh outlier. Dalam tutorial Jaringan Saraf ini, Anda akan mentransformasi data menggunakan min-max scaler. Rumusnya adalah:
(X-min_x)/(max_x - min_x)
scikit-learn sudah memiliki fungsi untuk itu: MinMaxScaler().
## resclae
from sklearn.preprocessing import MinMaxScaler
scaler = MinMaxScaler()
# Train
X_train_scaled = scaler.fit_transform(X_train.astype(np.float64))
# test
X_test_scaled = scaler.fit_transform(X_test.astype(np.float64))
Langkah 3) Buat tensor
Anda sekarang sudah memahami cara membuatnya. tensor Di TensorFlow, Anda dapat mengkonversi data pelatihan menjadi kolom numerik.
feature_columns = [tf.feature_column.numeric_column('x', shape=X_train_scaled.shape[1:])]
Langkah 4) Bangun modelnya
Arsitektur jaringan saraf ini berisi 2 lapisan tersembunyi dengan 300 unit untuk lapisan pertama dan 100 unit untuk lapisan kedua. Nilai-nilai ini berasal dari pengalaman, bukan dari rumus. Anda dapat menyesuaikannya dan melihat bagaimana pengaruhnya terhadap akurasi jaringan.
Untuk membangun model, Anda menggunakan estimator DNNClassifier. Anda perlu mengatur jumlah kelas menjadi 10 karena ada sepuluh kelas dalam set pelatihan. Anda sudah familiar dengan sintaks objek estimator. Argumen feature_columns, n_classes, dan model_dir persis sama seperti pada tutorial sebelumnya. Argumen hidden_units adalah yang baru: argumen ini mengontrol jumlah layer dan berapa banyak node yang dihubungkan setiap layer ke jaringan saraf. Dalam kode di bawah ini, terdapat dua layer tersembunyi, yang pertama menghubungkan 300 node dan yang kedua 100 node.
Untuk membangun estimator, gunakan tf.estimator.DNNClassifier dengan parameter berikut:
- kolom_fitur: Tentukan kolom yang akan digunakan dalam jaringan.
- unit_tersembunyi: Tentukan jumlah neuron tersembunyi.
- n_kelas: Tentukan jumlah kelas yang akan diprediksi.
- direktori_model: Tentukan jalur dari Papan Tensor
estimator = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    n_classes=10,
    model_dir = '/train/DNN')
Langkah 5) Latih dan evaluasi model
Anda dapat menggunakan fungsi input NumPy untuk melatih model dan mengevaluasinya.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_train_scaled},
    y=y_train,
    batch_size=50,
    shuffle=False,
    num_epochs=None)
estimator.train(input_fn = train_input,steps=1000)
eval_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_test_scaled},
    y=y_test,
    shuffle=False,
    batch_size=X_test_scaled.shape[0],
    num_epochs=1)
estimator.evaluate(eval_input,steps=None)
Keluaran:
{'accuracy': 0.9637143,
 'average_loss': 0.12014342,
 'loss': 1682.0079,
 'global_step': 1000}
Arsitektur saat ini menghasilkan akurasi pada set evaluasi sekitar 96 persen.
Langkah 6) Tingkatkan modelnya
Anda dapat mencoba menyempurnakan model dengan menambahkan parameter regularisasi.
Di sini, estimator menggunakan optimizer Proximal AdaGrad dengan tingkat dropout 0.3 dan kekuatan L1 dan L2 masing-masing diatur ke 0.01. Dalam jaringan saraf TensorFlow, Anda mengakses optimizer melalui objek train diikuti dengan nama optimizer. TensorFlow menyediakan API bawaan untuk optimizer Proximal AdaGrad.
Untuk menambahkan regularisasi pada jaringan saraf dalam (deep neural network), Anda dapat menggunakan tf.train.ProximalAdagradOptimizer dengan parameter berikut:
- Tingkat pembelajaran: tingkat_belajar
- Regularisasi L1: kekuatan regularisasi l1
- Regularisasi L2: kekuatan regularisasi l2
estimator_imp = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    dropout=0.3,
    n_classes = 10,
    optimizer=tf.train.ProximalAdagradOptimizer(
      learning_rate=0.01,
      l1_regularization_strength=0.01,
      l2_regularization_strength=0.01
    ),
    model_dir = '/train/DNN1')
estimator_imp.train(input_fn = train_input,steps=1000)
estimator_imp.evaluate(eval_input,steps=None)
Keluaran:
{'accuracy': 0.95057142,
 'average_loss': 0.17318928,
 'loss': 2424.6499,
 'global_step': 2000}
Nilai yang dipilih untuk mengurangi overfitting tidak meningkatkan akurasi model. Model pertama Anda memiliki akurasi 96% sedangkan model dengan regularisasi L2 memiliki akurasi 95%. Anda dapat mencoba nilai yang berbeda dan melihat bagaimana pengaruhnya terhadap akurasi.
