
Felügyelt gépi tanulás: Algorithms, Típusok és példák
 Evelyn Clarke
⚡ Okos összefoglaló
A felügyelt gépi tanulás címkézett példákon tanít be egy algoritmust, hogy az olyan adatok kimenetelét is megjósolhassa, amelyeket korábban még nem látott. Ehhez numerikus célpontok esetén regressziót, kategóriák szerinti célpontok (például spam vagy csalás) esetén pedig osztályozást használ.
Mi az a felügyelt gépi tanulás?
A felügyelt gépi tanulás egy olyan algoritmus, amely címkézett betanítási adatokból tanul, hogy segítsen előre jelezni a váratlan adatok kimenetelét. A felügyelt tanulás során a gépet jól „címkézett” adatokkal tanítjuk. Ez azt jelenti, hogy egyes adatok már meg vannak címkézve a helyes válaszokkal. Összehasonlítható azzal, mint egy felügyelő vagy egy tanár jelenlétében tanulni.
A pontos, felügyelt gépi tanulási modellek sikeres felépítése, skálázása és telepítése időt és magasan képzett adattudósokból álló csapat technikai szakértelmét igényli. Az adattudósoknak a modelleket is rendszeresen újra kell építeniük, hogy az általuk létrehozott információk a mögöttes adatok változásával is igazak maradjanak.
Hogyan működik a felügyelt tanulás
A felügyelt gépi tanulás tanítási adatkészleteket használ a kívánt eredmények elérése érdekében. Ezek az adatkészletek olyan bemeneteket és helyes kimenetet tartalmaznak, amelyek elősegítik a modell gyorsabb tanulását. Például egy gépet szeretne betanítani, hogy segítsen megjósolni, mennyi ideig tart hazafelé a munkahelyéről.
Itt először egy címkézett adatkészletet hoz létre. Ezek az adatok a következőket tartalmazzák:
- Időjárási viszonyok
- A nap ideje
- Ünnepek
- Útvonal kiválasztva
Mindezek a részletek a bemeneti adatok ebben a felügyelt tanulási példában. A kimenet az az időtartam, ameddig a tanuló az adott napon hazafelé autózott, ahogy az alábbi kép is mutatja.
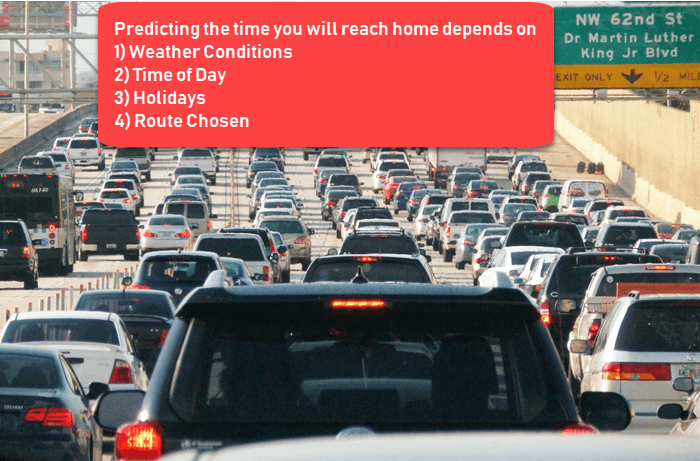
Ösztönösen tudod, hogy ha kint esik az eső, akkor tovább tart hazavezetni. De a gépnek adatokra és statisztikákra van szüksége.
Az első dolog, amit létre kell hoznod, egy tanulóhalmaz. Ez tartalmazza a teljes ingázási időt és a kapcsolódó tényezőket, mint például az időjárás, az idő stb. Ezen tanulóhalmaz alapján a géped láthatja, hogy közvetlen összefüggés van az eső mennyisége és a hazajutáshoz szükséges idő között.
Tehát megállapítja, hogy minél többet esik az eső, annál tovább kell autózni, hogy hazaérj. Azt is láthatja, hogy mennyi idő alatt indulsz el a munkából, és mennyi ideig leszel úton. Minél közelebb vagy este 6 órához, annál tovább tart, mire hazaérsz.
A géped megtalálhatja a címkézett adatokkal való kapcsolatok egy részét. Ez a tanulási fázis az alábbiakban látható.
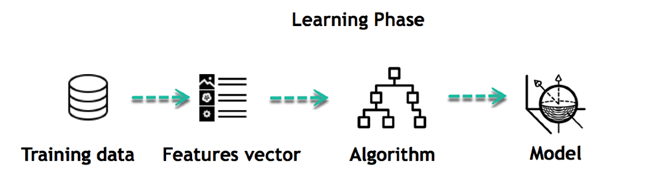
Ez az adatmodelled kezdete. Elkezdi rögzíteni, hogy az eső hogyan befolyásolja az emberek vezetési szokásait, és hogy egy adott napszakban több ember közlekedik.
A felügyelt gépi tanulás típusai Algorithms
A felügyelt gépi tanulási algoritmusok típusai a következők:
Regresszió
A regressziós technika egyetlen folytonos kimeneti értéket jósol meg a betanítási adatok felhasználásával.
Példa: A regresszió segítségével megjósolhatja a ház árát a képzési adatokból. A bemeneti változók a helység, a ház mérete stb.
Erősségek: A kimenetek könnyen értelmezhetők, és az algoritmus regularizálható a túlillesztés elkerülése érdekében.
Gyengeségek: A lineáris modell nem rugalmas, így nem ragadja meg a komplex kapcsolatokat hozzáadott jellemzők nélkül.
Íme néhány regressziótípus Algorithms:
- Lineáris regresszió
- Polinomiális regresszió
- Ridge és Lasso regresszió
- Logisztikus regresszió (osztályozáshoz)
- Döntési fa és véletlenszerű erdőregresszió
- Támogató vektor regresszió
Logisztikus regresszió:
A logisztikus regresszió diszkrét értékek becslésére szolgál adott független változók halmaza alapján. Segít megjósolni egy esemény bekövetkezésének valószínűségét azáltal, hogy az adatokat logit függvényhez illeszti. Ezért logit regressziónak is nevezik. Mivel valószínűséget jósol, a kimeneti értéke 0 és 1 között van, és alulteljesíthet, ha több vagy nemlineáris döntési határ van.
Osztályozás
Az osztályozás a kimenet egy osztályon belüli csoportosítását jelenti. Ha az algoritmus a bemenetet két különálló osztályba próbálja sorolni, azt bináris osztályozásnak nevezzük. Kettőnél több osztály közötti választást többosztályos osztályozásnak nevezünk.
Példa: Annak meghatározása, hogy valaki nem fizeti-e vissza a kölcsönt.
Erősségek: Az osztályozási fák a gyakorlatban nagyon jól teljesítenek.
Gyengeségek: A korlátozás nélküli, az egyes fák hajlamosak a túlzott illeszkedésre.
Íme néhány osztályozási típus Algorithms:
- Naiv Bayes osztályozók
- Döntési fák
- Támogatja a vektoros gépet
- K-Legközelebbi szomszédok
- Véletlenszerű erdő és színátmenet-erősítés
Naiv Bayes osztályozók
Az Naiv Bayes A modell könnyen felépíthető és nagyon hasznos nagy adathalmazok esetén. Ez a módszer irányított, aciklikus gráfokból áll, amelyek egy szülővel és több gyermekkel rendelkeznek. Feltételezi a szülőjüktől elkülönített gyermekcsomópontok közötti függetlenséget.
Döntési fák
A döntési fák egy példányt a jellemzőérték alapján rendezve osztályoznak. Ebben a módszerben minden csomópont egy példány osztályozandó jellemzője, és minden ág egy olyan értéket képvisel, amelyet a csomópont felvehet. Ez egy széles körben használt osztályozási technika.
Ugyanez a struktúra működik a regresszió esetében is: egy regressziós fa segít megbecsülni a valós értékeket (autóvásárlás költsége, hívások száma, teljes havi eladás stb.).
Támogatja a vektoros gépet
A Support Vector Machine (SVM) egy tanulási algoritmustípus, amelyet az 1990-es években vezettek be. Ez a módszer Vladimir Vapnik és kollégái által kidolgozott statisztikai tanuláselmélet eredményein alapul.
Az SVM-ek szorosan kapcsolódnak a kernelfüggvényekhez is, amelyek a legtöbb tanulási feladat központi fogalmát képezik. A kernel keretrendszert és az SVM-et számos területen használják. Ide tartozik a multimédiás információkeresés, a bioinformatika és a mintázatfelismerés. A fenti becslők mindegyike dokumentálva van a hangolási paramétereivel együtt a scikit elsajátítható referencia.
Felügyelt és felügyelet nélküli gépi tanulási technikák
A módszer mellé helyezése felügyelet nélküli tanulás egyértelművé teszi a határait.
| Alapján | Felügyelt gépi tanulási technika | Felügyelet nélküli gépi tanulási technika |
|---|---|---|
| Beviteli adat | Algorithms címkézett adatok felhasználásával képezik ki. | Algorithms nem címkézett adatok ellen használják |
| Számítási komplexitás | A felügyelt tanulás egyszerűbb módszer. | A felügyelet nélküli tanulás számítási szempontból bonyolult |
| Pontosság | Rendkívül pontos és megbízható módszer. | Less pontos és megbízható módszer. |
| Tipikus algoritmusok | Logisztikus regresszió, döntési fák, SVM, Naiv Bayes-módszer | K-középértékek, hierarchikus klaszterezés, PCA |
| Az eredmények megítélése | Ismert válaszokkal szemben pontozva (pontosság, RMSE) | Belső mérések és emberi felülvizsgálat alapján ítélve |
Kihívások a felügyelt gépi tanulásban
Íme a felügyelt gépi tanulás során felmerülő kihívások:
- A betanítási adatokban található irreleváns bemeneti jellemzők pontatlan eredményeket eredményezhetnek.
- Az adatok előkészítése és előfeldolgozása mindig kihívást jelent.
- A pontosság romlik, ha lehetetlen, valószínűtlen és hiányos értékeket adtunk meg betanítási adatként.
- Ha az érintett szakértő nem elérhető, akkor a másik megközelítés a „nyers erő”. Ez azt jelenti, hogy meg kell találgatni, hogy mely jellemzőkre (bemeneti változókra) kell betanítani a gépet, és ez a találgatás pontatlan lehet.
A felügyelt tanulás előnyei
Ezen kihívásokkal szemben a felügyelt gépi tanulás előnyei a következők:
- Felügyelt tanulás be Gépi tanulás lehetővé teszi adatok gyűjtését vagy adatkimenet előállítását korábbi tapasztalatok alapján
- Segít optimalizálni a teljesítménykritériumokat a tapasztalatok felhasználásával
- A felügyelt gépi tanulás segít különféle típusú valós számítási problémák megoldásában.
A felügyelt tanulás hátrányai
Az alábbiakban a felügyelt gépi tanulás hátrányait ismertetjük:
- A döntési határ túlképzett lehet, ha a tanulóhalmaz nem tartalmaz olyan példákat, amelyeket egy osztályban látni szeretne.
- Az osztályozó képzése során minden osztályból sok jó példát kell kiválasztania.
- A big data osztályozása igazi kihívást jelenthet.
- A felügyelt tanuláshoz szükséges képzés sok számítási időt igényel.
A felügyelt tanulás legjobb gyakorlatai
A következő sorozat bekapcsolva tartja a projektet track:
- Mielőtt bármi mást tennél, döntsd el, hogy milyen típusú adatokat fogsz használni betanító halmazként.
- Határozza meg a tanult függvény és a tanulási algoritmus szerkezetét.
- Gyűjtsd össze a megfelelő eredményeket akár emberi szakértőktől, akár mérésekből
- Tarts vissza egy olyan teszthalmazt, amelyet a modell soha nem lát, és jelentsd rajta az eredményt.
