
Szórásdiagram R-ben ggplot2 használatával példával
 Szerkesztőség
⚡ Okos összefoglaló
Az R szóródási diagramja a ggplot2 használatával két folytonos változót képez le az x és y tengelyekre a geom_point() segítségével. Ez a bemutató a csoportosítást tárgyalja.ping szín, logaritmikus transzformációk, illesztett regressziós egyenesek, címkék, fazettálás, túlrajzolási javítások, skálák, témák és mentés szerint.
Miért fontosak a grafikonok az adatelemzésben?
A grafikonok az adatelemzési folyamat harmadik részét képezik. Az első rész kb adatok extracCIÓ, a második rész foglalkozik az adatok tisztítása és kezelése. Végre az adattudósnak szüksége lehet rá eredményeit grafikusan közölje.
Az adattudós munkafolyamatát az alábbi kép foglalja össze.
- Az adattudós első feladata egy kutatási kérdés meghatározása. Ez a kutatási kérdés a projekt célkitűzéseitől és céljaitól függ.
- Ezt követően az egyik legkiemelkedőbb feladat a funkciótervezés. Az adattudósnak össze kell gyűjtenie, kezelnie és meg kell tisztítania az adatokat
- Ha ez a lépés befejeződött, megkezdheti az adatkészlet feltárását. Néha egy új felfedezés miatt szükséges az eredeti hipotézis finomítása és megváltoztatása.

- Amikor a magyarázó Az elemzés elérése érdekében az adattudósnak figyelembe kell vennie az olvasó képességét megérteni a mögöttes fogalmakat és modelleket.
- Eredményeit minden érdekelt fél számára érthető formában kell bemutatni. Az egyik legjobb módszer arra, kommunikálni az eredményeket a grafikon.
- A grafikonok hihetetlen eszközök az összetett elemzés egyszerűsítésére.
A bemutató további részében ezeket a grafikonokat a ggplot2 csomaggal építjük fel.
A ggplot2 csomag
Ez az oktatóanyag a diagramok készítésére összpontosít R-ben a ggplot2 segítségével.
Ebben az oktatóanyagban a ggplot2 csomagot fogod használni. A csomag a Leland Wilkinson által 2005-ben leírt grafikai nyelvtant valósítja meg. A ggplot2 rugalmas, számos témával rendelkezik, és lehetővé teszi egy magas szintű abszcisszán alapuló diagram megadását.tracció. Megjegyzendő, hogy nem hoz létre háromdimenziós vagy interaktív grafikát; ezekhez olyan csomagok szükségesek, mint a plotly vagy az rgl.
A ggplot2-ben egy gráf a következő argumentumokból áll:
- Az információk szétdarabolódása
- esztétikai térképping
- geometriai objektum
- statisztikai transzformációk
- Mérleg
- koordináta-rendszer
- helyzetbeállítások
- faceting
Az oktatóanyagból megtudhatja, hogyan szabályozhatja ezeket az érveket.
A ggplot2 alapvető szintaxisa a következő:
ggplot(data, mapping=aes()) +
geometric object

arguments:
data: Dataset used to plot the graph
mapping: Control the x and y-axis
geometric object: The type of plot you want to show. The most common object are:

- Point: `geom_point()`
- Bar: `geom_bar()`
- Line: `geom_line()`
- Histogram: `geom_histogram()`
Hogyan készítsünk szóródási diagramot R-ben
Nézzük meg, hogyan működik a ggplot az mtcars adatkészlettel. Kezdje az mpg változó és a drat változó szórásdiagramjának ábrázolásával.
Alapvető szórásdiagram
library(ggplot2)
ggplot(mtcars, aes(x = drat, y = mpg)) +
    geom_point()
Code Magyarázat
- Először átadja az mtcars adatkészletet a ggplotnak.
- Az aes() argumentumon belül hozzáadja az x tengelyt és az y tengelyt.
- A + jel azt jelenti, hogy azt szeretné, hogy R továbbra is olvassa a kódot. Feltörésével olvashatóbbá teszi a kódot.
- Használja a geom_point()-ot a geometriai objektumhoz.
output:

Szórványrajz csoportokkal
Néha érdekes lehet az értékeket adatcsoportok (azaz faktor szintű adatok) alapján megkülönböztetni.
ggplot(mtcars, aes(x = mpg, y = drat)) +
    geom_point(aes(color = factor(gear)))
Code Magyarázat
- A geom_point() függvényen belüli aes() függvény vezérli az egyes csoportok színét. A groping A változónak faktornak kell lennie, tehát a gear a factor() függvénybe van csomagolva.
- Összességében az aes(color = factor(gear)) kódja van, amely megváltoztatja a pontok színét.
output:

Tengelyméret módosítása logaritmikus transzformációval
Az adatok átskálázása az elemzői munka nagy részét képezi, mivel a nyers változók ritkán érkeznek meg tiszta harang alakban. A logaritmusok használata az egyik módja a szélsőséges értékek tömörítésének és a grafikon kiugró értékekre való érzékenységének csökkentésének.
ggplot(mtcars, aes(x = log(mpg), y = log(drat))) +
    geom_point(aes(color = factor(gear)))
Code Magyarázat
- Az x és y változókat a log() függvényben közvetlenül az aes() map-en belül transzformálod.ping.
Vegye figyelembe, hogy bármilyen más transzformáció is alkalmazható, például szabványosítás vagy normalizálás.
output:

Szórásdiagram illesztett értékekkel
Hozzáadhat egy újabb információs szintet a grafikonhoz. Az illesztett értékeket rávetítheti egy lineáris regresszió.
my_graph <- ggplot(mtcars, aes(x = log(mpg), y = log(drat))) +
    geom_point(aes(color = factor(gear))) +
    stat_smooth(method = "lm",
        col = "#C42126",
        se = FALSE,
        size = 1)
my_graph
Code Magyarázat
- my_graph: a diagram a my_graph objektumban tárolódik, így a későbbi lépésekben rétegeket adhatunk hozzá a teljes hívás megismétlése nélkül.
- A stat_smooth() argumentum vezérli a simítási metódust
- módszer = “lm”: Lineáris regresszió
- oszlop = „#C42126”: Code a vonal piros színéért
- se = FALSE: Ne jelenítse meg a standard hibát
- size = 1: a vonal vastagsága. A ggplot2 3.4.0-s és későbbi verzióiban ezt az argumentumot vonalgeometriák esetén vonalszélességnek nevezték át.
output:

Vegye figyelembe, hogy más simítási módszerek is rendelkezésre állnak
- glm
- gam
- lösz: az alapértelmezett érték kevesebb mint 1,000 megfigyelés esetén
- rlm: robusztus lineáris modell, a MASS csomagból
A diagram formázása előtt érdemes tudni, hogy mikor a szóródási diagram a megfelelő választás.
Szórásdiagram vs. vonaldiagram vs. Bubble Táblázat R-ben
Mindhárom két folytonos változót ábrázol egymással szemben, így a választás arra korlátozódik, hogy az olvasó mit vonjon le a tanulságokból.
| Kritériumai | Scatter Plot | Vonal Chart | Bubble Diagram |
|---|---|---|---|
| Műsorok | Két változó közötti korreláció | Egy változó változása egy rendezett tengely mentén | Korreláció plusz egy harmadik nagyságrend |
| X-tengely | Bármely folytonos változó | Általában idő vagy más rendezett skála | Bármely folytonos változó |
| Pont sorrend | Irreleváns | Kritikus, a pontok össze vannak kötve | Irreleváns |
| Harmadik változó | Szín vagy forma által | Külön vonalakon keresztül | Átmenő pontméret |
| ggplot2 hívás | geom_pont() | geom_vonal() | geom_point(aes(méret = z)) |
Gyakori hiba a szóródási pontok egyenessel való összekötése, ha az x tengelynek nincs természetes rendje: ez egy nem létező sorozatot sugall. A geom_line() függvényt rendezett tengelyekhez, például dátumokhoz tartsuk fenn. Egyetlen változó eloszlásához használjunk egy dobozdiagram helyette.
Adjon hozzá információkat a grafikonhoz
A grafikonok egyelőre nem tartalmaznak magyarázó szöveget. Az olvasónak a diagram adataiból is látnia kell a történetet, további dokumentáció megtekintése nélkül, ami azt jelenti, hogy a diagramnak jó címkékre van szüksége. A címkéket a labs() függvénnyel adhatjuk hozzá.
A labs() alapvető szintaxisa a következő:
labs(title = "Hello Guru99")
arguments:
- title: Main title displayed above the plot
- subtitle: Secondary line below the title
- caption: Note below the plot, usually the data source
- x: Rename the x-axis
- y: Rename the y-axis
- color / fill: Rename the legend

Example: labs(title = "Hello Guru99", subtitle = "My first plot")
Cím hozzáadása
Az egyik kötelező információ nyilvánvalóan a cím.
my_graph +
    labs(
        title = "Plot Mile per hours and drat, in log"
         )
Code Magyarázat
- my_graph: Ön a tárolt grafikont használja. Ez elkerüli az összes kód újraírását minden alkalommal, amikor új információt ad a grafikonhoz.
- A címet a labs() függvényen belül kell megadni.
output:

Adjon hozzá egy címet dinamikus névvel
A dinamikus cím segít pontosabb információkat adni a címben.
A paste() függvény segítségével statikus és dinamikus szöveget nyomtathat. A paste() alapvető szintaxisa a következő:
paste("This is a text", A)
arguments
- " ": Text inside the quotation marks are the static text
- A: Display the variable stored in A
- Note you can add as much static text and variable as you want. You need to separate them with a comma
Példa:
A <- 2010
paste("The first year is", A)
output:
## [1] "The first year is 2010"
B <- 2018
paste("The first year is", A, "and the last year is", B)
output:
## [1] "The first year is 2010 and the last year is 2018"
Hozzáadhat egy dinamikus nevet a grafikonunkhoz, mégpedig az mpg átlagát.
mean_mpg <- mean(mtcars$mpg)
my_graph + labs(
    title = paste("Plot Mile per hours and drat, in log. Average mpg is", mean_mpg)
)
Code Magyarázat
- Az mpg átlagát a mean_mpg változóban tárolt mean(mtcars$mpg) értékkel hozza létre
- Használja a paste()-t az mean_mpg-vel egy dinamikus cím létrehozásához, amely az mpg átlagos értékét adja vissza
output:

Felirat hozzáadása
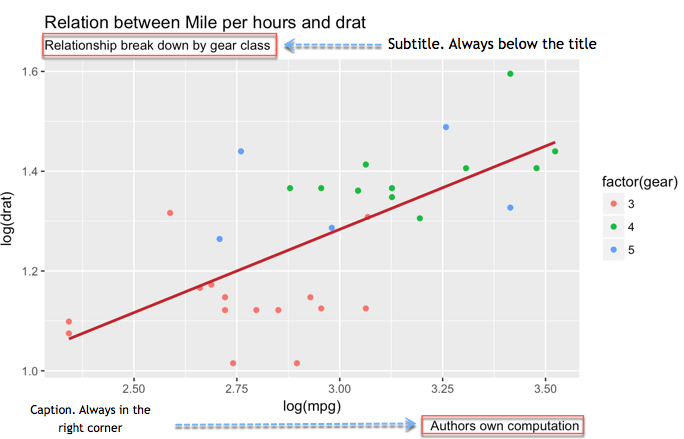
Két további részlet teszi a grafikont érthetőbbé. Az alcímről és a képaláírásról beszélünk. Az alcím közvetlenül a cím alatt található. A képaláírás tájékoztathatja a számítást végző személyt és az adatok forrását.
my_graph +
    labs(
        title =
        "Relation between Mile per hours and drat",
        subtitle =
        "Relationship break down by gear class",
        caption = "Authors own computation"
    )
Code Magyarázat
- A labs() függvényen belül hozzáadtad:
- title = „Az óránkénti mérföld és a drat közötti kapcsolat”: Cím hozzáadása
- subtitle = „Kapcsolat bontása felszerelési osztályok szerint”: Felirat hozzáadása
- caption = „A szerzők saját számításai: Felirat hozzáadása
- Minden új információt vesszővel választ el,
- Vegye figyelembe, hogy megtöri a kód sorait. Nem kötelező, és csak a kód könnyebb olvasását segíti elő
output:
Nevezze át az x-tengelyt és az y-tengelyt
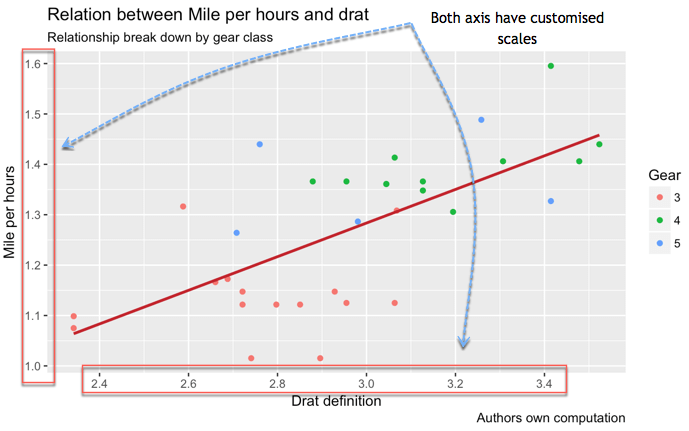
Az oszlopnevek ritkán jeleníthetők meg. Gyakran rövidítve vannak, vagy aláhúzásjelet használnak a szavak között, mint például a GDP_CAP esetében. Nevezd át őket a diagramon, és adj hozzá mértékegységeket, ahol fontosak.
my_graph +
    labs(
        x = "Drat definition",
        y = "Mile per hours",
        color = "Gear",
        title = "Relation between Mile per hours and drat",
        subtitle = "Relationship break down by gear class",
        caption = "Authors own computation"
    )
Code Magyarázat
- A labs() függvényen belül hozzáadtad:
- x = „Drat definition”: Az x tengely nevének módosítása
- y = „Mérföld óránként”: Módosítsa az y-tengely nevét
output:

Irányítsd a mérleget
Szabályozhatja a tengely léptékét.
A seq() függvény akkor hasznos, ha számsorozatot kell létrehoznia. Az alap szintaxis a következő:
seq(begin, last, by = x)
arguments:
- begin: First number of the sequence
- last: Last number of the sequence
- by= x: The step. For instance, if x is 2, the code adds 2 to `begin-1` until it reaches `last`
Például egy 0 és 12 közötti, 4-es lépésközzel megadott tartomány négy számot ad vissza: 0, 4, 8 és 12.
seq(0, 12,4)
output:
## [1] 0 4 8 12
Az alábbiak szerint szabályozhatja az x és y tengely léptékét
my_graph +
    scale_x_continuous(breaks = seq(1, 3.6, by = 0.2)) +
    scale_y_continuous(breaks = seq(1, 1.6, by = 0.1)) +
    labs(
        x = "Drat definition",
        y = "Mile per hours",
        color = "Gear",
        title = "Relation between Mile per hours and drat",
        subtitle = "Relationship break down by gear class",
        caption = "Authors own computation"
    )
Code Magyarázat
- A scale_y_continuous() függvény vezérli a Y-tengely
- A scale_x_continuous() függvény vezérli a x-tengely.
- A breaks paraméter szabályozza a tengely felosztását. Manuálisan hozzáadhatja a számsort, vagy használhatja a seq() függvényt:
- seq(1, 3.6, by = 0.2): Hozzon létre egy sorozatot 1-től 3.6-ig 0.2-es lépésekben, azaz 14 törésponttal.
- seq(1, 1.6, by = 0.1): Hozzon létre hét számot 1-től 1.6-ig 0.1-es lépésekben.
output:
téma
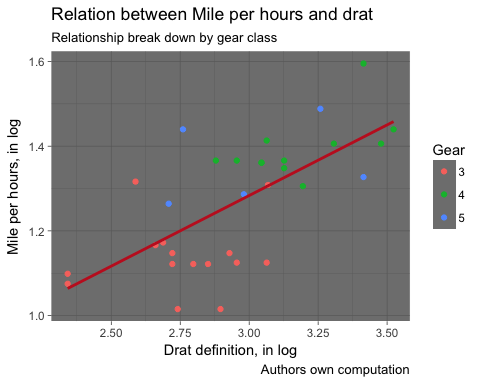
Végül, a ggplot2 lehetővé teszi a teljes diagram átformálását egyetlen témafüggvénnyel. A csomag nyolc teljes témát tartalmaz:
- theme_bw()
- theme_light()
- theme_classic()
- theme_linedraw()
- theme_dark()
- theme_minimal()
- theme_grey()
- theme_void()
my_graph +
    theme_dark() +
    labs(
        x = "Drat definition, in log",
        y = "Mile per hours, in log",
        color = "Gear",
        title = "Relation between Mile per hours and drat",
        subtitle = "Relationship break down by gear class",
        caption = "Authors own computation"
    )
output:

Mentse a telkeket
Mindezen lépések után itt az ideje menteni és megosztani a grafikont. A kirajzolás után azonnal hívd meg a ggsave(„file_name.png”) függvényt, és a kép lemezre kerül.
A grafikon a munkakönyvtárba kerül mentésre. A munkakönyvtár ellenőrzéséhez futtassa ezt a kódot:
directory <- getwd()
directory
Rajzold meg a kész grafikont, mentsd el, és nézd meg, hová került:
my_graph +
    theme_dark() +
    labs(
        x = "Drat definition, in log",
        y = "Mile per hours, in log",
        color = "Gear",
        title = "Relation between Mile per hours and drat",
        subtitle = "Relationship break down by gear class",
        caption = "Authors own computation"
    )
output:
ggsave("my_fantastic_plot.png")
output:
## Saving 5 x 4 in image
Megjegyzések: Kizárólag pedagógiai célból létrehoztunk egy open_folder() nevű függvényt, amely megnyitja Önnek a könyvtármappát. Csak le kell futtatnia az alábbi kódot, és meg kell néznie, hol van a kép tárolva. Látnia kell egy my_fantastic_plot.png nevű fájlt.
# Run this code to create the function
open_folder <- function(dir) {
    if (.Platform['OS.type'] == "windows") {
        shell.exec(dir)
    } else {
        system(paste(Sys.getenv("R_BROWSER"), dir))
    }
}

# Call the function to open the folder
open_folder(directory)
Hogyan készítsünk fazettált szóródási diagramokat R-ben a facet_wrap() függvénnyel?
A fazettálás a korábban felsorolt nyolc ggplot2 komponens egyike, és ez a legtisztább megoldás a zsúfolt diagramok problémájára. Ahelyett, hogy minden csoportot egyetlen panelbe sűrítene, a ggplot2 egy kis többszöröst rajzol egy változó minden szintjéhez, mindegyiket ugyanazon a skálán, így a panelek összehasonlíthatók maradnak.
# One panel per gear count
ggplot(mtcars, aes(x = drat, y = mpg)) +
    geom_point() +
    facet_wrap(~ gear) +
    theme_classic()
Három érv elvégzi a munka nagy részét.
- ncol or nrow: a panelek adott elrendezésbe kényszerítése, például facet_wrap(~ gear, ncol = 2).
- MérlegAlapértelmezés szerint „fixed”, így minden panel egy tengelytartományt oszt meg. Használjon „free_y” vagy „free” értéket, ha a csoportok nagyságrendjükben jelentősen eltérnek, de vegye figyelembe, hogy a szabad skálák félrevezetővé tehetik a panelek vizuális összehasonlítását.
- címkéző: minden csíkban lecseréli a nyers tényezőszintet, például a labeller = label_both esetén a „gear: 4” értéket írja ki a „4” helyett.
Két csoportping változókat. A facet_grid() függvénnyel panelmátrixot hozhatsz létre, ahol az első változó a sorokon, a második pedig az oszlopokon halad át:
ggplot(mtcars, aes(x = drat, y = mpg)) +
    geom_point(aes(color = factor(cyl))) +
    facet_grid(am ~ gear) +
    theme_classic()
Szeletek vagy színek? A színezés jól működik körülbelül négy csoportig egy diagramon, korlátozott átfedéssel. Ezen túlmenően, vagy amikor a csoportok erősen átfedik egymást, a fazettálás könnyebben olvasható, mivel minden panel csak a saját pontjait tartalmazza. Mindkettőt kombinálhatod: a fazettálást az egyik változóval és a színezést a másikkal, ahogy a fenti facet_grid() példában is látható.
Hogyan kezeljük a túlrajzolást R szóródási diagramokban
Néhány tucat megfigyeléssel minden pont látható. Ezreknél a markerek egymásra halmozódnak, és a legsűrűbb régió egyszerűen egy tömör foltnak tűnik. túltervezés, és a ggplot2 négy standard megoldást kínál.
1. Csökkentse az átlátszóságot. A legolcsóbb megoldás. Átfedésping a pontok természetesen besötétednek, így a sűrűség láthatóvá válik:
ggplot(diamonds, aes(x = carat, y = price)) +
    geom_point(alpha = 0.05) +
    theme_classic()
2. Diszkrét jitterértékek. Amikor egy változó csak néhány értéket vesz fel, a pontok ugyanazon koordinátákon helyezkednek el. Egy kis véletlenszerű elmozdulás választja el őket:
ggplot(mtcars, aes(x = factor(cyl), y = mpg)) +
    geom_jitter(width = 0.15, height = 0) +
    theme_classic()
Állítsa a magasságot 0-ra, így az y értékek, amelyek a valós információt hordozzák, soha nem változnak.
3. Dobd ki a repülőt a kukába. Nagy adathalmazok esetén cellánként számlálja a megfigyeléseket, és a számlálót színnel rendelje. A hatszögletű tárolók elkerülik a négyzetes tárolókhoz hasonló vizuális műtermékeket:
ggplot(diamonds, aes(x = carat, y = price)) +
    geom_hex(bins = 40) +
    theme_classic()
4. Rajzolj sűrűségi kontúrokat. A szintvonalak körvonalazzák azokat a régiókat, ahol a megfigyelések koncentrálódnak, és szépen rétegeződnek az elhalványult pontok felett:
ggplot(diamonds, aes(x = carat, y = price)) +
    geom_point(alpha = 0.05) +
    geom_density_2d(color = "#C42126") +
    theme_classic()
Ökölszabályként az alpha néhány ezer pontot kezel, a hexagonal binning tízezreket, és a dplyr::slice_sample() függvénnyel történő mintavételezés ezen túl a pragmatikusabb megoldás.
Szórásdiagram R-ben: Code Referencia
Az alábbi táblázat felsorolja a ggplot2 hívást a fent tárgyalt egyes opciókhoz:
| Objektív | Code |
|---|---|
| Alapvető szórásdiagram |
ggplot(df, aes(x = x1, y = y)) + geom_point() |
| Színcsoportos szóródási diagram |
ggplot(df, aes(x = x1, y = y)) + geom_point(aes(color = factor(x2))) |
| Illesztett értékek hozzáadása |
ggplot(df, aes(x = x1, y = y)) + geom_point() + stat_smooth(method = "lm") |
| Adj címet |
ggplot(df, aes(x = x1, y = y)) + geom_point() + labs(title = paste("Hello Guru99")) |
| Felirat hozzáadása |
ggplot(df, aes(x = x1, y = y)) + geom_point() + labs(subtitle = paste("Hello Guru99")) |
| Nevezze át x-et |
ggplot(df, aes(x = x1, y = y)) + geom_point() + labs(x = "X1") |
| Nevezze át y-t |
ggplot(df, aes(x = x1, y = y)) + geom_point() + labs(y = "y1") |
| Irányítsd a mérleget |
ggplot(df, aes(x = x1, y = y)) + geom_point() + scale_y_continuous(breaks = seq(10, 35, by = 10)) + scale_x_continuous(breaks = seq(2, 5, by = 1)) |
| Hozzon létre naplókat |
ggplot(df, aes(x = log(x1), y = log(y))) + geom_point() |
| téma |
ggplot(df, aes(x = x1, y = y)) + geom_point() + theme_classic() |
| Facet egy csoport által |
ggplot(df, aes(x = x1, y = y)) + geom_point() + facet_wrap(~ x2) |
| Átfedés kezelése |
ggplot(df, aes(x = x1, y = y)) + geom_point(alpha = 0.3) |
| Megtakarítás |
ggsave("my_fantastic_plot.png")
|
