
A hiányzó értékek (NA) pótlása az R-ben: na.omit & na.rm
 Evelyn Clarke
⚡ Okos összefoglaló
Az R-ben a hiányzó értékek cseréje című rész az NA értékek detektálását, a hiányos sorok eltávolítását a na.omit() függvénnyel, valamint az átlag vagy medián pótlását a mutate() függvénnyel tárgyalja. Ez a bemutató a Titanic adathalmazt használja, ahol a kor és a viteldíj is hiányzó megfigyeléseket tartalmaz.
Mik a hiányzó értékek az R-ben?
Hiányzó értékek akkor jelennek meg, ha egy megfigyelés oszlopában nincs rögzített érték, vagy ha egy nem numerikus helyőrző található a szám helyén. Ezeket el kell távolítani vagy ki kell cserélni bármilyen számítás előtt, mivel a legtöbb R függvény NA értéket ad vissza, amint jelen van.
Ez az oktatóanyag bemutatja, hogyan kezelheti a hiányzó értékeket a dplyr könyvtárral, amely a tidyverse adatelemzési ökoszisztéma része.
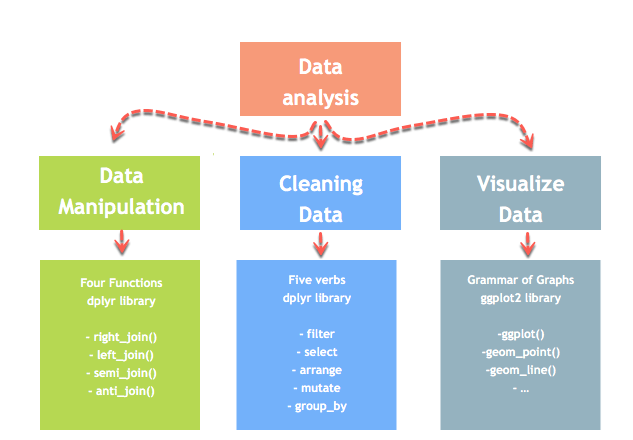
Az első lépés mindig annak kiderítése, hogy hány érték hiányzik és hol.
Hogyan észleljük és számoljuk a hiányzó értékeket R-ben?
Mielőtt eldöntenéd, mit tegyél a hiányzó értékekkel, tudnod kell, hogy hány van belőlük, és hol helyezkednek el. Az R négyféle ellenőrzést kínál, az egyetlen igen-nem választól kezdve a teljes oszloponkénti összesítésig.
# 1. Is there any NA at all?
anyNA(df_titanic)

# 2. How many in total?
sum(is.na(df_titanic))

# 3. How many per column, the most useful view
colSums(is.na(df_titanic))

# 4. Percentage missing per column
round(colMeans(is.na(df_titanic)) * 100, 1)
A gyakorlatban a colSums() függvényt érdemes használni. Egy névvel ellátott vektort ad vissza, oszloponként egy darabszámmal, amely azonnal megmutatja, hogy egy változóból hiányzik-e néhány érték, vagy többnyire üres.
Teljes sorok számlálása. A complete.cases() függvény TRUE értéket ad vissza azokra a sorokra, amelyekben sehol sem hiányzik érték, ami előre megmutatja, hogy az na.omit() függvény mennyi adatot dobna ki:
sum(complete.cases(df_titanic))       # rows that would survive
sum(!complete.cases(df_titanic))      # rows that would be dropped
Figyelmeztetés a helykitöltőkkel kapcsolatban. Az R csak az NA értékeket ismeri fel. Az adathalmazok gyakran kódolják a hiányzó értékeket üres karakterláncként, szóközként, „N/A”, „-” vagy őrszámként, például -99 vagy 999. Ezek a fenti ellenőrzéseken észrevétlenül átmennek. Importáláskor konvertáljuk őket, hogy a munkafolyamat többi része a következőképpen viselkedjen:
df <- read.csv(PATH, na.strings = c("", " ", "NA", "N/A", "-", "-99"))
Importálás után mindig vizsgáld meg az egyes numerikus oszlopok tartományát. A -99-es kor vagy a 9999-es ár sokkal veszélyesebb, mint egy őszinte NA, mert egyetlen függvény sem fog figyelmeztetni rá.
Hiányzó adatok típusai: MCAR, MAR és MNAR
Az, hogy egy érték miért hiányzik, meghatározza, hogy biztonságos-e annak imputálása. A statisztikusok három mechanizmust ismernek.
- MCAR, teljesen véletlenszerűen hiányzik. Az eltűnés valószínűsége független bármitől, legyen az megfigyelt vagy sem, például egy érzékelő véletlenszerű pillanatokban meghibásodik.ping Vagy ezen sorok imputálása nem okoz torzítást, csak pontosságvesztést.
- MAR, véletlenszerűen hiányzik. A valószínűség más megfigyelt változóktól függ, de nem magától a hiányzó értéktől. Ha az idősebb utasok életkorát kisebb valószínűséggel rögzítették, akkor az életkor a többi oszlop alapján MAR. Az ezeket az oszlopokat használó imputálás jól kezeli ezt.
- MNAR, nem véletlenszerűen hiányzik. A valószínűség magától a nem megfigyelt értéktől függ, például attól, hogy a magas keresetűek nem hajlandók megadni a jövedelmüket. Ezt egyetlen imputációs módszer sem tudja pusztán az adatokból kiküszöbölni, és maga a hiányzó érték is olyan információt hordoz, amelyet érdemes egy jelzőoszlopban rögzíteni.
Az ebben az oktatóanyagban használt átlagimputáció csak MCAR és egyszerű MAR esetén védhető. Még ebben az esetben is ismert a költsége: minden üres hely kitöltése ugyanazzal a számmal csökkenti az oszlop varianciáját, és gyengíti a korrelációját minden mással. Komoly munkához használjon modellalapú módszert, például a mice csomagot, és mindig jelölje meg egy oszlopban, hogy mely értékeket imputálta.
mute()
mutate() a dplyr egy új változót létrehozó vagy egy meglévőt felülíró ige, ami természetes eszközzé teszi egy oszlop tisztított másolatának létrehozásához.
Két részben folytatjuk. Megtanuljuk, hogyan:
- zárja ki a hiányzó értékeket egy adatkeretből
- a hiányzó értékeket az átlaggal és a mediánnal imputálja
A mute() ige nagyon könnyen használható. Létrehozhatunk egy új változót a következő szintaxis szerint:
mutate(df, name_variable_1 = condition, ...)
arguments:
-df: Data frame used to create a new variable
-name_variable_1: Name and the formula to create the new variable
-...: No limit constraint. Possibility to create more than one variable inside mutate()
Hiányzó értékek kizárása (NA)
Az na.omit() egy alap R függvény, nem egy dplyr ige, de mégis tisztán pipe-ol. Elvesz minden olyan sort, amely legalább egy NA-t tartalmaz. Ez a leggyorsabb lehetőség, és ritkán a legjobb, mert egyetlen hiányzó érték elveti az egész megfigyelést.
A hiányzó megfigyelések problémájának megoldására a Titanic adatkészletet fogjuk használni. Ebben az adatállományban hozzáférünk a fedélzeten tartózkodó utasok információihoz a tragédia idején. Ez az adatkészlet sok NA-val rendelkezik, amelyekről gondoskodni kell.
Töltsd be a CSV fájlt az internetről, majd listázd ki az NA-t tartalmazó oszlopokat:
PATH <- "https://raw.githubusercontent.com/guru99-edu/R-Programming/master/test.csv"
df_titanic <- read.csv(PATH, sep = ",")
# Return the column names containing missing observations
list_na <- colnames(df_titanic)[ apply(df_titanic, 2, anyNA) ]
list_na
output:
## [1] "age" "fare"
Itt,
colnames(df_titanic)[apply(df_titanic, 2, anyNA)]
visszaadja azoknak az oszlopoknak a nevét, amelyek legalább egy hiányzó értéket tartalmaznak.
Az életkor és a viteldíj oszlopok értékei hiányoznak.
Eldobhatjuk őket a na.omit() paranccsal.
library(dplyr)
# Exclude the missing observations
df_titanic_drop <-df_titanic %>%
na.omit()
dim(df_titanic_drop)
output:
## [1] 1045 13
Az új adatkészlet 1045 sort tartalmaz, szemben az eredeti adatkészlet 1309 sorával.
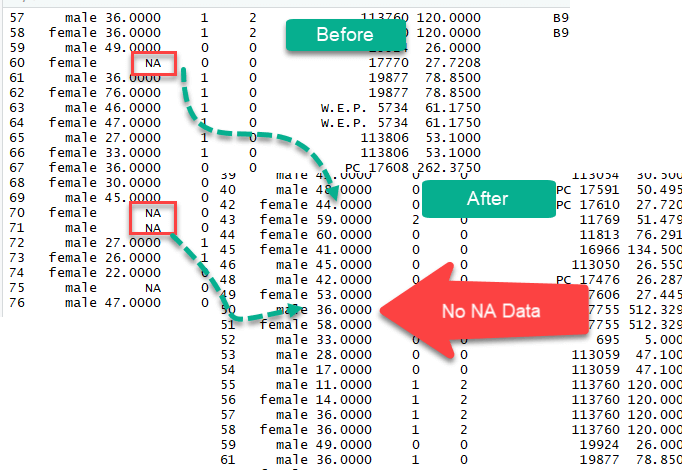
Hiányzó adatok pótlása az átlaggal és a mediánnal
A hiányzó értékeket imputálhatjuk, azaz kitölthetjük az átlaggal vagy a mediánnal. Jó gyakorlat, ha két külön változót hozunk létre az átlaghoz és a mediánhoz. Létrehozás után a hiányzó értékeket az újonnan létrehozott változókkal helyettesíthetjük.
Az NA-val rendelkező oszlop átlagának kiszámításához az Apply módszert fogjuk használni. Lássunk egy példát
Step 1) Az oktatóanyag korábbi részében a list_na nevű listában tároltuk az oszlopok nevét a hiányzó értékekkel. Ezt a listát fogjuk használni
Step 2) Számítsa ki az átlagot az na.rm = TRUE argumentummal. Ez az argumentum kötelező, mert az oszlopokból hiányoznak adatok, és ez arra utasítja az R-t, hogy hagyja figyelmen kívül azokat.
# Create mean
average_missing <- apply(df_titanic[,colnames(df_titanic) %in% list_na],
      2,
      mean,
      na.rm =  TRUE)
average_missing
Code Magyarázat:
4 argumentumot adunk át az alkalmazó metódusban.
- df: df_titanic[,colnames(df_titanic) %in% list_na]. Ez a kód visszaadja a list_na objektum oszlopnevét (azaz „age” és „fare”)
- 2: Számítsa ki a függvényt az oszlopokon
- átlag: Számítsa ki az átlagot
- na.rm = TRUE: A hiányzó értékek figyelmen kívül hagyása
output:
##      age     fare
## 29.88113 33.29548
Sikeresen elkészítettük a hiányzó megfigyeléseket tartalmazó oszlopok átlagát. Ezzel a két értékkel pótoljuk a hiányzó megfigyeléseket.
Step 3) Cserélje ki az NA értékeket
A dplyr könyvtárból származó mute ige hasznos új változó létrehozásához. Nem feltétlenül akarjuk megváltoztatni az eredeti oszlopot, hogy új változót tudjunk létrehozni az NA nélkül. A mute használata egyszerű, csak kiválasztunk egy változónevet, és meghatározzuk, hogyan kell létrehozni ezt a változót. Itt a teljes kód
# Create a new variable with the mean and median
df_titanic_replace <- df_titanic %>%
   mutate(replace_mean_age  = ifelse(is.na(age), average_missing[1], age),
   replace_mean_fare = ifelse(is.na(fare), average_missing[2], fare))
Code Magyarázat:
Két változót hozunk létre, a change_mean_age és a change_mean_fare értéket a következők szerint:
- csere_átlagos_kor = ifelse(is.na(kor), átlagos_hiányzó[1], életkor)
- csere_átlagos_viteldíj = ifelse(is.na(viteldíj), átlagos_hiányzó[2],viteldíj)
Ha az életkor oszlopból hiányzó értékek vannak, akkor cserélje ki az átlag_hiányzó (életkor átlaga) első elemére, különben megtartja az eredeti értékeket. Ugyanez a logika a viteldíjnál
sum(is.na(df_titanic_replace$age))
output:
## [1] 263
A csere után az új oszlop egyáltalán nem tartalmaz hiányzó értékeket:
sum(is.na(df_titanic_replace$replace_mean_age))
output:
## [1] 0
Az eredeti „kor” oszlop 263 hiányzó értéket tartalmaz, míg az új „replace_mean_age” oszlop mindegyiket kitöltötte az átlagos életkorral.
Step 4) A hiányzó megfigyeléseket a mediánnal is pótolhatjuk.
median_missing <- apply(df_titanic[,colnames(df_titanic) %in% list_na],
      2,
      median,
      na.rm =  TRUE)
df_titanic_replace <- df_titanic %>%
            mutate(replace_median_age  = ifelse(is.na(age), median_missing[1], age),
            replace_median_fare = ifelse(is.na(fare), median_missing[2], fare))
head(df_titanic_replace)
output:

Step 5) Egy nagy adathalmazon a lépésről lépésre haladó módszer unalmassá válik. Az apply() egyetlen utasításba omlasztja össze az egész eljárást, de ennek az az ára, hogy soha nem látja az imputált értékeket.
az apply nem hoz létre a adatkeret, így a sapply() függvényt becsomagolhatjuk a data.frame() keretbe, hogy adatkeret objektumot hozzunk létre.
# Quick code to replace missing values with the mean
df_titanic_impute_mean <- data.frame(
    sapply(
        df_titanic,
        function(x) ifelse(is.na(x),
            mean(x, na.rm = TRUE),
            x)))
Modern imputáció a replace_na() és across() függvényekkel
A fenti apply() és sapply() megközelítések továbbra is működnek, de a tidyr és a dplyr mostantól biztonságosabban és olvashatóbban fejezik ki ugyanazokat a műveleteket.
replace_na() fix értékek esetén. A tidyr::replace_na() függvény egy névvel ellátott oszloplistát és azok helyettesítőit veszi fel:
library(tidyr)

df_titanic %>%
    replace_na(list(age = 29.88, fare = 33.30))
across() minden numerikus oszlophoz. Ez a sapply() egysoros utasítás közvetlen, típusbiztos helyettesítője, és a sapply() függvénnyel ellentétben soha nem érinti a karakter- vagy faktoroszlopokat:
library(dplyr)

# Mean-impute every numeric column
df_titanic %>%
    mutate(across(where(is.numeric),
                  ~ ifelse(is.na(.x), mean(.x, na.rm = TRUE), .x)))

# Median-impute instead
df_titanic %>%
    mutate(across(where(is.numeric),
                  ~ ifelse(is.na(.x), median(.x, na.rm = TRUE), .x)))
⚠️ Miért kockázatos a sapply() parancsikon használata: az egysoros sapply() példa végigfut minden oszlop, beleértve a karakteres és faktoros oszlopokat is. A mean() meghívása ezekre NA értéket ad vissza figyelmeztetéssel, majd az apply() a teljes eredményt karakteresre alakítja. A fenti across(where(is.numeric), …) verzió ezt teljesen elkerüli.
coalesce() a tartalék oszlopokhoz. Amikor egy második oszlop is tudja a hiányzó értéket megadni, a coalesce() függvény az argumentumai alapján visszaadja az első nem hiányzó bejegyzést:
df %>% mutate(age_final = coalesce(age, age_estimated, 0))
Jegyezd fel, hogy mit változtattál meg. Adjunk hozzá egy jelzőt az imputálás előtt, hogy bármely későbbi modell tanulhasson a hiányzó értékből:
df_titanic %>%
    mutate(age_was_missing = is.na(age),
           age = ifelse(is.na(age), mean(age, na.rm = TRUE), age))
Hiányzó értékek kezelése R-ben: Metódusreferencia
Három megközelítést tárgyalunk ebben az oktatóanyagban:
- Zárja ki az összes hiányzó megfigyelést
- Imputáld az átlaggal
- Imputáld a mediánnal
Az alábbi táblázat összefoglalja az észlelést és az eltávolítást:
| könyvtár | Objektív | Code |
|---|---|---|
| bázis | Sorolja fel a hiányzó megfigyeléseket |
colnames(df)[apply(df, 2, anyNA)] |
| bázis | Távolítson el minden NA-t tartalmazó sort |
na.omit(df) |
Az átlaggal vagy mediánnal való imputálás kétféleképpen történhet
- Az alkalmazás használata
- Sapply használata
| Módszer | Részletek | Előnyök | Hátrányok |
|---|---|---|---|
| Lépésről lépésre az alkalmazással | Ellenőrizze a hiányzó oszlopokat, számítsa ki az átlagot/mediánt, tárolja az értéket, cserélje ki a mute() | Láthatja az imputált átlagot vagy mediánt | Több végrehajtási idő. Lassú lehet nagy adatkészlettel |
| Gyors út, applikátorral | A sapply() és data.frame() használatával automatikusan megkeresheti és a hiányzó értékeket átlag/mediánra cserélheti | Rövid kód és gyors | A bevitt értékek soha nem jelennek meg |
