
Lineáris regressziós oktatóanyag a TensorFlow-val [Példák]
 Szerkesztőség
⚡ Okos összefoglaló
A TensorFlow lineáris regressziója a numerikus jellemzők és egy folytonos célérték közötti kapcsolatot modellezi. Ez a bemutató egy bostoni ingatlanár-előrejelzőt három különböző módon tanít be, Pandas, NumPy és natív TensorFlow bemeneti folyamatok használatával a LinearRegressor becslővel.
Mi az a lineáris regresszió?
Lineáris regresszió egy statisztikai megközelítés két változó közötti kapcsolatok modellezésére. Ez a modellezés egy skaláris válasz és egy vagy több magyarázó változó között történik. Az egy magyarázó változóval rendelkező kapcsolatot egyszerű lineáris regressziónak, egynél több magyarázó változóval rendelkező kapcsolatot pedig többszörös lineáris regressziónak nevezzük.
A TensorFlow eszközöket biztosít a számítások teljes ellenőrzéséhez. Ez az alacsony szintű API-val történik. Ezen felül a TensorFlow API-k széles skálájával van felszerelve, hogy sok mindent végrehajtson gépi tanulás algoritmusok. Ez a magas szintű API, és a TensorFlow becslőknek nevezi őket.
- Alacsony szintű APIA modell architektúrájának és optimalizálásának felépítése a nulláról. Ez bonyolult lehet egy kezdő számára.
- Magas szintű API: Definiálja az algoritmust. Felhasználóbarát. A TensorFlow egy eszköztárat biztosít, melynek neve becslő konstruálni, betanítani, értékelni és jóslatokat készíteni.
Ebben az oktatóanyagban a csak becslésekA számítások gyorsabbak és könnyebben megvalósíthatók. Az első rész elmagyarázza, hogyan használható a gradiens ereszkedés optimalizáló lineáris regresszió betanításához a TensorFlow-ban. A második részben a Boston adathalmazt fogja használni egy ház árának előrejelzésére egy TensorFlow becslő segítségével.
Hogyan tanítsunk lineáris regressziós modellt
Mielőtt elkezdenénk a modell betanítását, nézzük meg, hogy mit is jelent valójában a lineáris regresszió.
Képzeld el, hogy két változód van, x és y, és a feladatod az y értékének előrejelzése x értékének ismeretében. Ha ábrázolod az adatokat, pozitív kapcsolatot láthatsz a független változó, x, és a függő változó, y között, ahogy az alábbi szóródási diagram is mutatja.

Megfigyelheted, hogy ha x=1, akkor y nagyjából 6 lesz, és ha x=2, akkor y körülbelül 8.5.
Ez nem egy túl pontos módszer, és hajlamos a hibákra, különösen egy több százezer pontot tartalmazó adathalmaz esetén.
A lineáris regressziót egy egyenlettel értékeljük ki. Az y változót egy vagy több kovariáns magyarázza. A példádban csak egy függő változó van. Ha meg kell írni ezt az egyenletet, akkor ez lesz:

Val vel:
 az eltolás. Azaz, ha x=0, akkor y=
 az x-hez tartozó súly
 a reziduális, vagyis a modell hibája. Magában foglalja azt, amit a modell nem tud megtanulni az adatokból.
Képzelje el, hogy megfelel a modellnek, és a következő megoldást találja:
- = 3.8
- = 2.78
Behelyettesítheti ezeket a számokat az egyenletben, és ez lesz:
y= 3.8 + 2.78x
Most már van egy jobb módszered az y értékeinek megtalálására. Vagyis az x-et bármilyen értékkel helyettesítheted, hogy megjósold y-t. Az alábbi képen az egyenletben az x-et az adathalmaz összes értékével helyettesítettük, és ábrázoltuk az eredményt.

A piros vonal az illesztett értéket jelöli, azaz az y értékeit x minden egyes értékéhez. Nem kell látnod x értékét ahhoz, hogy megjósold y-t; minden x-hez van egy érték, amely a piros vonalhoz tartozik. 2-nél nagyobb x értékekre is lehet jósolni.
Ha a lineáris regressziót több kovariánsra szeretnéd kiterjeszteni, ezt úgy teheted meg, hogy további változókat adsz a modellhez. A hagyományos analízis és a lineáris regresszió közötti különbség az, hogy a lineáris regresszió azt vizsgálja, hogy y hogyan reagál minden egyes x változóra külön-külön.
Nézzünk egy példát. Képzeljük el, hogy egy fagylaltozó eladásait szeretnénk megjósolni. Az adathalmaz különböző információkat tartalmaz, például az időjárást (esős, napos, felhős) és a vásárlói információkat (fizetés, nem, családi állapot).
A hagyományos elemzés megpróbálja megjósolni az eladást, mondjuk úgy, hogy kiszámítja az egyes változók átlagát, és megpróbálja megbecsülni az eladást különböző forgatókönyvek esetén. Ez rossz előrejelzésekhez vezet, és az elemzést a kiválasztott forgatókönyvre korlátozza.
Ha lineáris regressziót használ, felírhatja ezt az egyenletet:
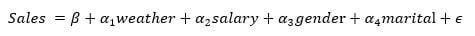
Az algoritmus megkeresi a súlyokra vonatkozó legjobb megoldást; ez azt jelenti, hogy megpróbálja minimalizálni a költséget, ami az illesztett egyenes és az adatpontok közötti különbség.
Hogyan működik az algoritmus
Az alábbi ábra összefoglalja az algoritmus által ismétlődő ciklust: súlyok kiválasztása, y előrejelzése, a hiba mérése és a súlyok korrigálása.

Az algoritmus mindegyikhez kiválaszt egy véletlen számot  és a
 és cserélje ki x értékét, hogy megkapja y előrejelzett értékét. Ha az adatkészlet 100 megfigyelést tartalmaz, az algoritmus 100 előrejelzett értéket számít ki.
Ki tudjuk számítani a hibát, jegyezte meg  , a modell , ami a jósolt érték és a valós érték közötti különbség. A pozitív hiba azt jelenti, hogy a modell alábecsüli az y előrejelzését, a negatív hiba pedig azt, hogy a modell túlbecsüli az y előrejelzését.

A célod a hiba négyzetének minimalizálása. Az algoritmus kiszámítja a négyzetes hiba átlagát. Ezt a lépést a hiba minimalizálásának nevezzük. Lineáris regresszió esetén ez a Mean Square Error, más néven MSE. Matematikailag ez:

Ahol:
 a súlyok, tehát
 az előre jelzett értékre utal
- y a valós értékek
- m a megfigyelések száma
 az előre jelzett értékre utal
Ne feledje, hogy  azt jelenti, hogy a mátrixok transzponálását használja. A
 az átlag matematikai jelölése.
A cél a legjobb megtalálása  ami minimalizálja az MSE-t.
Ha az átlagos hiba nagy, az azt jelenti, hogy a modell rosszul teljesít, és a súlyokat nem megfelelően választották meg. A súlyok kijavításához optimalizálót kell használni. A hagyományos optimalizáló ún Gradiens Descent.
A gradiens süllyedés a deriváltat veszi, és csökkenti vagy növeli a súlyt. Ha a derivált pozitív, a súly csökken. Ha a derivált negatív, a súly növekszik. A modell frissíti a súlyokat, és újraszámítja a hibát. Ez a folyamat addig ismétlődik, amíg a hiba már nem változik. Minden menetet egy ismétlésEzenkívül a gradienseket megszorozzák a tanulási rátával, amely a tanulás sebességét jelzi.
Ha a tanulási ráta túl kicsi, nagyon sokáig tart, amíg az algoritmus konvergál, mivel sokkal több iterációt igényel. Ha a tanulási ráta túl magas, az algoritmus soha nem konvergálhat. Az alábbi veszteséggörbe a hibát ábrázolja az iterációk számának függvényében erre az adathalmazra vonatkozóan.

A fenti képen látható, hogy a modell körülbelül 20-szor megismétli a folyamatot, mielőtt stabil értéket talál a súlyoknak, így éri el a legkisebb hibát.
Megjegyzendő, hogy a hiba nem egyenlő nullával, hanem 5 körül stabilizálódik. Ez azt jelenti, hogy a modell tipikus hibája 5. Ha csökkenteni szeretné a hibát, több információt kell hozzáadnia a modellhez, például több változót, vagy különböző becslőfüggvényeket kell használnia.
Emlékszel az első egyenletre:

A végső súlyok 3.8 és 2.78. Az alábbi videó bemutatja, hogyan optimalizálja a gradiens süllyedés a veszteségfüggvényt ezen súlyok megtalálásához.
Hogyan tanítsunk lineáris regressziót a TensorFlow segítségével
Most, hogy jobban megértette, mi történik a motorháztető mögött, készen áll a TensorFlow által biztosított becslő API használatára az első lineáris regresszió képzésére a TensorFlow segítségével.
Verzió megjegyzés: Az alább látható becslő munkafolyamatot a TensorFlow 1.x és a korai 2.x kiadások alapján írták. A TensorFlow a következőt jelölte meg: tf.estimator és a tf.feature_column Az API-k teljesen elavultak a 2.12-es verzióban, és a becslők a 2.16-os verzióban elhagyták őket. Jelenlegi telepítés esetén futtassa ezt a kódot egy TensorFlow 1.15 vagy 2.x-ben, amely-tf.compat.v1 környezetbe, vagy átvinni Kerasba, ahol tf.keras.layers.Dense(1) Ráadásul az előfeldolgozó rétegek felváltják a LinearRegressort és a jellemzőoszlopokat. A fogalmak – jellemzők, címkék, kötegek, korszakok, MSE és gradiens leszállás – változatlanul megmaradnak.
A Boston Dataset-et fogod használni, amely a következő változókat tartalmazza.
| Változó | Leírás |
| krimi | az egy főre jutó bűnözési ráta városonként |
| zn | a 25,000 XNUMX négyzetméter feletti telkekre övezett lakóterület aránya. |
| indus | városonkénti nem kiskereskedelmi üzleti hektárok aránya. |
| nox | nitrogén-oxidok koncentrációja |
| rm | átlagos szobaszám lakásonként |
| kor | az 1940 előtt épült, saját tulajdonú egységek aránya |
| dis | súlyozott távolságok öt bostoni munkaügyi központtól |
| adó | teljes értékű ingatlanadó kulcsa dolláronként 10,000 XNUMX |
| ptratio | tanuló-tanár arány városonként |
| medv | A tulajdonos által használt házak medián értéke ezer dollárban |
Három különböző adatkészletet fog létrehozni:
| adatbázisba | célkitűzés | formálják |
| Képzések | Tanítsd meg a modellt és szerezd meg a súlyokat | 400, 10 |
| Értékelés | Értékelje a modell teljesítményét nem látott adatokon | 100, 10 |
| Tippelje | Használja a modellt a ház értékének előrejelzésére új adatok alapján | 6, 10 |
A cél az adathalmaz jellemzőinek felhasználása a ház értékének előrejelzésére.
Az oktatóanyag második részében megtanulod, hogyan használhatod a TensorFlow-t az adatok importálására három különböző módon:
- Pandákkal
- A numpy
- Csak TensorFlow
Megjegyzendő, hogy mindhárom lehetőség ugyanazt az eredményt adja.
Megtanulod, hogyan használhatod a magas szintű API-t egy TensorFlow lineáris regressziós modell felépítéséhez, betanításához és kiértékeléséhez. Ha az alacsony szintű API-t használnád, akkor kézzel kellene definiálnod a következőket:
- Veszteség funkció
- Optimalizáló: gradiens süllyedés
- Mátrixszorzás
- Grafikon és tenzor
Ez egy kezdő számára fárasztóbb és bonyolultabb.
Pandák Megoldása
A modell betanításához importálnia kell a szükséges könyvtárakat.
import pandas as pd
from sklearn import datasets
import tensorflow as tf
import itertools
Step 1) Importálja az adatokat ezzel pandák.
Az oszlopneveket definiálod, és a COLUMNS mappában tárolod. A pd.read_csv() függvénnyel importálhatod az adatokat.
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
           "dis", "tax", "ptratio", "medv"]
Minden egyes hívásnál irányítsa a korábban letöltött CSV-fájlokat.
training_set = pd.read_csv("E:/boston_train.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
test_set = pd.read_csv("E:/boston_test.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
prediction_set = pd.read_csv("E:/boston_predict.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
Kinyomtathatja az adatok alakját.
print(training_set.shape, test_set.shape, prediction_set.shape)
teljesítmény
(400, 10) (100, 10) (6, 10)
Megjegyzendő, hogy a címke, azaz az y, szerepel az adathalmazban. Tehát két másik listát kell definiálnod: az egyik csak a jellemzőket tartalmazza, a másik pedig csak a címke nevét. Ez a két lista fogja megmondani a becslődnek, hogy melyek az adathalmaz jellemzői, és melyik oszlopnév a címke.
Ez az alábbi kóddal történik.
FEATURES = ["crim", "zn", "indus", "nox", "rm",
                 "age", "dis", "tax", "ptratio"]
LABEL = "medv"
Step 2) Konvertálja az adatokat
A numerikus változókat a megfelelő formátumba kell konvertálnod. A TensorFlow egy metódust biztosít a folytonos változók konvertálására: tf.feature_column.numeric_column().
Az előző lépésben definiált egy listát a modellbe foglalni kívánt jellemzőkről. Most ezt a listát felhasználhatja numerikus adatokká alakítására. Ha ki szeretne zárni jellemzőket a modellből, nyugodtan elhagyhat egy vagy több változót a FEATURES listából, mielőtt létrehozná a feature_cols változót.
Ne feledd, hogy egy Python A FEATURES listával végrehajtott listaértelmezéssel létrehozunk egy új, feature_cols nevű listát. Ez segít elkerülni a tf.feature_column.numeric_column() kilencszeri kiírását. A listaértelmezés egy gyorsabb és tisztább módja az új listák létrehozásának.
feature_cols = [tf.feature_column.numeric_column(k) for k in FEATURES]
Step 3) Határozza meg a becslést
Ebben a lépésben meg kell határoznia a becslőt. A TensorFlow hat előre elkészített becslőt biztosít, hármat osztályozási feladatokhoz és hármat TensorFlow regressziós feladatokhoz:
- Regresszor
- DNNRegressor
- Lineáris regresszor
- DNNLineárisKombináltRegresszor
- osztályoz
- DNNC osztályozó
- Lineáris osztályozó
- DNNLinearCombinedClassifier
Ebben az oktatóanyagban a Lineáris regresszort fogja használni. A funkció eléréséhez a tf.estimator programot kell használnia.
A függvénynek két argumentumra van szüksége:
- feature_columns: tartalmazza a modellbe foglalandó változókat
- model_dir: a gráf tárolására szolgáló elérési út, a modellparaméterek mentése stb.
A TensorFlow automatikusan létrehoz egy train nevű mappát a munkakönyvtáradban. Ezt az elérési utat kell használnod a eléréséhez. TensorBoard, ahogy az alábbi TensorFlow regressziós példában látható.
estimator = tf.estimator.LinearRegressor(
        feature_columns=feature_cols,
        model_dir="train")
teljesítmény
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a215dc550>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
A TensorFlow nehézsége a modell betáplálásának módja. A TensorFlow-t párhuzamos számítástechnikával és nagyon nagy adathalmazokkal való működésre tervezték. A gépi erőforrások korlátozottsága miatt lehetetlen egyszerre az összes adattal ellátni a modellt. Ehhez minden alkalommal egy adatköteget kell betáplálni. Fontos megjegyezni, hogy hatalmas adathalmazokról beszélünk, több millió vagy több rekorddal. Ha nem adunk hozzá egy köteget, memóriahiba keletkezik.
Ha például az adatok 100 megfigyelést tartalmaznak, és 10-es kötegméretet ad meg, az azt jelenti, hogy a modell 10 megfigyelést fog látni minden iterációhoz (10*10).
Amikor a modell az összes adatot látta, befejez egy epochot. Egy epoch meghatározza, hogy hányszor szeretné, hogy a modell lássa az adatokat. Jobb, ha ezt a lépést nullára állítja, és hagyja, hogy a modell egy meghatározott számú iterációt hajtson végre.
Egy másik hozzáadandó információ, hogy minden iteráció előtt szeretnénk-e keverni az adatokat. A betanítás során fontos az adatok keverése, hogy a modell ne tanulja meg az adathalmaz egy adott mintáját. Ha a modell megtanulja az adatok mögöttes mintázatának részleteit, akkor nehezen tudja általánosítani a predikciót a láthatatlan adatokra. Ezt túlillesztésének nevezzük. A modell jól teljesít a betanítási adatokon, de nem tud helyesen predikciót készíteni a láthatatlan adatokra.
A TensorFlow megkönnyíti ezt a két lépést. Amikor az adatok a folyamatba kerülnek, tudja, hány megfigyelésre van szükség (kötegelt feldolgozás), és hogy össze kell-e kevernie az adatokat.
A TensorFlow modell betáplálására vonatkozó utasításához a pandas_input_fn függvényt használhatod. Ennek az objektumnak öt paraméterre van szüksége:
- x: jellemző adatok
- y: címkeadatok
- batch_size: köteg. Alapértelmezés szerint 128
- num_epoch: korszakok száma, alapértelmezés szerint 1
- shuffle: az adatok összekeverése vagy sem. Alapértelmezés szerint a Nincs beállítás.
A modellt sokszor kell betáplálnod, ezért definiálsz egy függvényt, amely megismétli ezt a folyamatot. Nevezd meg ezt a függvényt get_input_fn-nek.
def get_input_fn(data_set, num_epochs=None, n_batch = 128, shuffle=True):
         return tf.estimator.inputs.pandas_input_fn(
         x=pd.DataFrame({k: data_set[k].values for k in FEATURES}),
         y = pd.Series(data_set[LABEL].values),
         batch_size=n_batch,
         num_epochs=num_epochs,
         shuffle=shuffle)
A modell teljesítményének értékelésének szokásos módszere a következő:
- Tanítsd meg a modellt
- A modell kiértékelése egy másik adathalmazon
- Készítsen jóslatot
A TensorFlow becslő három különböző függvényt biztosít e három lépés egyszerű végrehajtásához.
Step 4) Tanítsd meg a modellt
A modell illesztéséhez használhatod a becslési_vonat metódust. A becslési_vonatnak szüksége van egy input_fn változóra és néhány lépésre. A fent létrehozott függvényt használhatod a modell betáplálásához. Ezután utasítod a modellt, hogy 1000-szer iteráljon. Figyeld meg, hogy nem adod meg az epochok számát; hagyod, hogy a modell 1000-szer iteráljon. Ha az epochok számát 1-re állítod, akkor a modell négyszer fog iterálni, mivel 400 rekord van a tanulóhalmazban, és a batch mérete 128:
- 128 sorok
- 128 sorok
- 128 sorok
- 16 sorok
Ezért egyszerűbb az epochok számát nullára állítani, és az iterációk számát meghatározni, ahogy az az alábbi TensorFlow osztályozási példában látható.
estimator.train(input_fn=get_input_fn(training_set,
                                           num_epochs=None,
                                           n_batch = 128,
                                           shuffle=False),
                                           steps=1000)
teljesítmény
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 238.616
INFO:tensorflow:loss = 13909.657, step = 101 (0.420 sec)
INFO:tensorflow:global_step/sec: 314.293
INFO:tensorflow:loss = 12881.449, step = 201 (0.320 sec)
INFO:tensorflow:global_step/sec: 303.863
INFO:tensorflow:loss = 12391.541, step = 301 (0.327 sec)
INFO:tensorflow:global_step/sec: 308.782
INFO:tensorflow:loss = 12050.5625, step = 401 (0.326 sec)
INFO:tensorflow:global_step/sec: 244.969
INFO:tensorflow:loss = 11766.134, step = 501 (0.407 sec)
INFO:tensorflow:global_step/sec: 155.966
INFO:tensorflow:loss = 11509.922, step = 601 (0.641 sec)
INFO:tensorflow:global_step/sec: 263.256
INFO:tensorflow:loss = 11272.889, step = 701 (0.379 sec)
INFO:tensorflow:global_step/sec: 254.112
INFO:tensorflow:loss = 11051.9795, step = 801 (0.396 sec)
INFO:tensorflow:global_step/sec: 292.405
INFO:tensorflow:loss = 10845.855, step = 901 (0.341 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
A TensorBoardot a következő paranccsal ellenőrizheted:
activate hello-tf
# For MacOS
tensorboard --logdir=./train
# For Windows
tensorboard --logdir=train
Step 5) Értékelje a modelljét
Az alábbi kóddal értékelheti modellje tesztkészlethez való illeszkedését:
ev = estimator.evaluate(
          input_fn=get_input_fn(test_set,
          num_epochs=1,
          n_batch = 128,
          shuffle=False))
teljesítmény
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
A veszteséget az alábbi kóddal nyomtathatja ki:
loss_score = ev["loss"]
print("Loss: {0:f}".format(loss_score))
teljesítmény
Loss: 3215.895996
A modell vesztesége 3215. Az összefoglaló statisztikákban képet kaphat arról, hogy mekkora a hiba.
training_set['medv'].describe()
teljesítmény
count    400.000000
mean      22.625500
std        9.572593
min        5.000000
25%       16.600000
50%       21.400000
75%       25.025000
max       50.000000
Name: medv, dtype: float64
A fenti összefoglaló statisztikából látható, hogy egy ház átlagára 22 ezer, a minimumár 5 ezer és a maximum 50 ezer. Mivel a jelentett veszteség az átlagos négyzetes hiba, az eredeti egységekben a tipikus hiba nagyjából 32.16 négyzetgyöke, ami körülbelül 5.7 ezer dollárt jelent.
Step 6) Tedd meg a jóslatot
Végül a TensorFlow predict becslő metódusával becsülheti meg hat bostoni ház értékét.
y = estimator.predict(
         input_fn=get_input_fn(prediction_set,
         num_epochs=1,
         n_batch = 128,
         shuffle=False))
A becsült értékek kinyomtatásához használhatja ezt a kódot:
predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
teljesítmény
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.96125], dtype=float32), array([27.270979], dtype=float32), array([29.299236], dtype=float32), array([16.436684], dtype=float32), array([21.460876], dtype=float32)]
A modell a következő értékeket jósolja:
| Ház | Jóslás |
| 1 | 32.29 |
| 2 | 18.96 |
| 3 | 27.27 |
| 4 | 29.29 |
| 5 | 16.43 |
| 6 | 21.46 |
Megjegyzendő, hogy nem ismerjük ennek a hat háznak a valódi értékét. A mélytanulási oktatóanyagban megpróbálod felülmúlni a lineáris modellt.
NumPy megoldás
Ez a szakasz ismerteti, hogyan lehet a modellt NumPy becslő használatával betanítani az adatok betanításához. A módszer ugyanaz, azzal a különbséggel, hogy a numpy_input_fn becslőt kell használni.
Olvasd be ugyanazt a három CSV fájlt, de csak a nyers NumPy tömböket tartsd meg .values kiterjesztéssel.
training_set_n = pd.read_csv("E:/boston_train.csv").values
test_set_n = pd.read_csv("E:/boston_test.csv").values
prediction_set_n = pd.read_csv("E:/boston_predict.csv").values
Step 1) Importálja az adatokat
Először is meg kell különböztetni a jellemzőváltozókat a címkétől. Ezt a betanítási adatok és a kiértékelő adatok esetében is meg kell tenni. Gyorsabb, ha definiálsz egy függvényt az adatok felosztására.
def prepare_data(df):
        X_train = df[:, :-3]
        y_train = df[:,-3]
        return X_train, y_train
A függvénnyel elválaszthatja a címkét a vonat jellemzőitől, és kiértékelheti az adathalmazokat.
X_train, y_train = prepare_data(training_set_n)
X_test, y_test = prepare_data(test_set_n)
Ki kell zárni az előrejelzési adatkészlet utolsó oszlopát, mert az csak NaN-t tartalmaz.
x_predict = prediction_set_n[:, :-2]
Erősítse meg a tömb alakját. Vegye figyelembe, hogy a címkének nem lehet második dimenziója, ami (400,)-at jelent.
print(X_train.shape, y_train.shape, x_predict.shape)
teljesítmény
(400, 9) (400,) (6, 9)
A jellemző oszlopokat a következőképpen hozhatja létre:
feature_columns = [ tf.feature_column.numeric_column('x', shape=X_train.shape[1:])]
A becslő definiálása a korábbiakhoz hasonlóan történik: megadjuk a jellemzőoszlopokat és a grafikon mentési helyét.
estimator = tf.estimator.LinearRegressor(
         feature_columns=feature_columns,
         model_dir="train1")
teljesítmény
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train1', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a218d8f28>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
A NumPy becslő segítségével betáplálhatod az adatokat a modellbe, majd betaníthatod a modellt. Fontos megjegyezni, hogy az input_fn függvényt előre definiáltuk az olvashatóság megkönnyítése érdekében.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
           x={"x": X_train},
           y=y_train,
           batch_size=128,
           shuffle=False,
           num_epochs=None)
estimator.train(input_fn = train_input,steps=5000)
teljesítmény
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train1/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 490.057
INFO:tensorflow:loss = 13909.656, step = 101 (0.206 sec)
INFO:tensorflow:global_step/sec: 788.986
INFO:tensorflow:loss = 12881.45, step = 201 (0.126 sec)
INFO:tensorflow:global_step/sec: 736.339
INFO:tensorflow:loss = 12391.541, step = 301 (0.136 sec)
INFO:tensorflow:global_step/sec: 383.305
INFO:tensorflow:loss = 12050.561, step = 401 (0.260 sec)
INFO:tensorflow:global_step/sec: 859.832
INFO:tensorflow:loss = 11766.133, step = 501 (0.117 sec)
INFO:tensorflow:global_step/sec: 804.394
INFO:tensorflow:loss = 11509.918, step = 601 (0.125 sec)
INFO:tensorflow:global_step/sec: 753.059
INFO:tensorflow:loss = 11272.891, step = 701 (0.134 sec)
INFO:tensorflow:global_step/sec: 402.165
INFO:tensorflow:loss = 11051.979, step = 801 (0.248 sec)
INFO:tensorflow:global_step/sec: 344.022
INFO:tensorflow:loss = 10845.854, step = 901 (0.288 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train1/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.985.
Out[23]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x1a1b6ea860>
Ugyanezt a lépést megismételjük egy másik bemeneti függvénnyel a modell kiértékeléséhez.
eval_input = tf.estimator.inputs.numpy_input_fn(
       x={"x": X_test},
       y=y_test,
       shuffle=False,
       batch_size=128,
       num_epochs=1)
   estimator.evaluate(eval_input,steps=None)
teljesítmény
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.158947, global_step = 1000, loss = 3215.8945
Out[24]:
{'average_loss': 32.158947, 'global_step': 1000, 'loss': 3215.8945}
Végül kiszámíthatod a jóslatot. Hasonlónak kell lennie a Pandas eredményéhez.
test_input = tf.estimator.inputs.numpy_input_fn(
        x={"x": x_predict},
        batch_size=128,
        num_epochs=1,
        shuffle=False)
        y = estimator.predict(test_input)

predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
teljesítmény
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.961248], dtype=float32), array([27.270979], dtype=float32), array([29.299242], dtype=float32), array([16.43668], dtype=float32), array([21.460878], dtype=float32)]
TensorFlow megoldás
Az utolsó rész egy tisztaságnak van szentelve. TensorFlow megoldás. Ez a módszer valamivel bonyolultabb, mint a másik kettő.
Ne feledd, hogy ha egy Jupyter jegyzetfüzet, újra kell indítania és törölnie kell a kernelt a munkamenet futtatásához.
A TensorFlow készített egy nagyszerű eszközt az adatok folyamatba juttatásához. Ebben a szakaszban az input_fn függvényt fogod magad felépíteni.
Step 1) Határozza meg az adatok elérési útját és formátumát
Először is, deklarálj két változót a CSV fájlok elérési útjával. Figyeld meg, hogy két fájlod van, az egyik a tanulóhalmaznak, a másik a teszthalmaznak.
import tensorflow as tf
df_train = "E:/boston_train.csv"
df_eval = "E:/boston_test.csv"
Ezután meg kell határoznod a CSV fájlban használni kívánt oszlopokat. Mindegyiket fel fogjuk használni. Ezután deklarálnod kell az egyes változók típusát.
A lebegőpontos változókat [0.] definiálja.
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
                "dis", "tax", "ptratio", "medv"]
RECORDS_ALL = [[0.0], [0.0], [0.0], [0.0],[0.0],[0.0],[0.0],[0.0],[0.0],[0.0]]
Step 2) Határozza meg az input_fn függvényt
A függvény három részre bontható:
- Importálja az adatokat
- Hozd létre az iterátort
- Fogyassza az adatokat
Az alábbiakban a függvény definiálásához szükséges teljes kód látható. A kódot később ismertetjük.
def input_fn(data_file, batch_size, num_epoch = None):
       # Step 1
          def parse_csv(value):
          columns = tf.decode_csv(value, record_defaults= RECORDS_ALL)
          features = dict(zip(COLUMNS, columns))
          #labels = features.pop('median_house_value')
          labels =  features.pop('medv')
          return features, labels

          # Extract lines from input files using the Dataset API.
          dataset = (tf.data.TextLineDataset(data_file) # Read text file
          .skip(1) # Skip header row
          .map(parse_csv))

          dataset = dataset.repeat(num_epoch)
          dataset = dataset.batch(batch_size)
          # Step 3
          iterator = dataset.make_one_shot_iterator()
          features, labels = iterator.get_next()
          return features, labels
Importálja az adatokat
CSV-fájl esetén a dataset metódus egyszerre egy sort olvas be. Az adathalmaz felépítéséhez a következő objektumot kell használni: TextLineAdatkészlet. Az adatkészletednek van egy fejléce, ezért a skip(1) függvénnyel kell kihagynod az első sort. Ezen a ponton csak az adatokat olvasod be, a fejlécet kizárod a folyamatból. A modell betáplálásához el kell választanod a jellemzőket a címkétől. Az adatokra történő transzformációk alkalmazásához használt metódus a map.
Ez a metódus meghív egy olyan függvényt, amelyet azért hozol létre, hogy utasítsd az adatok átalakítását. Dióhéjban, át kell adnod az adatokat a következőnek: TextLineAdatkészlet objektum, kizárjuk a fejlécet, és alkalmazunk egy függvény által utasított transzformációt.
Code magyarázat
- tf.data.TextLineDataset(adatfájl): ez a sor beolvassa a CSV fájlt
- .skip(1): kihagyja a fejlécet
- .map(parse_csv)): tenzorokká elemzi a rekordokat
Definiálnod kell egy függvényt a map objektum utasításaihoz. Ezt a függvényt parse_csv-nek hívhatod.
Ez a függvény a tf.decode_csv metódussal elemzi a CSV fájlt, és deklarálja a jellemzőket és a címkét. A jellemzők deklarálhatók szótárként vagy tuple-ként. A szótár metódust azért használd, mert az kényelmesebb.
Code magyarázat
- tf.decode_csv(value, record_defaults= RECORDS_ALL): a decode_csv metódus a TextLineAdatkészlet a CSV fájl beolvasásához. A record_defaults utasításokat ad a TensorFlow-nak az oszloptípusokról. A TensorFlow 2.x-ben ez a szimbólum a tf.io.decode_csv címen található.
- dict(zip(COLUMNS, oszlopok)): feltölti a szótárat az összes oszloppal, pl.tracaz adatfeldolgozás során
- features.pop('medv'): kizárja a célváltozót a jellemzőváltozók közül, és létrehoz egy címkeváltozót
Az adathalmaznak további elemekre van szüksége a tenzorok iteratív betáplálásához. Valójában hozzá kell adni a „repeat” metódust, hogy az adathalmaz a végtelenségig folytathassa a modell táplálását. Ha nem adjuk hozzá a metódust, a modell csak egyszer fog iterálni, majd hibát dob, mert nem kerül több adat a folyamatba.
Ezután a batch metódussal szabályozhatod a köteg méretét. Ez azt jelenti, hogy megmondod az adathalmaznak, hogy mennyi adatot szeretnél átadni a folyamatnak minden iterációban. Ha nagy kötegméretet állítasz be, a modell lassú lesz.
Step 3) Hozd létre az iterátort
Most készen áll a második lépésre: hozzon létre egy iterátort az adatkészlet elemeinek visszaadásához.
Az operátor létrehozásának legegyszerűbb módja a make_one_shot_iterator metódus.
Ezt követően az iterátorból létrehozhatja a szolgáltatásokat és a címkéket.
Step 4) Fogyassza az adatokat
Ellenőrizheted, mi történik az input_fn függvénnyel. Egy munkamenetben kell meghívnod a függvényt az adatok feldolgozásához. 1-es kötegmérettel próbálkozol.
Megjegyzendő, hogy a szótárban található jellemzőket, a címkét pedig tömbként nyomtatja ki.
A CSV fájl első sorát fogja megjeleníteni. Ezt a kódot sokszor megpróbálhatod futtatni különböző kötegméretekkel.
next_batch = input_fn(df_train, batch_size = 1, num_epoch = None)
with tf.Session() as sess:
     first_batch  = sess.run(next_batch)
     print(first_batch)
teljesítmény
({'crim': array([2.3004], dtype=float32), 'zn': array([0.], dtype=float32), 'indus': array([19.58], dtype=float32), 'nox': array([0.605], dtype=float32), 'rm': array([6.319], dtype=float32), 'age': array([96.1], dtype=float32), 'dis': array([2.1], dtype=float32), 'tax': array([403.], dtype=float32), 'ptratio': array([14.7], dtype=float32)}, array([23.8], dtype=float32))
Step 5) Határozza meg a jellemző oszlopot
A numerikus oszlopokat a következőképpen kell definiálnia:
X1= tf.feature_column.numeric_column('crim')
X2= tf.feature_column.numeric_column('zn')
X3= tf.feature_column.numeric_column('indus')
X4= tf.feature_column.numeric_column('nox')
X5= tf.feature_column.numeric_column('rm')
X6= tf.feature_column.numeric_column('age')
X7= tf.feature_column.numeric_column('dis')
X8= tf.feature_column.numeric_column('tax')
X9= tf.feature_column.numeric_column('ptratio')
Ne feledd, hogy az összes változót egy vödörben kell kombinálnod.
base_columns = [X1, X2, X3,X4, X5, X6,X7, X8, X9]
Step 6) Építsd meg a modellt
A modellt a LinearRegressor becslővel taníthatja.
model = tf.estimator.LinearRegressor(feature_columns=base_columns, model_dir='train3')
teljesítmény
INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_model_dir': 'train3', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1820a010f0>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Használnia kell a lambda funkció hogy argumentumokat írhass az input_fn függvényhez. Ha nem használsz lambda függvényt, nem tudod betanítani a modellt.
# Train the estimator
model.train(steps =1000,
          input_fn= lambda : input_fn(df_train,batch_size=128, num_epoch = None))
teljesítmény
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train3/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 72.5646
INFO:tensorflow:loss = 13909.657, step = 101 (1.380 sec)
INFO:tensorflow:global_step/sec: 101.355
INFO:tensorflow:loss = 12881.449, step = 201 (0.986 sec)
INFO:tensorflow:global_step/sec: 109.293
INFO:tensorflow:loss = 12391.541, step = 301 (0.915 sec)
INFO:tensorflow:global_step/sec: 102.235
INFO:tensorflow:loss = 12050.5625, step = 401 (0.978 sec)
INFO:tensorflow:global_step/sec: 104.656
INFO:tensorflow:loss = 11766.134, step = 501 (0.956 sec)
INFO:tensorflow:global_step/sec: 106.697
INFO:tensorflow:loss = 11509.922, step = 601 (0.938 sec)
INFO:tensorflow:global_step/sec: 118.454
INFO:tensorflow:loss = 11272.889, step = 701 (0.844 sec)
INFO:tensorflow:global_step/sec: 114.947
INFO:tensorflow:loss = 11051.9795, step = 801 (0.870 sec)
INFO:tensorflow:global_step/sec: 111.484
INFO:tensorflow:loss = 10845.855, step = 901 (0.897 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train3/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Out[8]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x18225eb8d0>
Az alábbi kóddal értékelheti modellje tesztkészlethez való illeszkedését:
results = model.evaluate(steps =None,input_fn=lambda: input_fn(df_eval, batch_size =128, num_epoch = 1))
for key in results:
print("   {}, was: {}".format(key, results[key]))
teljesítmény
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
   average_loss, was: 32.158958435058594
   loss, was: 3215.89599609375
   global_step, was: 1000
Az utolsó lépés a célpont értékének előrejelzése a jellemzőmátrix értéke alapján. Írhatsz egy szótárat a megjósolni kívánt értékekkel. A modelled kilenc jellemzővel rendelkezik, tehát mindegyikhez meg kell adnod egy értéket. A modell mindegyikhez ad egy előrejelzést.
Az alábbi kódban a df_predict CSV fájlban található egyes funkciók értékeit kell beírni.
Új input_fn függvényt kell írnod, mert nincs címke az adathalmazban. Használhatod a from_tensors API-t a Dataset objektumból.
prediction_input = {
          'crim': [0.03359,5.09017,0.12650,0.05515,8.15174,0.24522],
          'zn': [75.0,0.0,25.0,33.0,0.0,0.0],
          'indus': [2.95,18.10,5.13,2.18,18.10,9.90],
          'nox': [0.428,0.713,0.453,0.472,0.700,0.544],
          'rm': [7.024,6.297,6.762,7.236,5.390,5.782],
          'age': [15.8,91.8,43.4,41.1,98.9,71.7],
          'dis': [5.4011,2.3682,7.9809,4.0220,1.7281,4.0317],
          'tax': [252,666,284,222,666,304],
          'ptratio': [18.3,20.2,19.7,18.4,20.2,18.4]
     }
     def test_input_fn():
     dataset = tf.data.Dataset.from_tensors(prediction_input)
     return dataset

     # Predict all our prediction_input
     pred_results = model.predict(input_fn=test_input_fn)
Végül kinyomtatod az előrejelzéseket.
for pred in enumerate(pred_results):
print(pred)
teljesítmény
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
(0, {'predictions': array([32.297546], dtype=float32)})
(1, {'predictions': array([18.96125], dtype=float32)})
(2, {'predictions': array([27.270979], dtype=float32)})
(3, {'predictions': array([29.299236], dtype=float32)})
(4, {'predictions': array([16.436684], dtype=float32)})
(5, {'predictions': array([21.460876], dtype=float32)})

INFO:tensorflow:Calling model_fn. INFO:tensorflow:Done calling model_fn. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from train3/model.ckpt-5000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. (0, {'predictions': array([35.60663], dtype=float32)}) (1, {'predictions': array([22.298521], dtype=float32)}) (2, {'predictions': array([25.74533], dtype=float32)}) (3, {'predictions': array([35.126694], dtype=float32)}) (4, {'predictions': array([17.94416], dtype=float32)}) (5, {'predictions': array([22.606628], dtype=float32)})
Mindhárom folyamat ugyanazt a hat predikciót adja vissza, ami megerősíti, hogy a Pandas, a NumPy és egy natív TensorFlow adatkészlet közötti választás a kényelem, nem pedig a pontosság kérdése.
