
Mi az az adatvezérelt tesztelés?
 Thomas Hamilton
⚡ Okos összefoglaló
Az adatvezérelt tesztelés egy olyan szoftvertesztelési módszer, amely táblázatokban vagy táblázatokban tárolja a tesztadatokat, így egyetlen szkript számos bemeneti kombinációt validálhat. Elválasztja a tesztlogikát az adatoktól, csökkentve a szkriptek duplikációját és a karbantartási erőfeszítést.
Adatvezérelt tesztelés
Adatvezérelt tesztelés egy szoftvertesztelési módszer, amelyben a tesztadatokat táblázat vagy táblázat formájában tárolják. Az adatvezérelt tesztelés lehetővé teszi a tesztelők számára, hogy egyetlen tesztszkriptet vigyenek be, amely képes tesztelni egy tábla összes tesztadatát, és a tesztkimenetet ugyanabban a táblában várja. Táblázatvezérelt tesztelésnek vagy paraméterezett tesztelésnek is nevezik.
Adatvezérelt keretrendszer
Adatvezérelt keretrendszer egy automatizált tesztelési keretrendszer, amelyben a bemeneti értékeket adatfájlokból olvassák ki, és tesztszkriptek változóiban tárolják. Lehetővé teszi a tesztelők számára, hogy pozitív és negatív teszteseteket is egyetlen tesztbe építsenek. Az adatvezérelt keretrendszer bemeneti adatai egy vagy több adatforrásban, például .xls, .xml, .csv fájlokban és adatbázisokban tárolhatók. Az alábbi ábra azt mutatja, hogyan áramlanak a bemeneti értékek az adatfájlból a tesztszkriptbe.

Miért adatvezérelt tesztelés?
Adatvezérelt tesztelés fontos, mert a tesztelők gyakran több adathalmazzal rendelkeznek egyetlen teszthez, és az egyes adathalmazokhoz külön tesztek létrehozása időigényes lehet. Az adatvezérelt tesztelés segít elkülöníteni az adatokat a tesztszkriptektől, és ugyanazok a tesztszkriptek futtathatók a bemeneti tesztadatok különböző kombinációihoz, miközben a teszteredmények hatékonyan generálódnak.
Példa:
Tegyük fel, hogy a bejelentkezési rendszert több beviteli mezővel szeretnénk tesztelni 1000 különböző adathalmaz alapján.
Ennek teszteléséhez a következő különböző megközelítéseket alkalmazhatja:
1. megközelítés) Hozz létre 1000 szkriptet, minden adathalmazhoz egyet, és futtasd le az egyes teszteket külön-külön, egyesével.
2. megközelítés) Módosítsa manuálisan az értéket a tesztszkriptben, és futtassa többször.
3. megközelítés) Importálja az adatokat az Excel-táblázatból. Olvassa be a tesztadatokat az Excel soraiból egyenként, és futtassa a szkriptet.
A megadott három forgatókönyv közül az első kettő munkaigényes és időigényes. Ezért ideális a harmadik megközelítést követni.
Így a harmadik megközelítés nem más, mint egy adatvezérelt keretrendszer.
Tesztadatok típusai az adatvezérelt tesztelésben
Az adatvezérelt tesztelés értéke közvetlenül függ a tesztszkriptekbe betáplált adathalmazok minőségétől. Egy jól megtervezett adatfájl több tesztadat-kategóriát ötvöz, így egyetlen szkript egyetlen futtatásban validálhatja a normál viselkedést, a hibakezelést és a korlátokat:
- Pozitív (érvényes) adat: Helyes bemenetek, például érvényes felhasználónév és jelszó, amelyek megerősítik, hogy az alkalmazás elfogadja azt, amit el kell fogadnia.
- Negatív (érvénytelen) adat: Hibás vagy hibásan formázott bemenetek, amelyeket el kell utasítani, például helytelen jelszó vagy speciális karakterek egy numerikus mezőben.
- Határadatok: Az engedélyezett tartományok szélén lévő értékek, például egy 1 vagy 255 karakteres felhasználónév, amelyek gyakran rejtett hibákat fednek fel.
- Üres vagy null adatok: Üres mezők, amelyek a kötelező mezők érvényesítését és a hibaüzeneteket ellenőrzik.
- Nagy mennyiségű adat: Tömeges vagy véletlenszerűen generált rekordok, amelyek a teljesítmény és a stabilitás ellenőrzésére szolgálnak realisztikus terhelés mellett.
A megfelelő adatok előkészítése után a következő lépés maga a keretrendszer felépítése.
Adatvezérelt automatizálási keretrendszer létrehozása
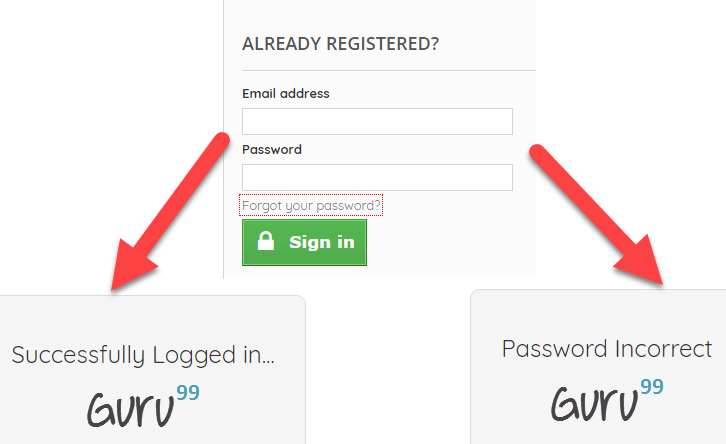
Tegyük fel, hogy egy alkalmazás bejelentkezési funkcióját szeretnéd tesztelni. A fenti folyamatábra a teljes ciklust mutatja: azonosítsd a teszteseteket, írd meg a közös tesztszkriptet, helyezd át az adatokat egy külső fájlba, és hurkold le a szkriptet minden adatsoron.
Step 1) Azonosítsa a teszteseteket
- Helyes felhasználónév és jelszó bevitele – Sikeres bejelentkezés
- Helytelen felhasználónév és jelszó beírása – Bejelentkezési hiba
- Helyes felhasználónevet és helytelen jelszót adjon meg – Bejelentkezési hiba
Step 2) Hozzon létre részletes tesztlépéseket a fenti 3 tesztesethez
| Próbaper# | Leírás | Tesztlépések | Teszt adat | Várható eredmények |
|---|---|---|---|---|
| 1 | Ellenőrizze a Bejelentkezésnél érvényes hitelesítő adatokat |
|
Felhasználónév: érvényes jelszó: érvényes | Bejelentkezés sikeres |
| 2 | Ellenőrizze a Bejelentkezést érvénytelen hitelesítő adatokért |
|
Felhasználónév: érvénytelen jelszó: érvényes | Bejelentkezési hiba |
| 3 | Ellenőrizze a Bejelentkezést érvénytelen hitelesítő adatokért |
|
Felhasználónév: érvényes jelszó: érvénytelen | Bejelentkezési hiba |
Step 3) Tesztszkript létrehozása
Ha megfigyeled, a tesztlépések mindhárom tesztesetben közösek maradnak. Létre kell hoznod egy tesztszkriptet a lépések végrehajtásához:
// This is Pseudo Code

// Test Step 1: Launch Application
driver.get("URL of the Application");

// Test Step 2: Enter Username
txtbox_username.sendKeys("valid");

// Test Step 3: Enter Password
txtbox_password.sendKeys("invalid");

// Test Step 4: Check Results
If (Next Screen) print success else Fail
Step 4) Hozz létre egy Excel/CSV fájlt a bemeneti tesztadatokkal, ahogy az az alábbi mintalapon látható.

Step 5) Módosítsa a szkriptet úgy, hogy végigfusson a bemeneti tesztadatokon. A bemeneti parancsokat is paraméterezni kell.
// This is Pseudo Code
// Loop 3 Times
for (i = 0; i & lt; = 3; i++) {
    // Read data from Excel and store into variables
    int input_1 = ReadExcel(i, 0);
    int input_2 = ReadExcel(i, 1);

    // Test Step 1: Launch Application
    driver.get("URL of the Application");

    // Test Step 2: Enter Username
    txtbox_username.sendKeys(input_1);
    // Test Step 3: Enter Password

    txtbox_password.sendKeys(input_2);
    // Test Step 4: Check Results
    If(Next Screen) print success
    else Fail
}
A fentiekben csak 3 teszteset található. A tesztszkript felhasználható a következő tesztesetek áthurkolására, csak a tesztadatok értékeinek hozzáfűzésével Excel
- Helytelen felhasználónév és jelszó bevitele – Sikertelen bejelentkezés
- Írja be a helyes felhasználónevet és jelszót üresen – Sikertelen bejelentkezés
- Írjon be üres felhasználónevet és jelszót – Sikertelen bejelentkezés
És így tovább
💡 Pro tipp: Tárold az egyes sorok várható eredményét ugyanabban az adatfájlban, mint a bemeneteket. A szkript ezután automatikusan összehasonlíthatja a tényleges és a várt eredményeket, így az adatfájl egy teljes, önmagát ellenőrző tesztkészletté alakul.
Miután a keretrendszer elkészült, a megfelelő eszköz leegyszerűsíti az adatkezelést, a végrehajtást és a jelentéskészítést.
Legjobb adatvezérelt tesztelőeszköz
1) Tesztelje a sigmát
Tesztelje a sigmát egy felhőalapú, adatvezérelt tesztelési platform, amelyet felbecsülhetetlen értékűnek találtam a tesztek lefedettségének maximalizálásában azáltal, hogy a tesztlogikát leválasztja a tesztadatokról. Kifejezetten olyan csapatok számára készült, akiknek az alkalmazásokat különféle adathalmazok, peremhelyzetek és üzleti forgatókönyvek alapján kell validálniuk redundáns tesztszkriptek létrehozása nélkül, egyszerűsítve a teljes adatvezérelt tesztelési munkafolyamatot.
Adatvezérelt tesztelési projektjeim során kihasználtam a Testsigma paraméterezési képességeit, hogy azonos tesztforgatókönyveket hajtsak végre több külső forrásból, például Excelből és CSV-fájlokból származó adatkombinációval. A platform azon képessége, hogy automatikusan végig tud lépni az adatsorokon, jelentősen kibővítette a tesztek lefedettségét, míg az adatszintű eredmények részletes jelentése segített gyorsan azonosítani, hogy mely konkrét bemeneti kombinációk okoztak hibákat a webes, mobil és API rétegekben.
Jellemzők:
- Külső adatforrás-integráció: Ez a funkció közvetlen kapcsolatot tesz lehetővé Excel-táblázatokkal, CSV-fájlokkal és adatbázis-táblákkal a központosított tesztadat-kezelés érdekében. Kiküszöböli a fixen kódolt értékeket, és lehetővé teszi a tesztadatok karbantartását a tesztlogikától függetlenül. Az adathalmazok frissíthetők a tesztszkriptek módosítása nélkül, biztosítva a rugalmasságot és a karbantarthatóságot. Ezt használom több száz adatvariáció hatékony kezelésére, miközben...ping a tesztforgatókönyvek tiszták és újrafelhasználhatók.
- Automatizált többsoros adatiteráció: A Testsigma egyetlen tesztfuttatáson belül automatikusan végrehajtja a tesztforgatókönyveket több adatsorban, jelentősen bővítve a lefedettséget. Számos bemeneti kombinációt, peremfeltételt és üzleti szabályvariációt validálhat a tesztesetek duplikálása nélkül. Ez a funkció transzparens módon kezeli az adatszekvenálást és az iterációs logikát. Ezt különösen hatékonynak találtam átfogó regressziós teszteléshez, minimális szkriptkarbantartási terheléssel.
- Dinamikus tesztlépés paraméterezése: Lehetővé teszi a statikus értékek dinamikus paraméterekkel való helyettesítését, amelyek végrehajtás közben külső forrásokból kérnek le adatokat. A tesztlépéseket úgy konfigurálhatja, hogy alkalmazkodjanak a változó bemenetekhez, feltételekhez és várható eredményekhez az adathalmaz értékei alapján. Ez a funkció támogatja az összetett adattranszformációkat és a feltételes logikát. Rugalmas tesztforgatókönyvek létrehozására támaszkodom, amelyek megfelelnek a változatos üzleti követelményeknek és felhasználói munkafolyamatoknak.
- Adatszintű végrehajtási jelentéskészítés: A platform részletes jelentéseket generál, amelyek az egyes adatkombinációkra lebontják a teszteredményeket, pontosan megmutatva, hogy mely bemenetek sikeresek és sikertelenek voltak. Elemezheti a mintákat, azonosíthatja a problémás adattartományokat, és trace hibák bizonyos adathalmaz sorokban. Ez a funkció vizuális irányítópultokat és exportálható elemzéseket biztosít az érdekelt felek kommunikációjához. Azt javaslom, hogy ezeket az információkat használják fel az adatminőség javításának rangsorolására és a tesztadat-stratégiák finomítására.
- Platformfüggetlen, adatvezérelt támogatás: A Testsigma kiterjeszti az adatvezérelt képességeket a webes, mobil és API tesztelésre egységes munkafolyamatokon belül. Ugyanazokat az adathalmazokat alkalmazhatja a különböző alkalmazásrétegek és technológiák közötti konzisztencia validálására. Ez a funkció átfogó, végponttól végpontig tartó validációt biztosít paraméterezett adatfolyamokkal. Annak ellenőrzésére használtam, hogy a háttér-adatfeldolgozás helyesen tükröződik-e a frontend interfészekben több platformon egyszerre.
Érvek
Hátrányok
Pricing:
- Ár: Egyedi árképzés adatvezérelt tesztelési képességekkel az átfogó előfizetési csomag részeként
- Ingyenes próbaverzió: 14 napos ingyenes próbaverzió
14 napos ingyenes próbaverzió
2) Testiny
Testiny egy modern, felhőalapú teszteset-kezelő platform, amelyet az adatvezérelt tesztesetek hatékony rendszerezésére használtam, miközben folyamatosanping egyértelmű elkülönítést biztosít a tesztlogika és a paraméterezett adatkészletek között. Olyan csapatok számára készült, amelyeknek sokféle tesztfutás során különféle adatkombinációkat kell kezelniük anélkül, hogy elveszítenék az tracképesség.
Adatvezérelt projektek futtatása közben TestinyÉrtékeltem, hogy a tömeges szerkesztési és sablonfunkciók hogyan tették könnyűvé a tesztvariációk skálázását több száz adatsor között. A platform integrálódik a Jira, a GitHub és a GitLab szolgáltatásaival, így a sikertelen adatkombinációk visszavezethetők a problémához. tracautomatikusan.

Jellemzők:
- Tömeges teszteset szerkesztése: Testiny lehetővé teszi számos teszteset egyidejű szerkesztését, másolását és paraméterezését, ami felgyorsítja az adatvezérelt variációk létrehozását. Másodpercek alatt alkalmazhatja a módosításokat a mappák között anélkül, hogy minden egyes esetet külön kellene megérintenie. Erre támaszkodom, amikor új adatkészletekre bővítem a lefedettséget szkriptek átírása nélkül.
- Egyéni mezők adatbevitelhez: Lehetővé teszi egyéni mezők definiálását projektenként, így az adathalmaz attribútumai tracminden tesztfuttatás mellett. A bemeneti értékeket, a várható eredményeket és a feltételeket egy helyen, világosan rögzítheti. Ezeket a mezőket használom arra, hogy az összetett paraméteres forgatókönyveket később könnyen auditálhassam.
- Valós idejű tesztfutás Tracking: A platform élőben mutatja a végrehajtás állapotát a csapattagok között, így az adatvezérelt tesztek átláthatóak maradnak. Hozzárendelhetsz eseteket, figyelheted a sikeres/sikertelen százalékokat, és azonosíthatod a blokkolt adatkombinációkat, amint azok előfordulnak. Hasznosnak találom ezt a kee számára.ping A minőségbiztosítási vezetők folyamatos állapotfelmérés nélkül is tájékozódhatnak.
- PDF és megosztható jelentéskészítés: Testiny Letisztult PDF-jelentéseket generál diagramokkal és végrehajtási összefoglalókkal, amelyeket megoszthat nem műszaki érdekelt felekkel. Szűrhet adatkészlet, mérföldkő vagy kiadás szerint. Ezeket minden sprint végén elküldöm a minőségi pozíció kommunikálása érdekében.
- Natív probléma Tracker integrációk: Csatlakozik a Jira-hoz, a GitHub-hoz, a GitLab-hoz, Azure DevOps, Lineáris, Asana, a Confluence, a Trello és a monday.com, így a sikertelen adatsorok gyorsan ticketekké alakulnak. Összehangolva tarthatja a tesztek végrehajtását és a mérnöki munkafolyamatokat. Azt vettem észre, hogy ez drámaian csökkenti az átadási súrlódást a minőségbiztosítási és a fejlesztői csapatok között.
Érvek
Hátrányok
Pricing:
- Ár: Ingyenes csomag akár 3 felhasználó számára; a fizetős csomagok a munkaállomások szerint skálázhatók és prémium támogatást is biztosítanak.
- Ingyenes próbaverzió: 21 napos ingyenes próbaverzió
21 napos ingyenes próbaverzió
3) Testpad
Testpad egy könnyűsúlyú, ellenőrzőlistán alapuló tesztkezelő eszköz, amelyre akkor támaszkodtam, amikor az adatvezérelt forgatókönyvekhez gyors, nehézkes rögzítésre volt szükség. Hierarchikus ellenőrzőlistákra épül, így a tesztelők az adatvariációkat szülő esetek alá csoportosíthatják, és gyorsan végrehajthatják azokat.
Az adatvezérelt munkameneteim során TestpadA billentyűzet-központú felületét használtam, hogy egyetlen ülés alatt több tucat beviteli variációt próbáljak ki. A vendégtesztelői támogatás lehetővé tette, hogy domainszakértőket vonjak be a szélsőséges adatkombinációk validálására anélkül, hogy extra munkaállomásokért fizettem volna.
Jellemzők:
- Hierarchikus tesztlisták: Testpad A paraméteres teszteket beágyazott ellenőrzőlistákba rendezi, így a kapcsolódó adatvariációkat egyetlen szülő eset alá csoportosíthatja. Az ágakat kibonthatja és összecsukhatja, hogy adott adatkészletekre összpontosítson. Ezt használom az összetett adatmátrixok vizuális rendezettségének megőrzésére.
- Billentyűzetvezérelt szerkesztés: Lehetővé teszi a tesztelemek létrehozását, behúzását és átrendezését billentyűparancsokkal, így a nagyméretű, adatvezérelt tervek felépítése gyors. Folyamatosan haladhatsz anélkül, hogy az egérhez nyúlnál. Úgy vélem, hogy ez drámaian lerövidíti az új adathalmaz sorainak rögzítéséhez szükséges időt.
- Vendég tesztelői hozzáférés: Testpad korlátlan számú vendégtesztelőt támogat munkaállomásonkénti díjak nélkül, így domain szakértőket vonhatsz be adott adatkombinációkhoz. Meghívhatsz érdekelt feleket, hogy licencelési többletköltségek nélkül ellenőrizzék a peremhálózati eseteket. Erre támaszkodom a paraméteres forgatókönyvek felhasználói elfogadása során.
- Azonnal megosztható jelentések: A platform könnyűsúlyú jelentéseket generál, amelyeket linken keresztül megoszthatsz, így a haladás látható az eszköz megnyitása nélkül. Szűrhetsz tesztelő, állapot vagy tesztág szerint. Ezeket minden adatvezérelt tesztfuttatás végén elküldöm a termékmenedzsereknek.
- Kiadás Tracker Linkelés: Egyszerű linkeken keresztül köti össze a sikertelen teszteket a Jira vagy GitHub jegyekkel, így az adatsorok hibái gyorsan a mérnöki csapathoz kerülnek. Közvetlenül egy sikertelen ellenőrzőlistaelemből csatolhatsz kontextust. A tesztelők figyelmét a végrehajtásra bízom, miközben az eszközök kezelik az útvonalat.
Érvek
Hátrányok
Pricing:
- Ár: A csomagok havi 59 dollártól kezdődnek, nagyobb csapatok számára pedig egyedi vállalati csomagok is elérhetők.
- Ingyenes próbaverzió: 30 napos ingyenes próba
30 napos ingyenes próbaverzió
Az adatvezérelt tesztelés legjobb gyakorlatai
Az alábbiakban bemutatjuk az adatvezérelt tesztelés legjobb tesztelési gyakorlatait:
- Ideális reális információk felhasználása az adatvezérelt tesztelési folyamat során
- A tesztfolyamat-navigációt a tesztszkripten belül kell kódolni
- Vezessen virtuális API-kat értelmes adatokkal
- Adatok használata dinamikus állítások előmozdítására
- Teszteljen pozitív és negatív eredményeket
- Az adatvezérelt funkcionális tesztek újrahasznosítása a biztonság és a teljesítmény érdekében
Az adatvezérelt tesztelés előnyei
Az adatvezérelt tesztelés számos előnnyel jár. Néhány ezek közül:
- Lehetővé teszi az alkalmazás tesztelését több adatérték-készlettel a folyamat során Regressziós teszt
- A tesztadatok és az ellenőrzési adatok egyetlen fájlba rendezhetők, és ez elkülönül a teszteset logikájától.
- Az eszköz segítségével a tesztszkriptek egyetlen adattárban tárolhatók. Ezáltal a tesztek könnyen érthetők, karbantarthatók és kezelhetők.
- A műveletek és funkciók újra felhasználhatók különböző tesztekben.
- Néhány eszköz automatikusan generál tesztadatokat. Ez akkor hasznos, ha nagy mennyiségű véletlenszerű tesztadatra van szükség, ami időt takarít meg.
- Az adatvezérelt tesztelés a fejlesztés bármely fázisában elvégezhető. Az adatvezérelt teszteseteket általában egyetlen folyamatba vonják össze. Azonban több tesztesetben is használhatók.
- Lehetővé teszi a fejlesztők és a tesztelők számára, hogy egyértelműen elkülönítsék a tesztesetek/szkriptek logikáját a tesztadatoktól.
- Ugyanazok a tesztesetek többször is végrehajthatók, ami segít csökkenteni a tesztesetek és szkriptek számát.
- A teszt szkriptben végrehajtott változtatások nem befolyásolják a tesztadatokat.
Az adatvezérelt tesztelés hátrányai
Az adatvezérelt automatizálási tesztelési módszer néhány hátránya:
- A teszt minősége a megvalósító csapat automatizálási készségeitől függ.
- Az adatvalidáció időigényes feladat nagy mennyiségű adat tesztelésekor.
- A karbantartás nagy probléma, mivel az adatvezérelt teszteléshez nagy mennyiségű kódolásra van szükség.
- Magas szintű műszaki ismeretek szükségesek. Lehet, hogy egy tesztelőnek egy teljesen új szkriptnyelvet kell megtanulnia.
- További dokumentáció lesz, főként a szkriptkezeléssel, a tesztinfrastruktúrával és a tesztelési eredményekkel kapcsolatban.
- Az adatfájlok létrehozásához és karbantartásához olyan szövegszerkesztőre van szükség, mint a Jegyzettömb.
Adatvezérelt tesztelés vs. kulcsszóvezérelt tesztelés
A kezdők gyakran összekeverik az adatvezérelt tesztelést a kulcsszóvezérelt teszteléssel, mivel mindkettő elválasztja a teszttervezést a tesztszkriptektől. A különbség abban rejlik, hogy mit externalizálnak: az adatvezérelt tesztelés a bemeneti értékeket externalizálja, míg a kulcsszóvezérelt tesztelés magukat a műveleteket újrafelhasználható kulcsszavakként használja fel. Az alábbi táblázat összehasonlítja a két megközelítést:
| Vizsgált paraméter | Adatvezérelt tesztelés | Kulcsszóvezérelt tesztelés |
|---|---|---|
| Mi a külsőleg alkalmazott | Tesztadatok (bemenetek és várható eredmények) | Tesztelési műveletek (kulcsszavak, például Bejelentkezés, Kattintás, Ellenőrzés) |
| Adatforrás | Excel, CSV, XML vagy adatbázistáblák | Kulcsszótáblázatok és opcionális adattáblázatok |
| Szükséges készségek | Mérsékelt szkriptelési ismeretek | Nagyobb kezdeti tervezési erőfeszítés; kevesebb kódolás új tesztek létrehozásához |
| Legmegfelelőbb | Egy forgatókönyv ismétlése sok bemeneti kombinációval | Több forgatókönyv felépítése újrafelhasználható akcióblokkokból |
| Karbantartás | Adatfájlok frissítése szkriptek érintése nélkül | Kulcsszótár frissítése az alkalmazás viselkedésének megváltozásakor |
Sok csapat ötvözi mindkét megközelítést egy hibrid keretrendszerben, ahol a kulcsszavak határozzák meg az újrafelhasználható műveleteket, és a külső adatfájlok biztosítják az értékeket minden egyes tesztfuttatáshoz.
