
Strojno učenje bez nadzora: Algorithms, Vrste i primjer
 Uredništvo
⚡ Pametni sažetak
Nenadzirano učenje je tehnika strojnog učenja koja radi na neoznačenim podacima, omogućujući modelu da samostalno otkrije strukturu putem klasteriranja, pravila povezivanja i smanjenja dimenzionalnosti, umjesto na temelju unaprijed danih odgovora.
Što je učenje bez nadzora?
Nenadzirano učenje je tehnika strojnog učenja u kojoj korisnik ne mora nadzirati model. Umjesto toga, omogućuje modelu da samostalno otkriva obrasce i informacije koje prethodno nisu bile otkrivene. Uglavnom se bavi neoznačenim podacima.
Učenje bez nadzora Algorithms
Učenje bez nadzora Algorithms omogućuju korisnicima obavljanje složenijih zadataka obrade u usporedbi s nadzirano učenjeMeđutim, nenadzirano učenje može biti nepredvidljivije od metoda obučenih na poznatim odgovorima. Algoritmi nenadziranog učenja uključuju klasteriranje, otkrivanje anomalija, smanjenje dimenzionalnosti i samoorganizirajuće neuronske mreže.
Primjer nenadziranog strojnog učenja
Uzmimo primjer nenadziranog učenja za bebu i njezinog obiteljskog psa. Prva slika prikazuje ljubimca kojeg beba već prepoznaje.
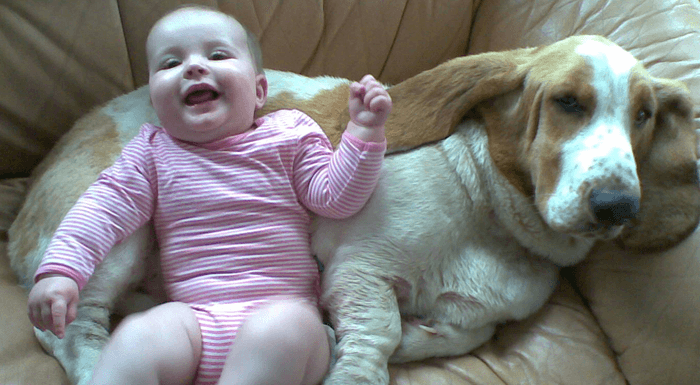
Ona poznaje i identificira ovog psa. Nekoliko tjedana kasnije, obiteljski prijatelj dovodi psa i pokušava se igrati s bebom. Taj drugi, nepoznati pas prikazan je dolje.
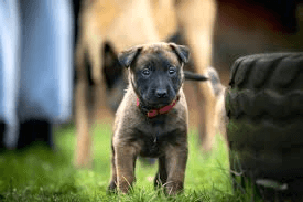
Beba prije nije vidjela ovog psa. Ali prepoznaje da su mnoge značajke (2 uha, oči, hodanje na 4 noge) slične njezinom psu. Novu životinju identificira kao psa. Ovo je učenje bez nadzora, gdje vas se ne uči, već učite iz podataka (u ovom slučaju podataka o psu). Da je ovo bilo učenje bez nadzora, obiteljski prijatelj bi rekao bebi da je to pas, kao što je prikazano u gornjem primjeru učenja bez nadzora.
Zašto učenje bez nadzora?
Evo glavnih razloga za korištenje nenadziranog učenja u Strojno učenje:
- Nenadzirano strojno učenje pronalazi sve vrste nepoznatih obrazaca u podacima.
- Nenadzirane metode pomažu vam pronaći značajke koje mogu biti korisne za kategorizaciju.
- Može se izvršavati na podacima kako pristižu, tako da se dolazni zapisi analiziraju i grupiraju bez čekanja da ih čovjek prvo označi.
- Lakše je dobiti neoznačene podatke s računala nego označene podatke, koji zahtijevaju ručnu intervenciju.
Clustering Vrste nenadziranog učenja Algorithms
Problemi nenadziranog učenja dalje se grupiraju u probleme klasteriranja, asocijacije i redukcije dimenzionalnosti. ClusterGrupiranjem sličnih zapisa, povezivanjem se pronalaze stavke koje se pojavljuju zajedno, a smanjenjem dimenzionalnosti se mnoge značajke sažimaju u nekoliko njih.
Clustering.
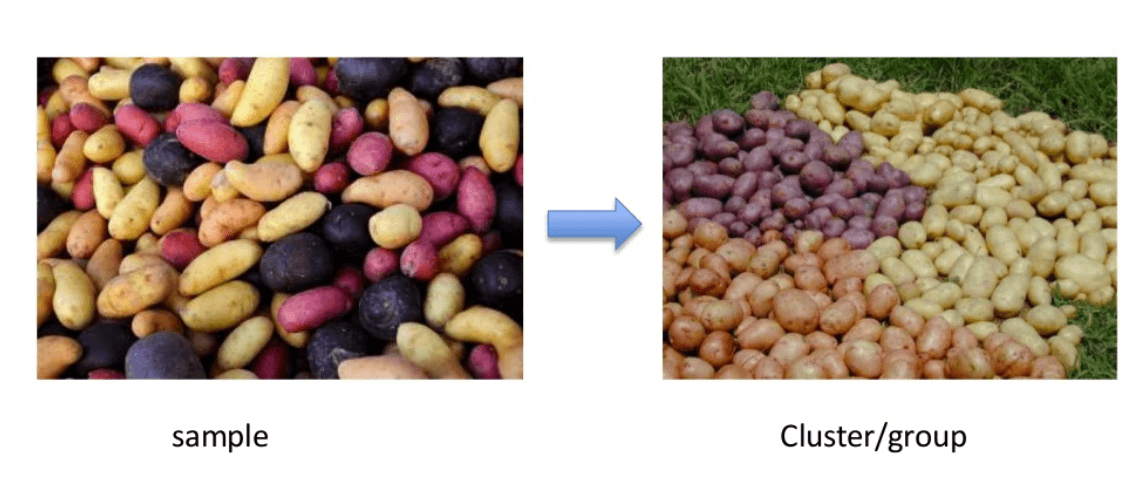
Clustering je važan koncept kada je u pitanju učenje bez nadzora. Uglavnom se bavi pronalaženjem strukture ili uzorka u zbirci nekategoriziranih podataka. Učenje bez nadzora ClusterAlgoritmi za obradu podataka obradit će vaše podatke i pronaći prirodne klastere (grupe) ako postoje u podacima. Također možete izmijeniti koliko klastera vaši algoritmi trebaju identificirati. To vam omogućuje podešavanje granulacije tih grupa. Dijagram u nastavku prikazuje raspršene zapise razvrstane u zasebne grupe.
Postoje različite vrste klasteriranja koje možete koristiti:
Ekskluzivno (particioniranje)
U ovoj metodi klasteriranja, podaci su grupirani na takav način da jedan zapis može pripadati samo jednom klasteru.
Primjer: K-znači
Aglomerativni
U ovoj tehnici klasteriranja, svaki zapis započinje kao vlastiti klaster. Iterativne unije između dva najbliža klastera smanjuju broj klastera.
Primjer: Hijerarhijsko grupiranje
Preklapanjeping
U ovoj tehnici, nejasni skupovi koriste se za klasteriranje podataka. Svaka točka može pripadati dvama ili više klastera s odvojenim stupnjevima pripadnosti.
Ovdje će podaci biti povezani s odgovarajućom vrijednošću članstva. Primjer: neizrazita C-srednja vrijednost
Vjerojatnosni
Ova tehnika koristi raspodjelu vjerojatnosti za stvaranje klastera.
Primjer: Sljedeće ključne riječi
- “muška cipela.”
- “ženska cipela.”
- “ženska rukavica.”
- “muška rukavica.”
mogu se svrstati u dvije kategorije, „cipela“ i „rukavica“ ili „muškarac“ i „žene“.
Clustering Vrste
Slijede algoritmi koji se najčešće susreću u nenadziranom strojnom učenju. Prva dva grupiraju zapise, posljednja tri smanjuju dimenzije umjesto da formiraju klastere, a K-NN je naveden jer se često miješa s K-means.
- Hijerarhijsko grupiranje — grupiranje
- K-znači klasteriranje — klasteriranje
- K-NN (k najbližih susjeda) — nadzirani klasifikator, a ne metoda klasteriranja
- Analiza glavnih komponenti — smanjenje dimenzionalnosti
- Dekompozicija singularne vrijednosti — smanjenje dimenzionalnosti
- Analiza neovisnih komponenti — smanjenje dimenzionalnosti
hijerarhijski Clustering.
Hijerarhijsko klasteriranje je algoritam koji gradi hijerarhiju klastera. Počinje sa svim podacima dodijeljenim zasebnom klasteru. Ovdje će se dva bliska klastera spojiti u isti klaster. Ovaj algoritam završava kada ostane samo jedan klaster. Definira dvije ideje koje vrijedi imenovati zasebno.
Aglomerativno grupiranje
Ovaj oblik hijerarhijskog grupiranja odozdo prema gore ne zahtijeva broj klastera K kao ulaz. Proces aglomeracije započinje formiranjem svakog zapisa kao jednog klastera.
Ova metoda koristi određenu mjeru udaljenosti i smanjuje broj klastera (jedan u svakoj iteraciji) procesom spajanja. Konačno, imamo jedan veliki klaster koji sadrži sve objekte, a analitičar reže stablo na visini koja daje razuman broj grupa.
Dendrogram
U metodi klasteriranja Dendrogramom, svaka razina predstavljat će mogući klaster. Visina dendrograma pokazuje razinu sličnosti između dva spojena klastera. Što su bliže dnu procesa, to su klasteri sličniji; odabir reza koji definira konačne skupine nije automatski i uglavnom je subjektivan.
K-znači Clustering.
K-means je iterativni algoritam klasteriranja koji pročišćava grupuping u svakoj iteraciji. U početku se odabire željeni broj klastera. U ovoj metodi klasteriranja potrebno je klasterirati podatkovne točke u k grupa. Veći k znači manje grupe s većom granulacijom; niži k znači veće grupe s manjom granulacijom.
Izlaz algoritma je skupina „oznaka“. Svaku podatkovnu točku dodjeljuje jednoj od k skupina. U k-means grupiranju, svaka se skupina definira stvaranjem centroida za tu skupinu. Centroidi su poput srca klastera, koje hvata točke najbliže njima i dodaje ih klasteru.
K- Najbliži susjedi
K-najbliži susjed je najjednostavniji od svih klasifikatora strojnog učenja. Razlikuje se od drugih tehnika strojnog učenja po tome što ne stvara model. To je jednostavan algoritam koji pohranjuje sve dostupne slučajeve i klasificira nove instance na temelju mjere sličnosti. Budući da su mu potrebni označeni slučajevi za klasifikaciju, K-NN je nadzirana metoda; ovdje se pojavljuje samo zato što njegova logika temeljena na udaljenosti nalikuje klasteriranju.
Vrlo dobro funkcionira kada postoji značajna udaljenost između primjera. Brzina učenja je spora kada je skup za učenje velik, a izračun udaljenosti nije trivijalan.
Analiza glavnih komponenti
Analiza glavnih komponenti uzima visokodimenzionalni prostor i odabire novu bazu, tj.ping samo njegove najvažnije vrijednosti. Svaki smjer u ovoj bazi poznat je kao glavna komponenta. Podskup koji zadržavate predstavlja novi prostor koji je male veličine u usporedbi s izvornim prostorom. Zadržava što je moguće veću složenost podataka.
Udruženje
Pravila povezivanja omogućuju vam uspostavljanje poveznica među podatkovnim objektima unutar velikih baza podataka. Ova nenadzirana tehnika odnosi se na otkrivanje zanimljivih odnosa između varijabli u velikim bazama podataka i osnovna je data miningNa primjer, ljudi koji kupuju novi dom najvjerojatnije će kupiti novi namještaj.
Ostali primjeri:
- Podskupina pacijenata oboljelih od raka grupiranih prema mjerenjima genske ekspresije
- Grupe kupaca na temelju njihove povijesti pregledavanja i kupnje
- Filmovi grupirani prema ocjenama gledatelja
Nadzirano naspram nenadziranog strojnog učenja
Ovdje je glavna razlika između Nadzirano u odnosu na nenadzirano učenje:
| Parametri | Tehnika strojnog učenja pod nadzorom | Tehnika strojnog učenja bez nadzora |
| Ulazni podaci | Algorithms obučeni su pomoću označenih podataka. | Algorithms koriste se protiv podataka koji nisu označeni |
| Računalna složenost | Učenje pod nadzorom je jednostavnija metoda. | Učenje bez nadzora računalno je složeno |
| Točnost | Točnost se može mjeriti izravno u odnosu na poznate oznake. | Točnost se ne može izravno mjeriti; rezultate je potrebno interpretirati |
| Tipični izlaz | Predviđanje za svaki novi rekord | Grupe, pravila ili komprimirane značajke |
Primjene nenadziranog strojnog učenja
Neke primjene tehnika nenadziranog učenja su:
- Clustering automatski dijeli skup podataka u grupe na temelju njihovih sličnosti
- Otkrivanje anomalija može otkriti neobične podatkovne točke u vašem skupu podataka. Korisno je za pronalaženje lažnih transakcija
- Asocijacijsko rudarenje identificira skupove stavki koje se često pojavljuju zajedno u vašem skupu podataka
- Modeli latentnih varijabli široko se koriste za predobradu podataka, kao što je smanjenje broja značajki u skupu podataka ili dekompozicija skupa podataka na više komponenti.
Nedostaci nenadziranog učenja
- Ne možete dobiti precizne informacije o sortiranju podataka, jer podaci korišteni u nenadziranom učenju nisu označeni i njihova prava grupaping nije poznato
- Less točnost rezultata, jer ulazni podaci nisu poznati i nisu unaprijed označeni od strane ljudi. To znači da stroj to mora sam učiniti.
- Spektralne klase ne odgovaraju uvijek informativnim klasama.
- Korisnik treba utrošiti vrijeme na tumačenje i označavanje klasa koje proizlaze iz klasifikacije.
- Spektralna svojstva klasa također se mogu mijenjati s vremenom, tako da ne možete zadržati iste informacije o klasi prilikom prelaska s jedne slike na drugu.
