
PyTorch Vodič za učenje transfera s primjerima
 Uredništvo
⚡ Pametni sažetak
Transfer Learning ponovno koristi mrežu koja je već obučena na velikom skupu podataka tako da se novi, povezani zadatak može riješiti s puno manje označenih slika i djelićem izvornog vremena obuke.
Što je transferno učenje?
Prijenos učenja je tehnika korištenja obučenog modela za rješavanje drugog povezanog zadatka. To je Strojno učenje istraživačka metoda koja pohranjuje znanje stečeno rješavanjem određenog problema i koristi isto znanje za rješavanje drugog, različitog, ali povezanog problema. To poboljšava učinkovitost ponovnom upotrebom informacija prikupljenih iz prethodno naučenog zadatka.
Popularno je ponovno koristiti težine drugog mrežnog modela jer treniranje mreže od nule zahtijeva vrlo veliku količinu podataka. Kako biste smanjili vrijeme treniranja, uzimate postojeću mrežu i njezine težine te modificirate posljednji sloj kako biste riješili vlastiti problem. Prednost je što se ovaj posljednji sloj može trenirati s malim skupom podataka.
Prije pisanja bilo kojeg Py-aTorch koda, korisno je znati kojoj obitelji Transfer Learninga pripada vaš problem, jer to određuje koliko označenih podataka vam je potrebno.
Vrste transfernog učenja
Istraživačka literatura dijeli tehniku u tri obitelji. Koja se odnosi na vas ovisi o tome koja strana problema nosi oznake, a ne o okviru koji koristite.
| Tip | Izvorna domena | Target domena | Tipična upotreba |
|---|---|---|---|
| induktivan | Označen | Označeno, ali drugačiji zadatak | Preusmjeravanje ImageNetove okosnice na problem dvoklasne igre Alien protiv Predatora |
| Transduktivni | Označen | Neoznačeno, isti zadatak, različita distribucija podataka | Prilagodba domene, kao što je premještanje modela sa studijskih fotografija na telefonske fotografije |
| bez nadzora | Neoznačeno | Neoznačeno | Clustersmanjenje dimenzionalnosti gdje je označavanje svakog zapisa nepraktično |
Primjer izgrađen u ovom tutorialu je induktivno transferno učenje. VGG19 dolazi s označenim ImageNet znanjem, a zatim je usmjeren na označeni problem s dvije klase koji nikada prije nije vidio.
Značajka Extraccija u odnosu na fino podešavanje
Nakon što je odabrana prethodno obučena mreža, postoje dva načina za njezino prilagođavanje. Razlika je jednostavno u tome koliko slojeva dopuštate za nastavak učenja.
| Aspekt | Značajka extracANJE | Fino podešavanje |
|---|---|---|
| Slojevi koji treniraju | Samo zamijenjeni klasifikator | Klasifikator plus neki ili svi konvolucijski blokovi |
| requires_grad na glavnoj mreži | Lažan | Vrijedi za blokove koji se ažuriraju |
| Potrebni podaci | Male, često nekoliko stotina slika po razredu | Veće, obično tisuće |
| Trošak obuke | Najniži, radi na CPU-u | Što je više moguće, to se isplati imati GPU |
| Tipična točnost | Dobro je kada izvorna i ciljna slika izgledaju slično | Obično je bolje kada se dvije domene razlikuju |
Koraci u nastavku koriste značajku extraccija: svaki VGG19 parametar je zamrznut i uči samo novi konačni linearni sloj. Prelazak na fino podešavanje je mala promjena, naime ostavljanje requires_grad postavljenog na True na blokovima koje želite ažurirati i smanjenje brzine učenja kako se posuđene težine ne bi uništile.
Učitavanje skupa podataka
Prije nego što počnete koristiti Transfer Learning with PyTorch, morate razumjeti skup podataka koji ćete koristiti. U ovom Transfer Learning PyTorNa primjer, klasificirat ćete izvanzemaljca i predatora iz gotovo 700 slika. Za ovu tehniku vam zapravo ne treba velika količina podataka za treniranje. Skup podataka možete preuzeti s Kaggle: Alien protiv Predatora.
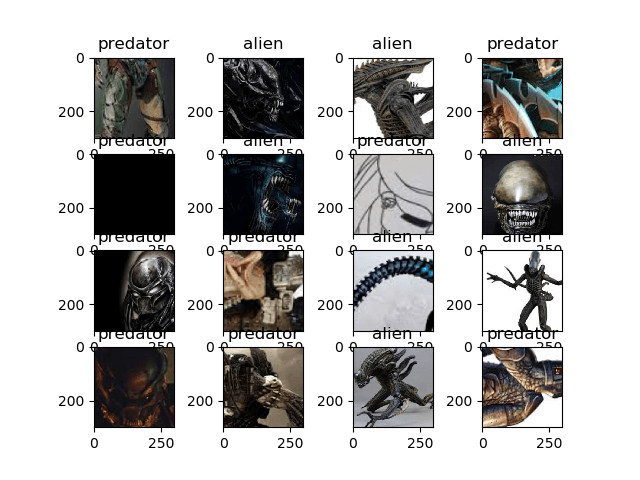
Kolekcija je namjerno mala, a uzorak slika koje sadrži prikazan je u nastavku.

Izvor: Alien vs. grabljivica Kaggle
Sljedeće u ovom Py-uTorU tutorijalu o Transfer Learningu, naučit ćete kako primijeniti Transfer Learning s Py-jem.Torkorak po korak.
Kako koristiti prijenos učenja?
Evo korak-po-korak postupka o tome kako koristiti transferno učenje za duboko učenje s Py-jemTorCH:
Korak 1) Učitajte podatke
Prvi korak je učitavanje podataka i primjena nekih transformacija na slike kako bi odgovarale zahtjevima mreže.
Podatke ćete učitati iz mape s torchvision.datasets. Modul iterira kroz mapu kako bi podijelio podatke u skupove za učenje i validaciju. Ovdje korišteni cjevovod transformacije izrezuje slike od središta, pretvara ih u tenzor i normalizira ih za Duboko učenje.
from __future__ import print_function, division
import os
import time
import torch
import torchvision
from torchvision import datasets, models, transforms
import torch.optim as optim
import numpy as np
import matplotlib.pyplot as plt

data_dir = "alien_pred"
input_shape = 224
mean = [0.5, 0.5, 0.5]
std = [0.5, 0.5, 0.5]

#data transformation
data_transforms = {
   'train': transforms.Compose([
       transforms.CenterCrop(input_shape),
       transforms.ToTensor(),
       transforms.Normalize(mean, std)
   ]),
   'validation': transforms.Compose([
       transforms.CenterCrop(input_shape),
       transforms.ToTensor(),
       transforms.Normalize(mean, std)
   ]),
}

image_datasets = {
   x: datasets.ImageFolder(
       os.path.join(data_dir, x),
       transform=data_transforms[x]
   )
   for x in ['train', 'validation']
}

dataloaders = {
   x: torch.utils.data.DataLoader(
       image_datasets[x], batch_size=32,
       shuffle=True, num_workers=4
   )
   for x in ['train', 'validation']
}

dataset_sizes = {x: len(image_datasets[x]) for x in ['train', 'validation']}

print(dataset_sizes)
class_names = image_datasets['train'].classes

device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
Sada vizualizirajte skup podataka. Korak vizualizacije uzima sljedeću seriju slika i oznaka iz programa za učitavanje podataka za učenje i prikazuje ih pomoću Matplotliba.
images, labels = next(iter(dataloaders['train']))

rows = 4
columns = 4
fig=plt.figure()
for i in range(16):
   fig.add_subplot(rows, columns, i+1)
   plt.title(class_names[labels[i]])
   img = images[i].numpy().transpose((1, 2, 0))
   img = std * img + mean
   plt.imshow(img)
plt.show()
Pokretanjem tog isječka crta se mreža slika za učenje dimenzija četiri puta četiri, a svaka je naslovljena nazivom klase koji je vratio program za učitavanje.
Korak 2) Definirajte model
U ovom procesu dubokog učenja koristit ćete VGG19 iz modula torchvision.
Koristit ćete torchvision.models za učitavanje vgg19 s omogućenim prethodno obučenim težinama. Nakon toga, zamrzavate slojeve tako da se ne mogu obučavati. Zatim modificirate posljednji sloj linearnim slojem koji odgovara problemu, što ovdje znači 2 klase. CrossEntropyLoss se koristi kao funkcija gubitka, a optimizator je SGD sa stopom učenja od 0.001 i momentom od 0.9, kao što je prikazano na donjem Py dijagramu.TorPrimjer transfera učenja.
## Load the model based on VGG19
vgg_based = torchvision.models.vgg19(pretrained=True)

## freeze the layers
for param in vgg_based.parameters():
   param.requires_grad = False

# Modify the last layer
number_features = vgg_based.classifier[6].in_features
features = list(vgg_based.classifier.children())[:-1] # Remove last layer
features.extend([torch.nn.Linear(number_features, len(class_names))])
vgg_based.classifier = torch.nn.Sequential(*features)

vgg_based = vgg_based.to(device)

print(vgg_based)

criterion = torch.nn.CrossEntropyLoss()
optimizer_ft = optim.SGD(vgg_based.parameters(), lr=0.001, momentum=0.9)
Napomena o verziji: o prethodno obučeno=Istina argument još uvijek radi, ali je od verzije torchvision 0.13 zamijenjen Utezi argument, pa novije instalacije očekuju torchvision.models.vgg19(težine=VGG19_Težine.ZADANO) i ispisati upozorenje o zastarivanju u suprotnom. Oba obrasca učitavaju iste ImageNet težine.
Struktura izlaznog modela
Ispis modela vraća cijeli VGG19 graf. Pročitajte zadnji redak klasifikatorskog bloka kako biste potvrdili da je zamjena uspjela: sada proizvodi 2 izlaza umjesto 1,000 ImageNet klasa.
VGG(
  (features): Sequential(
	(0): Conv2d(3, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(1): ReLU(inplace)
	(2): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(3): ReLU(inplace)
	(4): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(5): Conv2d(64, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(6): ReLU(inplace)
	(7): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(8): ReLU(inplace)
	(9): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(10): Conv2d(128, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(11): ReLU(inplace)
	(12): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(13): ReLU(inplace)
	(14): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(15): ReLU(inplace)
	(16): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(17): ReLU(inplace)
	(18): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(19): Conv2d(256, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(20): ReLU(inplace)
	(21): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(22): ReLU(inplace)
	(23): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(24): ReLU(inplace)
	(25): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(26): ReLU(inplace)
	(27): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(28): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(29): ReLU(inplace)
	(30): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(31): ReLU(inplace)
	(32): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(33): ReLU(inplace)
	(34): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(35): ReLU(inplace)
	(36): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  )
  (classifier): Sequential(
	(0): Linear(in_features=25088, out_features=4096, bias=True)
	(1): ReLU(inplace)
	(2): Dropout(p=0.5)
	(3): Linear(in_features=4096, out_features=4096, bias=True)
	(4): ReLU(inplace)
	(5): Dropout(p=0.5)
	(6): Linear(in_features=4096, out_features=2, bias=True)
  )
)
Korak 3) Obuka i testiranje modela
Koristit ćemo neke od funkcija iz ovoga PyTorch Vodič da nam pomognu u obuci i procjeni našeg modela.
def train_model(model, criterion, optimizer, num_epochs=25):
   since = time.time()

   for epoch in range(num_epochs):
       print('Epoch {}/{}'.format(epoch, num_epochs - 1))
       print('-' * 10)

       #set model to trainable
       # model.train()

       train_loss = 0

       # Iterate over data.
       for i, data in enumerate(dataloaders['train']):
           inputs , labels = data
           inputs = inputs.to(device)
           labels = labels.to(device)

           optimizer.zero_grad()

           with torch.set_grad_enabled(True):
               outputs  = model(inputs)
               loss = criterion(outputs, labels)

           loss.backward()
           optimizer.step()

           train_loss += loss.item() * inputs.size(0)

           print('{} Loss: {:.4f}'.format(
               'train', train_loss / dataset_sizes['train']))

   time_elapsed = time.time() - since
   print('Training complete in {:.0f}m {:.0f}s'.format(
       time_elapsed // 60, time_elapsed % 60))

   return model

def visualize_model(model, num_images=6):
   was_training = model.training
   model.eval()
   images_so_far = 0
   fig = plt.figure()

   with torch.no_grad():
       for i, (inputs, labels) in enumerate(dataloaders['validation']):
           inputs = inputs.to(device)
           labels = labels.to(device)

           outputs = model(inputs)
           _, preds = torch.max(outputs, 1)

           for j in range(inputs.size()[0]):
               images_so_far += 1
               ax = plt.subplot(num_images//2, 2, images_so_far)
               ax.axis('off')
               ax.set_title('predicted: {} truth: {}'.format(class_names[preds[j]], class_names[labels[j]]))
               img = inputs.cpu().data[j].numpy().transpose((1, 2, 0))
               img = std * img + mean
               ax.imshow(img)

               if images_so_far == num_images:
                   model.train(mode=was_training)
                   return
       model.train(mode=was_training)
Konačno u ovom transferu učenja u Py-uTorNa primjer, započnite proces treniranja s brojem epoha postavljenim na 25 i nakon toga procijenite mrežu. U svakom koraku treniranja model uzima ulaz i predviđa izlaz. Predviđanje se prosljeđuje kriteriju za izračun gubitka, povratno širenje izračunava gradijente, a optimizator ažurira težine s autogradom.
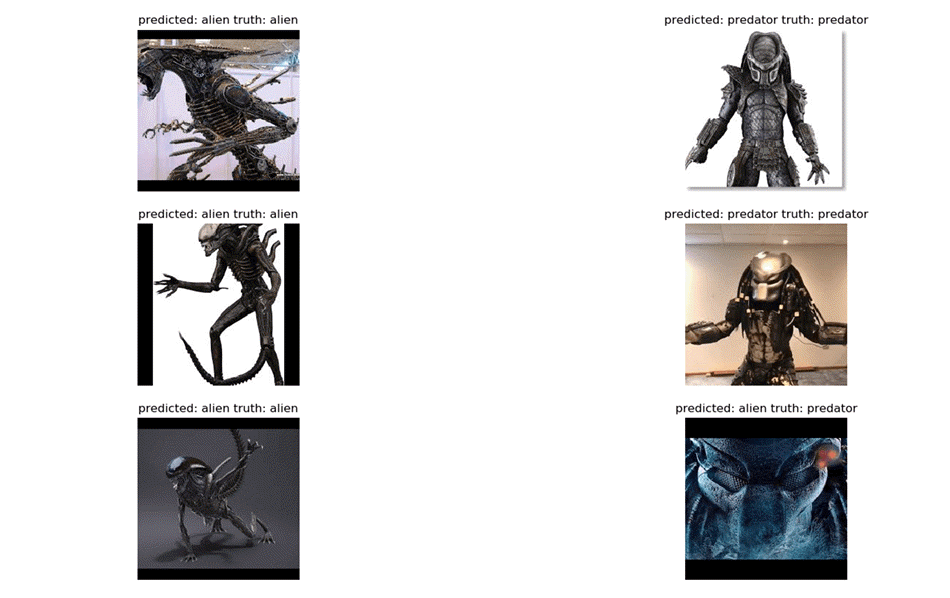
U funkciji vizualizacije, obučena mreža se testira s nizom slika kako bi se predvidjele oznake, a rezultat se crta pomoću Matplotliba.
vgg_based = train_model(vgg_based, criterion, optimizer_ft, num_epochs=25)

visualize_model(vgg_based)

plt.show()
Korak 4) Rezultati
Prijavljena točnost za ovaj trening je 92%. Zapisnik ispisan na kraju treninga prikazuje gubitak trčanja za posljednje dvije epohe zajedno s ukupnim vremenom treninga.
Epoch 23/24
----------
train Loss: 0.0044
train Loss: 0.0078
train Loss: 0.0141
train Loss: 0.0221
train Loss: 0.0306
train Loss: 0.0336
train Loss: 0.0442
train Loss: 0.0482
train Loss: 0.0557
train Loss: 0.0643
train Loss: 0.0763
train Loss: 0.0779
train Loss: 0.0843
train Loss: 0.0910
train Loss: 0.0990
train Loss: 0.1063
train Loss: 0.1133
train Loss: 0.1220
train Loss: 0.1344
train Loss: 0.1382
train Loss: 0.1429
train Loss: 0.1500
Epoch 24/24
----------
train Loss: 0.0076
train Loss: 0.0115
train Loss: 0.0185
train Loss: 0.0277
train Loss: 0.0345
train Loss: 0.0420
train Loss: 0.0450
train Loss: 0.0490
train Loss: 0.0644
train Loss: 0.0755
train Loss: 0.0813
train Loss: 0.0868
train Loss: 0.0916
train Loss: 0.0980
train Loss: 0.1008
train Loss: 0.1101
train Loss: 0.1176
train Loss: 0.1282
train Loss: 0.1323
train Loss: 0.1397
train Loss: 0.1436
train Loss: 0.1467
Training complete in 2m 47s
Predviđanja modela se zatim vizualiziraju pomoću Matplotliba, kao što je prikazano dolje.
Uobičajene pogreške u učenju transfera i kako ih ispraviti
Većina kvarova u skripti za prijenos učenja je mehanička, a ne matematička. To su oni koji sprječavaju izvođenje gornjeg koda i što svaki od njih znači.
- Neusklađenost veličine u završnom sloju: Zamijenjeni linearni sloj mora prihvatiti in_features koje je prijavio izvorni klasifikator i emitirati točno len(class_names) izlaza. Ispis modela, kao u koraku 2, najbrži je način za potvrdu oba broja.
- Kralješnica nikada nije bila smrznuta: Ako je requires_grad ostavljen na True, svaki VGG19 parametar se ažurira i izvođenje se usporava do puzanja na CPU-u. Postavite ga na False prije nego što se klasifikator zamijeni.
- Neusklađenost normalizacije: srednja vrijednost i standardna devijacija korištene u transformacijama. Normaliziranje mora imati iste vrijednosti u vrijeme treniranja i zaključivanja, inače će se predviđanja pomicati bez vidljivog razloga.
- Zastarjeli argument težina: Na torchvisionu 0.13 i novijim verzijama, pretrained=True podiže upozorenje o zastarivanju i preferira se nabrajanje težina.
- broj_radnika uključen Windows i bilježnice: DataLoader s num_workers=4 treba zaštićenu ulaznu točku, pa postavite num_workers=0 ako Python izaziva grešku mrijesta ili kiseljenja.
- Evaluacija u načinu rada za obuku: Pozovite model.eval() prije bodovanja kako bi se Dropout i BatchNorm ponašali deterministički, a nakon toga se vratite natrag s model.train().
